PolicyLens AI:用本地LLM把保险条款变成人话

开源项目 PolicyLens AI 用本地大模型把保险合同拆解为平实摘要并标注免责风险。
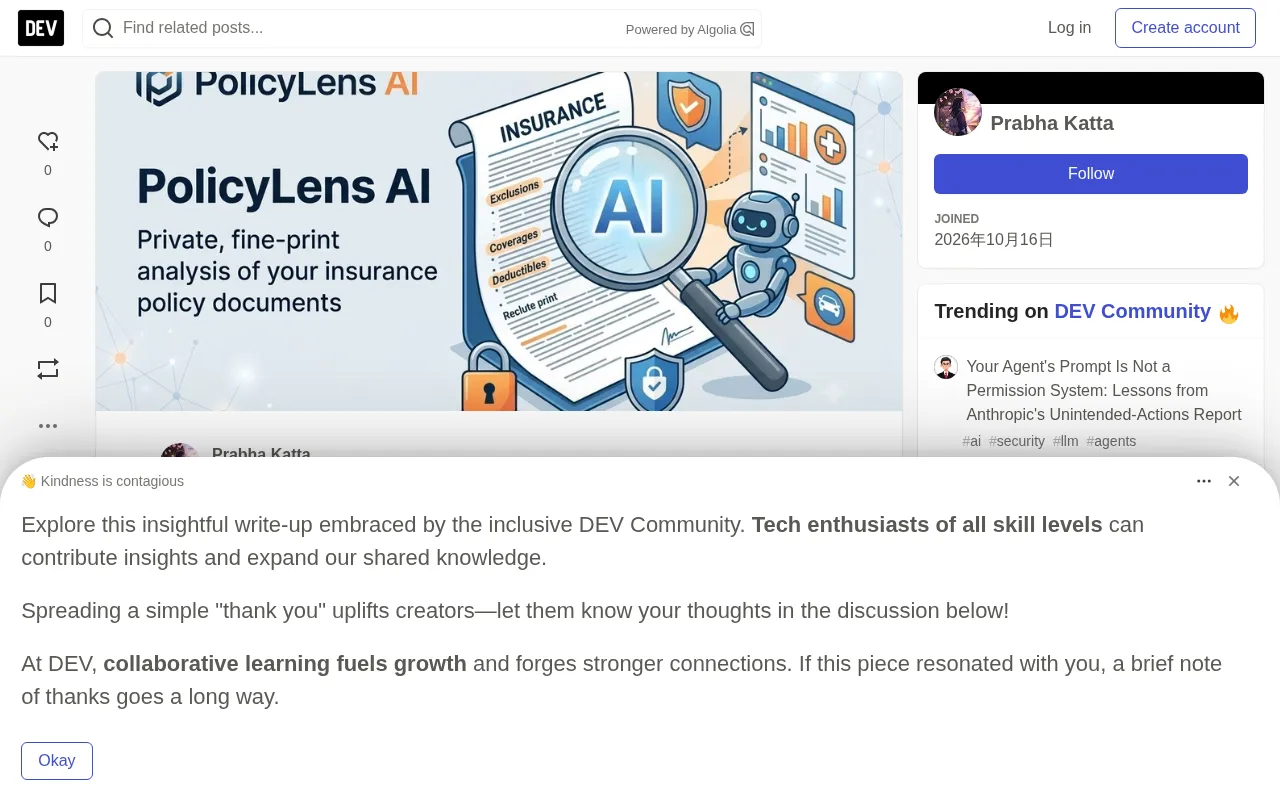
PolicyLens AI 是开发者 Manjusha Pirati 在 Hacktoberfest 开源 AI 挑战赛中提交的项目,针对保险合同冗长晦涩、消费者常低估风险的痛点,用本地大模型将 50 页以上的保单解析为结构化平实摘要。它能提取保额、共付额、免赔额、等待期等关键参数,自动扫描隐藏免责条款与理赔风险点,并提供基于文档的交互式问答。整套系统跑在 Ollama + Gemma 本地后端,敏感健康与财务文档不出本机。项目判断真正愿意付费的是靠读保单吃饭的 B2B 专业人士,如保险经纪、理财师、HR 福利团队与法务理算机构,个人用户按次收费。商业模式覆盖 Freemium、SaaS 订阅与企业本地部署授权,主要挑战在于法律语义的准确解析与长文档上下文处理。
保险合同的「天书条款」一直是消费者的痛点——你以为自己买了全面保障,理赔时才发现一堆免责条款把风险挡在门外。开发者 Manjusha Pirati 在 Hacktoberfest 开源 AI 挑战赛中提交的 PolicyLens AI,正是冲着这个问题来的:用本地大模型把动辄 50 页以上的保险合同拆解成结构化、平实的英文摘要。
它具体做什么
PolicyLens AI 的定位是一个自动化的「细则分析器」,核心能力围绕保险文档的解析与问答展开。
文档提取与参数结构化:用户上传健康险、寿险、车险或财产险的 PDF 保单后,系统会解析出保额上限、共付额(co-pay)、免赔额(deductible)、等待期等关键参数,把散落在合同各处的数字整理成可读的清单。
免责与「红旗」检测:这是它最有价值的功能。系统会自动扫描合同中的隐藏免责条款、附加限制,以及可能导致理赔被拒的风险点——这些恰恰是普通投保人最容易忽略的部分。
交互式问答:提供聊天界面,用户可以直接提问,比如「这份保单覆盖水损吗?」,系统会基于文档内容给出上下文相关的回答,而不是泛泛而谈。
本地数据隐私:整套系统跑在本地 LLM 后端(Ollama + Gemma)上,敏感的财务和健康文档不会离开用户自己的机器。
共付额(co-pay)与免赔额(deductible)的区别:这两个术语经常被混淆,但直接决定实际自付金额。免赔额是投保人在保险开始赔付前必须先自行承担的累计金额,例如免赔额 1000 美元意味着前 1000 美元的合规医疗支出全部自付;共付额则是每次就医或购药时固定的自付比例或固定金额,例如每次门诊自付 20 美元或 20%。两者通常叠加作用:先满足免赔额,再按共付比例分担,同时受保额上限约束。保单解析工具若不能正确区分二者,给出的保障评估可能严重偏差。
它解决的三个真实问题
保单语言的晦涩并非偶然。保险合同普遍用复杂法律术语撰写,消费者容易高估自己的保障范围,直到理赔被拒才意识到问题。
第二个痛点是人工审计耗时。保险经纪人和理财顾问评估一份保单、做横向对比,往往要在 50 多页文档里逐页阅读数小时。
第三个痛点是云端 AI 的隐私顾虑。传统云方案要求把客户机密文档上传到第三方服务器,对金融和医疗行业来说,合规与隐私风险难以回避。PolicyLens AI 选择本地部署路线,直接绕开了这道坎。
云端 AI 的合规背景:金融与医疗行业处理客户文档时,需遵守 GDPR、HIPAA 等数据保护法规。把保单上传到第三方云端 API,可能构成对个人敏感数据的跨境传输或第三方处理,需要签署数据处理协议并承担泄露责任。许多保险经纪与财富管理机构因此直接禁止员工使用公共云 AI 工具。本地部署则让数据始终留在机构自有设备内,既规避合规审批,也避免客户信息被用于模型训练。这也是 PolicyLens AI 在 B2B 场景中比通用云端文档工具更具说服力的原因。
谁愿意为它付费
开发者对商业模式的思考相当清晰,把用户分成 B2B 和 B2C 两类,付费意愿差异明显。
B2B 侧付费意愿最高,包括四类角色:独立保险经纪与代理机构愿意按月订阅,用来快速审阅客户保单、发现保障缺口,并在销售现场生成对比报告;理财规划师和财富管理师需要在不逐页读细则的前提下审计客户的风险敞口;企业 HR 与员工福利团队在评估团体健康险更新或比较多家保险公司的报价时同样有需求;法律与公共理算机构在协助消费者处理被拒赔案时,需要快速定位具体条款和漏洞。
B2C 侧则是个人投保人——想在续保或理赔前做一次「体检」、避免意外自付的普通消费者。这部分通常按次收费,比如每份报告 5 到 10 美元。
商业模式上,开发者设想了三条路径:Freemium 加微交易(首次免费,之后按文档收费)、面向经纪人和理财顾问的 SaaS 订阅(每月 29 到 99 美元,含无限上传、客户报告和导出功能),以及面向有合规要求的区域性保险机构的本地部署企业授权。
技术路线与开源思路
从公开信息看,PolicyLens AI 采用本地 LLM 后端,这是它和多数云端文档分析工具最大的区别。对处理保单这类含大量个人健康与财务信息的场景,本地推理不仅是隐私卖点,也直接影响它能否进入受监管的金融与医疗行业。
项目代码已在 GitHub 开源(manjushapirati030/policylens),作为 Hacktoberfest 开源 AI 挑战赛的参赛作品提交。开发者还专门讨论了「为什么开放创新重要」,这符合 Hacktoberfest 鼓励开源协作的一贯取向。
Ollama 与 Gemma 是什么:Ollama 是一个本地运行开源大语言模型的工具,提供简洁的命令行与 API 接口,用户无需配置复杂的推理环境即可在个人电脑或服务器上加载模型。Gemma 是 Google 发布的开源轻量级模型系列,有 2B、7B 等参数规模,适合在消费级硬件上运行。两者组合意味着 PolicyLens AI 可以在不联网、不调用云端 API 的情况下完成文档解析与问答。代价是模型能力弱于 GPT-4 等云端大模型,尤其在小参数规模下,长文档理解与复杂法律推理容易出现遗漏或误读,这也是文章末尾提到的核心限制之一。
这类工具的机会与限制
把保险条款翻译成人话,需求真实且长期存在。PolicyLens AI 抓住了一个关键判断:真正愿意持续付费的不是普通消费者,而是靠读保单吃饭的专业人士——经纪、理财师、HR、理算员。他们对效率和准确性的敏感度远高于个人用户,也更愿意为工具付费。
不过,保单解析的难点不在提取文本,而在法律语义的准确理解。免责条款的措辞往往精细且互相引用,模型一旦误读,给出的「红旗」提示反而可能误导用户。本地小模型在长文档上的上下文处理能力、以及如何保证摘要不丢失关键限制条件,会是这类工具能否真正落地的核心考验。
对开源社区而言,这个项目的价值在于提供了一个可复用的思路:把本地 LLM 用在隐私敏感、文档密集型、且用户愿意付费的垂直场景里。这个组合值得更多开发者关注。
为什么法律语义解析比文本提取更难:保险合同中的免责条款常使用「除外」「不限于」「以……为限」等限定词,并大量交叉引用其他条款。例如一条免责可能写着「除第 4.2 条另有约定外」,其真实含义取决于被引用条款的内容。通用 OCR 或文本提取只能拿到字面文字,而本地小模型在长上下文里追踪这种引用链时容易断链,把本应提示的风险点漏掉,或把有条件的除外误判为绝对免责。因此,这类工具的输出更适合作为辅助线索,而非最终理赔依据;在实际产品中通常需要人工复核或置信度标注来降低误导风险。
相关推荐
一人量产90集AI漫剧:10小时10块钱的完整制作流程
没有编剧经验也能做AI漫剧:10小时10块钱成本,红果平台单部收益4200元。本文拆解从AI生成剧本、分镜脚本到成片的六步完整流程,附万能提问公式和新手避坑指南。
豆包Agent自制报价测算器:接单报价告别凭感觉
B站UP主用豆包Agent零代码自制报价测算器,输入项目类型、数量、周期即可自动生成报价明细,支持加急与版权买断费率,一键复制发客户,手机端也能随时报价。
WorkBuddy实战教程:10个Agent项目从入门到简历级
WorkBuddy 实战教程解析:用中文交代任务的 AI 工作助手,配置环境比 Codex、Claude Code 更简单。10 个 Agent 实战项目覆盖文件整理、表格汇整、网页生成,新手三步上手,学完可写进简历。