Pony/Illustrious模型姿势提示词攻略:从关键词到LoRA训练
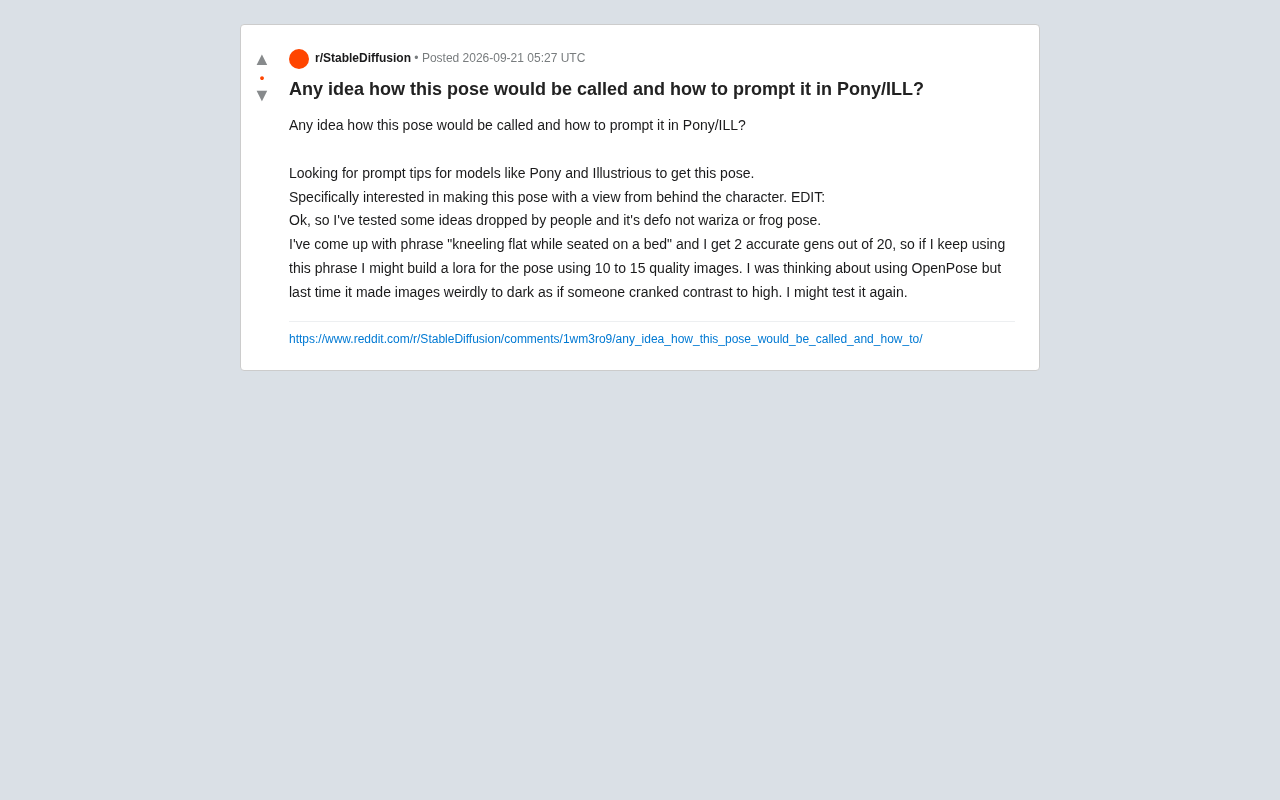
本文梳理了在Pony/ILL模型中精准复现非标准姿势的完整方法链:从标签查找、描述性短语组合、ControlNet避坑到训练专属LoRA。
在使用Pony、Illustrious等二次元Stable Diffusion模型时,复现特定姿势是公认的难点,根本原因在于这类模型的姿势理解高度绑定Danbooru标签体系——有现成标签的姿势命中率高,无标签的姿势则难以稳定生成。文章以一个"从背后视角跪坐"需求为案例,给出了四级递进的实操方案:①先在Danbooru库中查找准确标签;②找不到时用多个描述性短语(如kneeling flat while seated on a bed)与视角标签组合逼近;③引入ControlNet OpenPose约束骨骼,但需将权重控制在0.6-0.8以避免画面偏暗;④若仍不稳定,收集10-15张准确样本训练专属姿势LoRA,形成"生成-筛选-训练"正向循环。文章强调,姿势控制本质是约束博弈,约束越贴合训练数据,输出越可控。
在使用Pony、Illustrious(ILL)等二次元向Stable Diffusion模型时,精准还原特定人物姿势往往是最让人头疼的环节。一位Reddit用户近期发帖求助——如何让模型生成某个特定坐姿,并且要求“从背后视角”呈现。这个看似简单的需求,背后其实涉及提示词工程、姿势命名规范以及ControlNet的取舍等多个实操问题。
为什么姿势提示这么难
Pony和Illustrious这类模型基于大量带标签的二次元图像训练,它们对姿势的理解高度依赖于Danbooru风格的标签体系。也就是说,如果你想要的姿势在训练数据中有对应的常用标签(tag),生成会相当准确;反之,模型就只能“猜测”,成功率骤降。
发帖者最初怀疑目标姿势是wariza(鸭子坐/女孩坐)或frog pose(蛙坐),这两个都是Danbooru中存在的标准坐姿标签。但经过实测后,他确认都不匹配。这恰恰说明了一个常见误区:许多姿势在视觉上相似,但对应的标签完全不同,盲目套用标准标签反而会把生成结果带偏。
Danbooru是全球最大的二次元图像标注数据库,其标签体系(tag system)已积累超过500万张图像和数十万个结构化标签。Pony Diffusion和Illustrious等模型在训练时大量采用了这套标签,因此模型内部的"概念空间"与Danbooru标签高度对齐。具体到姿势类标签,Danbooru维护着一套相当细致的命名规范:wariza(W字形腿跪坐)、seiza(正坐)、indian style(盘腿坐)、sitting(通用坐姿)等都有明确定义,彼此不可混用。这意味着使用者最好在生成前先到Danbooru标签页核查目标姿势的准确英文名,而非凭直觉猜测。Danbooru官网(danbooru.donmai.us)支持按标签搜索图像,可以直观验证某个标签实际对应什么姿势,是调试提示词的重要辅助工具。
从描述性短语入手
当找不到现成标签时,用自然语言描述性短语是一个可行的替代方案。发帖者最终摸索出的表达是 kneeling flat while seated on a bed(在床上跪坐并放平身体),在20次生成中拿到了2张准确结果。
这个命中率(约10%)虽然不高,但对于非标准姿势来说已经是有效信号。它传递出一个重要经验:与其纠结于单一“正确标签”,不如组合多个描述性词汇来逼近目标。比如叠加 kneeling、on bed、from behind 等标签,让模型在多个约束下收敛。
对于“从背后视角”这一需求,Danbooru标签体系里有明确对应词,常用的包括 from behind、ass、back(背部特写)等。将视角标签与姿势标签组合使用,通常比单纯依赖姿势描述更可靠。
用ControlNet OpenPose辅助,但要避坑
当提示词难以稳定复现姿势时,ControlNet的OpenPose模块是业界公认的解决方案。它通过提取骨骼关键点来强制约束生成姿势,理论上能大幅提升还原精度。
不过发帖者提到一个实际踩坑:上次使用OpenPose时,生成图像异常偏暗,“像是有人把对比度拉到了最高”。这是一个相对常见的问题,通常与以下因素有关:
- ControlNet权重(weight)设置过高,压制了模型本身的色彩表现
- 预处理器(preprocessor)与模型版本不匹配
- guidance start/end区间设置不当,导致后期去噪失衡
解决思路通常是把ControlNet权重降到0.6-0.8区间,或调整ending control step让骨骼约束在生成后期退出,把色彩和光影的控制权交还给基础模型。发帖者也表示打算重新测试OpenPose,这个方向值得坚持。
ControlNet是由腾讯ARC实验室于2023年提出的条件控制扩展框架,它通过在UNet结构旁并联一个可训练的副本网络,将额外的结构信息(骨骼、深度图、边缘线等)注入到扩散过程中,而不破坏原始模型权重。OpenPose是其中最常用的姿势控制模式:预处理器(preprocessor)先将参考图或自定义骨架提取为18个关键点的JSON坐标,再由ControlNet模型将这些坐标编码为条件向量。
值得注意的是,ControlNet存在多个版本分支:针对SD 1.5训练的权重文件不能直接用于SDXL架构的Pony/ILL模型,必须使用专门适配SDXL的ControlNet权重(如ControlNet-XL或相应社区移植版)。版本不匹配不仅影响姿势精度,也是导致画面色彩异常(偏暗、对比度失控)的常见根源之一。使用前建议在模型描述页确认其适配的基础架构版本。
终极方案:训练专属姿势LoRA
发帖者提出的最有价值的思路,是用10到15张高质量图像训练一个针对该姿势的LoRA。这是解决“非标准姿势无法稳定复现”问题的根本办法。
当某个姿势既没有现成标签、提示词命中率又低时,专门训练一个小型LoRA能让模型“记住”这个特定姿势。实操要点包括:
- 数据质量优先:10-15张图片不算多,因此每张都要清晰、姿势一致、视角有一定多样性(正面、背面、侧面都有更好)
- 打标要精准:训练时给这些图像统一打上一个触发词(trigger word),并配合描述性标签
- 避免过拟合:样本量小时容易过拟合背景或服装,建议裁剪出干净的姿势主体,或在标签中充分描述可变元素
用他实测出的 kneeling flat while seated on a bed 这类短语作为基础,再筛选出准确的生成结果反哺训练集,形成“生成-筛选-训练”的正向循环,是一条务实的路径。
LoRA(Low-Rank Adaptation)是一种参数高效微调技术,其核心思想是在原始模型权重矩阵旁注入两个低秩矩阵(通常秩为4或8),训练时只更新这两个小矩阵,而冻结原始权重。这使得针对特定概念(如某个姿势、角色或画风)的专项微调仅需数十MB的额外文件,推理时按需叠加,不影响基础模型的通用能力。
对于姿势类LoRA,训练的核心挑战在于让模型将触发词与姿势本身解耦于其他视觉元素(服装、背景、人物外貌)。实践中常用的技巧是在数据集标签里详细标注"非目标"元素,例如具体的服装颜色、背景场景,促使模型将LoRA的激活特征集中在骨骼姿态上。目前主流训练工具包括kohya_ss和OneTrainer,两者均提供图形界面,对非程序员也相对友好。
给同类需求的实操建议
综合这个案例,想在Pony/ILL模型中复现特定姿势,可以按以下优先级尝试:
- 先在Danbooru标签库中查找是否有现成姿势标签
- 找不到时,用多个描述性短语组合逼近,配合视角标签
- 提示词命中率低时,引入ControlNet OpenPose约束骨骼,注意调低权重避免画面异常
- 若以上都不稳定,收集准确样本训练专属LoRA
姿势控制本质上是一场“约束博弈”——你给模型的约束越具体、越贴合训练数据,输出就越可控。对于长期需要某个特定姿势的创作者来说,前期投入训练一个LoRA,远比每次靠碰运气抽卡来得高效。
相关推荐
Cursor Pro 折扣代充服务解析:按量计费模式的真相与风险
解析「Cursor Pro 2.5 折」第三方代充服务的按量计费模式、账号轮循机制与价格测算,并从合规、隐私、余额可持续性等角度剖析用户需警惕的潜在风险。
Cursor入门指南:AI编程工具全景对比与选型
Cursor入门教程与AI编程工具对比:解析什么是AI编程,横向评测Cursor、GitHub Copilot、Windsurf、Trae及国产免费工具,帮你根据功能、成本和使用形态选择合适的AI编程助手。
26k Token就锁死一周?Claude Max 20x套餐的用量困境
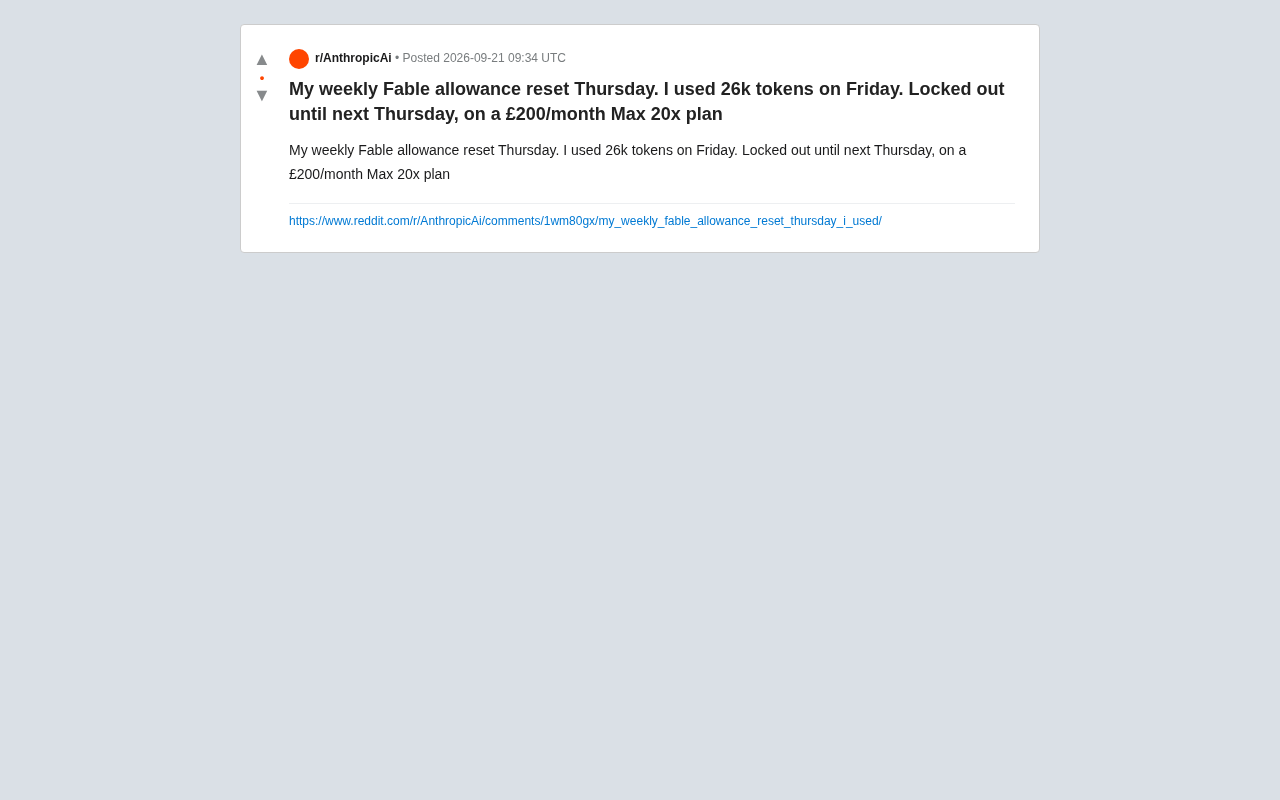
一位£200/月Claude Max 20x套餐用户在Reddit吐槽:周度额度周四重置,周五仅用26k token就被锁定一周。本文剖析AI订阅套餐的用量限制机制与性价比争议,并给出实用建议。