Ponytail 5发布:让AI编程智能体像资深工程师一样克制

Ponytail 5 重构AI编程技能,将智能体目标从「写更少代码」升级为「最小完整变更」,基准测试显示成本降低26%、测试覆盖率显著提升。
开源项目 Ponytail 发布第五版重大重构,核心理念从追求「最小代码量」转向「最小完整变更」——要求 AI 编程智能体在动手前先测绘改动的完整影响范围,包括调用方、测试和潜在破坏点,而非单纯压缩代码行数。两个核心命令也完成升级:review 命令从寻找删减项进化为覆盖 bug、安全、负载的全面审查;audit 命令从罗列问题清单进化为带优先级排序的修复规划。基于 5900+ 次 Claude Code 基准会话的自测数据显示,代码量减少 53%、成本降低 26%,高风险逻辑的测试覆盖率从 68% 提升至 98%。项目以 MIT 许可证开源,但作者坦承数据来自自测,缺乏第三方独立验证。
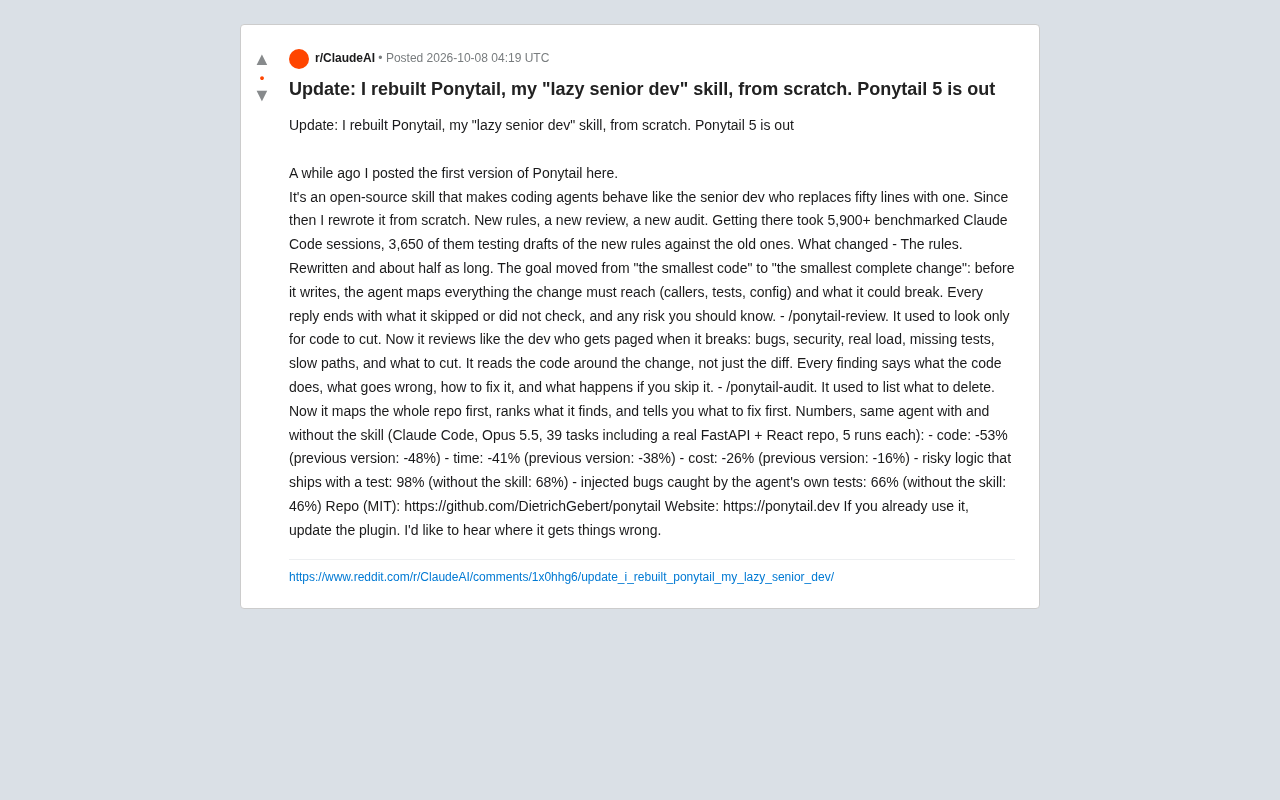
开源项目 Ponytail 迎来重大重构,作者 DietrichGebert 从零重写了这个被他称为"懒惰资深开发者"的编程技能(skill)。它的核心理念很简单:让编码智能体像那位能用一行代码替换五十行的资深工程师一样工作——不是写更多,而是写更少、更稳。
这次更新并非小修小补。据作者介绍,整个重构基于超过 5900 次经过基准测试的 Claude Code 会话,其中 3650 次专门用于将新规则草稿与旧版本进行对照测试。这种以数据驱动的迭代方式,让 Ponytail 5 的改进有了相对可信的量化支撑。
从"最小代码"到"最小完整变更"
Ponytail 5 最本质的转变,是目标函数的调整。旧版本追求的是"最小的代码"(smallest code),而新版本追求"最小的完整变更"(smallest complete change)。
这个区别值得玩味。单纯追求代码量少,容易陷入"为了短而短"的陷阱——删掉的可能是必要的边界处理,省略的可能是关键的测试。而"最小完整变更"要求智能体在动手写代码之前,先绘制出这次改动需要触及的全部范围:调用方(callers)、测试、配置,以及可能被破坏的地方。
更关键的是透明度设计。每次回复结尾,智能体都会主动说明自己跳过了什么、没有检查什么,以及用户应当知晓的任何风险。这种"坦白交代"的机制,恰恰模拟了优秀资深工程师的职业习惯——他们不仅交付代码,还会告诉你哪里埋着雷。规则本身也被重写并精简了约一半长度,印证了作者"用更少做更多"的信条。
"最小完整变更"的理念与软件工程中的"原子提交"(atomic commit)原则高度契合。原子提交要求每次代码提交只做一件事,但必须把这件事做完整——包括相关测试、文档更新和配置变更。Ponytail 5 将这一人工实践规范化为智能体的行为约束:在生成代码之前,先通过静态分析和代码图谱(code graph)追踪变更的传播路径,识别所有调用方(callers)和依赖项,再决定最小必要的改动边界。这与直接要求"写更少代码"的区别在于:后者是输出层面的约束,前者是决策层面的约束——智能体必须先理解影响范围,再选择最经济的实现路径。
两个核心命令的重新设计
Ponytail 5 对两个辅助命令做了彻底改造,让它们从"做减法的工具"升级为"懂全局的审查者"。
/ponytail-review:像被叫起来救火的工程师那样审查
旧版的 review 命令只做一件事:寻找可以删减的代码。新版本的视角完全不同——它像那个"系统崩了会被 call 起来"的开发者一样审查代码,覆盖 bug、安全问题、真实负载、缺失的测试、慢路径,以及可删减项。
一个重要细节是,它读取的是改动周围的代码(the code around the change),而非仅仅是 diff。这意味着审查有了上下文感知能力。每条审查发现都包含四个要素:这段代码做什么、会出什么问题、如何修复、如果不管会发生什么。这种结构化的输出,大大降低了开发者消化审查意见的成本。
/ponytail-audit:先测绘全局再排优先级
Audit 命令同样经历了从"列清单"到"做规划"的进化。旧版本只是列出哪些内容该删除,新版本则会先对整个代码仓库进行测绘,对发现的问题排序,然后明确告诉你应该优先修复什么。
从"告诉你有什么问题"到"告诉你先修哪个",这是工具实用性的质变。面对一个积累了技术债的真实项目,优先级排序往往比问题清单本身更有价值。
基准数据:改进实实在在
作者给出了同一智能体在使用与不使用该技能时的对比数据。测试环境为 Claude Code 搭配 Opus 5.5,共 39 个任务(包含一个真实的 FastAPI + React 仓库),每个任务运行 5 次。
| 指标 | Ponytail 5 | 上一版本 |
|---|---|---|
| 代码量 | -53% | -48% |
| 耗时 | -41% | -38% |
| 成本 | -26% | -16% |
除了效率指标,质量维度的提升更引人注目:带测试上线的高风险逻辑比例达到 98%(不使用技能时为 68%);智能体自身测试捕获注入 bug 的比例为 66%(不使用技能时为 46%)。
成本从 -16% 跃升到 -26% 的改进尤其明显,几乎翻倍。这说明新规则在精简代码的同时,也显著减少了 token 消耗和返工。不过需要客观看待:这些数据来自作者自测,样本任务量有限,缺乏第三方独立验证,实际效果仍需用户在各自场景中检验。
表格中的"代码量"减少指标,通常以行数(lines of code, LoC)或 token 数为衡量单位。在 AI 编程场景中,代码量减少与成本降低并非线性关系——因为上下文窗口(context window)中携带的历史代码、注释和测试文件同样消耗 token。Ponytail 5 成本降幅从 -16% 跃升至 -26%,可能部分归因于更精准的变更范围划定减少了需要传入上下文的无关代码,而非单纯的输出行数压缩。"耗时"指标则同时受到 API 延迟、token 生成速度和多轮对话次数的影响,规则约束减少了智能体的探索性尝试和返工循环,是耗时下降的主要机制。
开源与社区反馈
Ponytail 采用 MIT 许可证开源,代码托管在 GitHub(DietrichGebert/ponytail),并有独立网站 ponytail.dev。已经在使用的用户只需更新插件即可获得新版本。
作者在发布时特意提出,希望听到"它哪里出错了"的反馈。这种主动征集负面意见的态度,对一个依赖规则调优的工具项目而言是健康的——边界情况和失败案例往往是下一轮迭代的最佳素材。
对于正在探索如何约束 AI 编程智能体行为的开发者,Ponytail 提供了一个值得参考的思路:与其让智能体自由发挥、再事后收拾残局,不如用一套精心设计的规则,把资深工程师的克制与审慎前置到生成过程中。
"编程技能"(skill)在 Claude Code 语境中,是指通过自定义系统提示(system prompt)或规则文件注入到智能体工作流中的行为规范集合。与通用的提示词工程不同,skill 通常以结构化文档形式存在,可以被版本管理、测试和分发——这正是 Ponytail 作为独立开源项目存在的技术基础。Claude Code 原生支持通过 CLAUDE.md 文件或 slash command 加载自定义规则,Ponytail 利用这一机制,将资深工程师的决策模式编码为可复用的约束层,使不同用户、不同项目都能获得一致的智能体行为基线。
相关推荐

AI自动化变现实录:一名医生的技能转型故事
一名尼日利亚医生分享从医学转向AI自动化变现的经历,内容涉及AI自动化技能构成、收入叙事与课程推广。本文冷静拆解其可信度边界,并为想入门AI自动化的读者提供实用建议。
用n8n搭建WhatsApp智能线索自动化:AI分级让商机不再流失
拆解一个基于n8n的WhatsApp线索自动化工作流:用AI把客户消息分为hot/warm/cold四级,自动应答并评分,仅在高价值线索出现时通知老板,帮助中小企业高效管理商机、节省人力。

Arabagent.ai:面向中东市场的托管式N8N自动化方案
Arabagent.ai 面向中东市场提供托管式 N8N 自动化服务,含私有工作空间、无限工作流执行、AI 自愈架构及阿拉伯语双语支持,兼顾开源可控性与 SaaS 便捷。