PostgreSQL混合搜索实战:BM25+向量检索一次打通

在 PostgreSQL 内融合 BM25 与向量检索,用 RRF 合并结果,实现事务一致的混合搜索。
本文介绍了在 PostgreSQL 中直接构建混合搜索系统的务实方案。针对关键词检索与语义检索各自的短板,作者使用 pgTextSearch 提供 BM25 排序、pgVector 与 pgVectorScale 提供向量检索,并通过倒数排名融合(RRF)合并两路结果。文章强调了匹配与排序的分离、BM25 负分排序的特性、语义检索的覆盖限制,以及 RRF 按排名而非分数加权的优势。通过实测对比,展示了混合模式在具体查询中的表现,并讨论了方案的适用边界与性能考量,核心主张是当数据已存储在 PostgreSQL 中时,将搜索也留在数据库内可降低一致性成本。
在应用里做搜索,最常见的困境是:数据库里明明有文章,搜索结果却总差一口气。用户搜「会自己发光的动物」,关键词匹配可能一无所获,因为文章里写的是「生物发光」。反过来,语义搜索又可能把「阿波罗13号」搜成别的太空任务。单一检索方式各有短板,而 freeCodeCamp 的 Beau Carnes 在最新课程中演示了一条务实的路线:不引入第二套搜索系统,直接在 PostgreSQL 里把关键词检索(BM25)和向量检索拼起来,再用倒数排名融合(RRF)合并两路结果。
为什么把搜索留在数据库里
课程先摆出一个真实场景:应用的文章已经存在 Postgres 中,团队为了更好的排序接入了独立的搜索服务。从此每次文章变更都要同步复制到第二个系统,副本延迟、删除事件丢失、重建索引期间用户看到旧版本,都成了新的故障源。
作者的选择是把搜索索引和文章放在同一个库里,好处是数据与其索引共享一个事务边界,搜索还能和已有的关系型查询自由组合。这不是说专用搜索引擎没有价值,而是提醒我们:当数据规模在单库可控范围内时,多一套系统就是多一份一致性成本。
据课程介绍,示例项目 WikiSearch 的关键词索引覆盖约 24.2 万篇 Simple English Wikipedia 文章,语义搜索只覆盖约 2.5 万篇,以控制嵌入计算量。界面会同时显示两个数量,这个差异在对比结果时很关键。技术栈是 pgTextSearch(提供 BM25 排序)加 pgVector 与 pgVectorScale(语义检索),可跑在 Tiger Cloud 上,也可按仓库说明在本地部署,pgTextSearch 本身是 PostgreSQL 许可证下的开源扩展。
BM25 是信息检索领域经典的排序函数,属于概率模型的一种。它基于三个核心要素计算相关性:词频(TF,词在文档中出现的次数)、逆文档频率(IDF,词在整个语料库中的稀有程度)以及文档长度归一化。IDF 的作用是降低常见词的权重(如“的”、“是”),提升罕见词的权重;文档长度归一化则避免长文档因词数多而获得不公平的优势。BM25 有两个可调参数:k1 控制词频饱和速度(默认 1.2),b 控制文档长度归一化的强度(默认 0.75)。与 PostgreSQL 内置的 ts_rank 不同,BM25 需要全局统计信息(文档频率、平均文档长度),因此通常需要专门的索引结构支持。
匹配与排序是两件事
课程反复强调一个容易被忽略的区分:Matching 决定哪些文档有资格进入结果,Ranking 决定它们谁排前面。
PostgreSQL 内置的全文检索就能说明问题。作者用 to_tsquery 构造查询,& 表示所有词都必须出现。搜「volcano eruption ash cloud aviation」时返回零结果,因为没有文章同时包含这五个词。换成 |(或)之后,结果立刻出现,再由 ts_rank 排序。检索允许谁进来和谁先展示,是两个可以独立调整的旋钮。
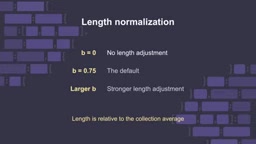
内置方案的天花板在于排序。ts_rank 缺少全库文档频率统计,无法区分一个到处都是的词和一个只指向窄主题的词。BM25 补的正是这块:词在越少文档中出现,证据力越强;重复出现有帮助但边际递减(k1 参数控制饱和速度,默认 1.2);文档长度要归一化(b 参数默认 0.75)。三项合起来,才让「罕见词命中」真正拉高分数。
BM25 落地:负分排序与索引扫描
在 pgTextSearch 中建 BM25 索引只需一条 DDL,指定表、列和文本配置。查询写法值得注意:操作符是 <@> 而不是 @@,且扩展返回的是 BM25 分数的负值。因此最强的匹配是最负的数字,排序要用升序;这和前面 ts_rank 的降序逻辑正好相反。作者特意提醒,在两种方法间切换时务必检查排序方向。
执行计划对比更能说明架构差异。内置检索的计划里有一个独立的 Sort 步骤,先找出匹配再排序;BM25 索引扫描则直接按相关度顺序返回行,没有额外排序。课程中的计时显示原生查询约 0.3 毫秒、BM25 约 9 毫秒,但作者明确表示这不代表谁更快——前者返回零行,后者返回 10 行,做的是不同的工作。这种对基准数字的谨慎态度贯穿全片。
索引内部使用倒排结构与 block-max WAND 优化,可以跳过无法改进当前结果的倒排块。这也是为什么「有序分数 + LIMIT」的组合尤其重要:我们是在向索引要一小批强候选,而不是把所有匹配都算一遍再截断。
语义检索:向量列与近似索引
语义检索的第一步是把文本变成数字。课程使用本地模型为每篇文章生成 384 维向量,只取标题加正文前 1500 个字符——这意味着它检索的是「文章开头表达的意思」,深埋在长文末尾的概念可能被漏掉。这是设计上的取舍,不是缺陷。
对应地,库里给文章表加一列向量字段,再用 pgVectorScale 建向量索引。查询时比较距离,越小的距离越靠前。由于使用近似搜索,索引可能漏掉部分真正的最近邻;而语义上「接近」不等于「正确」,搜一个太空任务可能返回另一个任务。嵌入任务按批次写入,失败后重跑会从断点继续,脚本还会校验文件校验和,保证课程可复现。
向量检索通常使用近似最近邻(ANN)算法来加速,常见的有 HNSW(分层可导航小世界图)和 IVFFlat(倒排文件加扁平量化)。这些索引通过牺牲少量召回率来换取查询速度的大幅提升,因此可能漏掉部分真正的最近邻。pgVector 是 PostgreSQL 的向量扩展,支持向量存储、距离计算(如余弦距离、欧氏距离)以及 ANN 索引。pgVectorScale 则是在 pgVector 基础上提供额外的扩展功能,例如用于批量嵌入和索引管理的工具。在语义检索中,文本通过嵌入模型转换为稠密向量,相似度通常用余弦距离或内积衡量;距离越小表示语义越接近。由于嵌入模型只捕捉文本的语义信息,不涉及关键词匹配,因此可能返回语义相关但字面不匹配的结果(如将“阿波罗13号”匹配到其他太空任务)。
融合:RRF 不做分数加法
两路结果分数体系不同,BM25 分数和向量距离不能直接相加。课程采用 Reciprocal Rank Fusion(RRF):只看每篇文章在各列表中的位置,用 1/(60+排名) 计分。同一篇文章在两路都出现就获得两份贡献。
实际操作是每种方法各取 20 个候选,合并后按文章 ID 聚合、累加得分,取前 10。课程中的执行计划显示:关键词 20 行、向量 20 行、聚合后 40 条记录去重为 32 篇,即有 8 篇同时被两种方法找到。这些双命中文章天然占据优势,这正是 RRF 的意图——共识比单路的高排位更可信。
应用通过 semantic_weight 参数调节两路权重,0 表示纯关键词,1 表示纯语义,中间值按比例分配。课程建议每次只改一个变量,重复同一组查询,观察哪些结果上升或下降。
倒数排名融合(Reciprocal Rank Fusion,RRF)是一种无参数的融合方法,常用于合并多个检索系统的结果。其核心思想是:不直接比较不同系统的分数(因为尺度和分布可能完全不同),而是仅利用每个文档在各自结果列表中的排名。对于每个文档,RRF 分数为所有列表中 1/(k + rank) 之和,其中 k 是平滑常数(通常取 60),rank 是文档在列表中的位置(从 1 开始)。k 值的作用是削弱排名靠前文档的绝对优势,使分数变化更平滑。RRF 的优势在于简单、无需训练、对异常分数鲁棒,并且天然倾向于奖励在多个列表中同时出现的文档(即“共识”)。在混合检索中,RRF 能有效平衡关键词检索和语义检索的贡献,避免因某一路分数尺度较大而主导最终排序。
实测:三种模式的真实差异
课程设定了三条固定的测试查询:一条具体的「Apollo 13」、一条描述性但不用原词的「animals that make their own light」、一条多词组合的「volcano eruption ash cloud aviation」。
在阿波罗13号的例子中,关键词模式直接把它顶到第一,语义模式让相关话题分散到其他太空任务上,混合模式下阿波罗13号位置上升,同时保留了部分语义相关的周边结果。作者给出的判断是混合结果整体最佳,但坦率承认一个比较上的硬伤:关键词覆盖全库,语义只覆盖嵌入过的那 2.5 万篇,没有向量的文章连参加融合的资格都没有。要做公平对比,得先把整个集合都嵌入。
演示插入功能也验证了这个流程:新文章先由应用生成向量,再与文本在同一事务中写入数据库。事务保证要么全部成功、要么全部回滚,不会出现有文本没向量的半成品记录。插入后,三种模式都能检索到它。
适用边界与已知限制
课程末尾给出了几个明确的边界。拼写容错不在当前方案内,需要额外处理;如要扩大语义覆盖,只能增加嵌入文章数;把长文切分成小块再嵌入,可以让检索触达开头之外的内容;再进一步可以引入 re-ranker 对前若干结果重新排序。
性能方面,作者引用了 Tiger Data 一项使用约 1.38 亿段落的厂商基准,对比 pgTextSearch 1.0 与 ParadeDB 0.21.6:数据已缓存时 pgTextSearch 短查询更快、并发更高,而 ParadeDB 建索引快约一倍。原文明确标注这是厂商自测,且测的是旧版本,不能直接套用到课程使用的 1.5.1 上,只宜作背景参考。
整套方案的核心主张其实很朴素:当你的数据已经住在 PostgreSQL 里,搜索也可以住在那里。用一条 SQL 完成匹配、排序和融合,用事务保证数据与索引一致,代价是放弃了一些专用搜索引擎的高级能力。是否值得,取决于你的用户到底卡在哪一步——是拼写错误,还是根本不知道那个词。
相关推荐

Gemini 4 Argon API实战:思考等级、后台模式一次讲透
Free Code Camp 出品的 Gemini 4 Argon API 速成教程:从申请密钥、发送首次请求,到用思考等级控制推理成本、用 previous_interaction_id 实现多轮对话,再到后台模式一句话生成打砖块游戏,附 Google 工程师对模型能力的解读。

强化学习通关《抡大锤》:63%进度背后的分布式训练策略
开发者用深度强化学习挑战《抡大锤》,智能体从底部攀爬至63%进度,卡在铁砧部分。项目开源,采用分治训练和CPU训练策略,寻求社区协作突破瓶颈。

AAAI 2027二审放榜在即:社区热议评审公平与投稿生态
AAAI 2027第二阶段评审结果即将公布,Reddit社区热议评审一致性与流程透明度。本文梳理放榜前的社区情绪、顶会评审的结构性矛盾,以及作者应对二审结果的务实策略。