POV视角生成:AI图像模型的新能力与开源难题
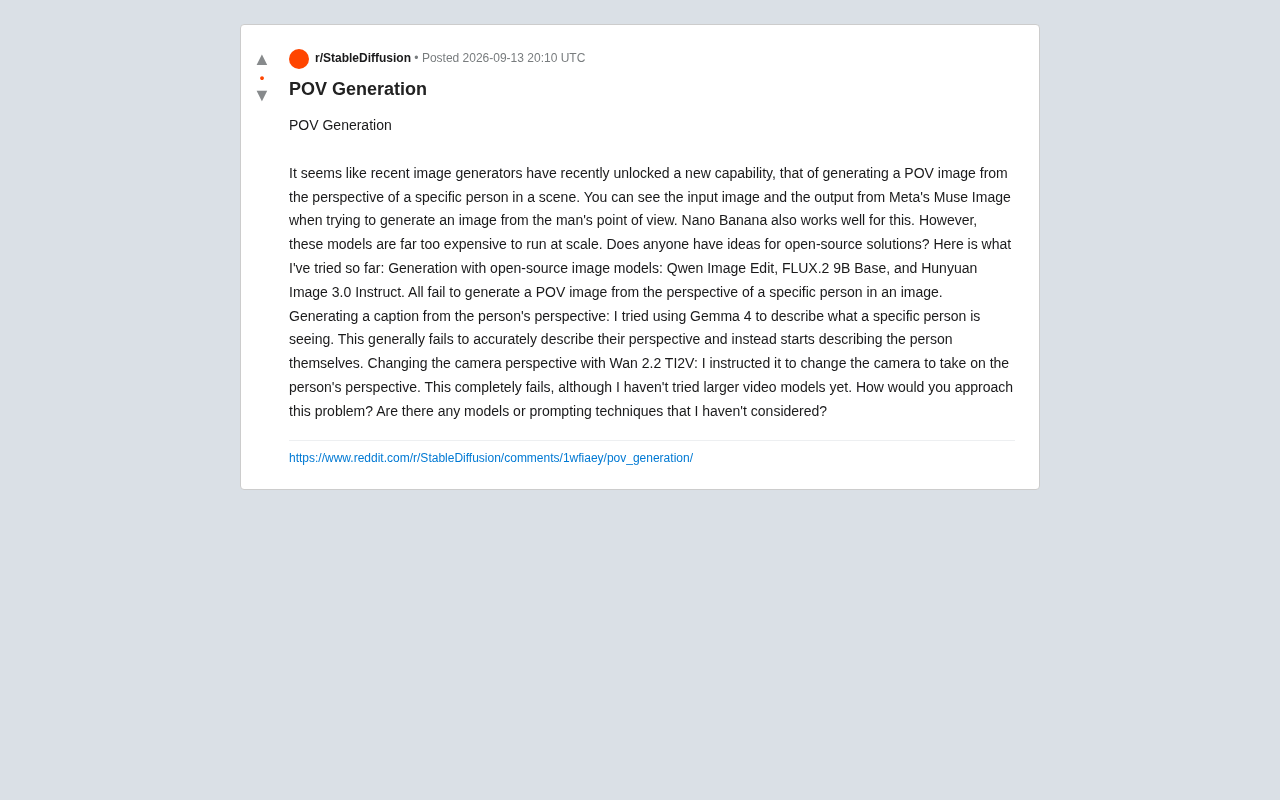
POV视角生成是空间推理新挑战,商业模型已跑通但成本高,开源方案三条路径均告失败。
POV视角生成指从场景中特定人物的第一视角重构画面,本质上是一项隐式三维空间推理任务,要求模型定位人物位置、推断朝向并重建其视野。Meta Muse Image与Nano Banana等商业闭源模型已证明具备这一能力,但高昂的推理成本阻碍了规模化部署。一位开发者系统测试了三条开源替代路径——直接调用Qwen Image Edit等主流开源图像模型、借助Gemma生成中间文字描述再转图像、以及用视频模型Wan 2.2 TI2V切换镜头——结果全部失败。根本原因在于通用开源模型缺乏针对视角变换的专项训练。文章进一步指出,引入NeRF或3D Gaussian Splatting等显式几何重建、精细提示工程、以及基于多视角配对数据的LoRA微调,是当前最值得社区探索的方向。
什么是POV视角生成
近期图像生成模型解锁了一项颇具想象力的新能力:从场景中特定人物的视角(Point of View, POV)重新生成一张图像。简单来说,输入一张包含多个人物的场景照片,模型能够输出「如果站在画面中某个人的位置往外看,会看到什么」的画面。
这一能力与传统的图像编辑截然不同。它要求模型不仅理解画面内容,还要具备空间推理能力——判断目标人物在场景中的位置、朝向,进而推断出其视野内应当出现的物体、人物和背景。这实际上是一种隐含的三维场景重建与视角变换任务。
据Reddit社区一位开发者的实测分享,Meta 的 Muse Image 在处理这类任务时表现出色。给定一张包含一名男子的场景图,模型能够生成从这名男子视角出发的画面。此外,业界广受关注的 Nano Banana 同样在该任务上表现良好。
商业模型能做,但代价高昂
目前能够稳定完成 POV 生成的,主要集中在少数几款闭源商业模型上。Meta Muse Image 和 Nano Banana 都被证实具备这一能力,但问题也随之而来——这些模型的推理成本过于高昂,难以规模化部署。
对于希望将 POV 生成集成到产品中、或需要批量处理大量图像的开发者而言,逐张调用昂贵的商业 API 显然不是可持续的方案。这也正是该开发者转向开源替代方案的核心动机:能否用可自建、可控成本的开源模型复现相似效果?
开源方案的三次尝试与失败
这位开发者系统性地测试了三条技术路径,结果都不尽如人意,值得后来者参考。
路径一:直接用开源图像编辑模型
他尝试了当前较为主流的几款开源图像模型,包括 Qwen Image Edit、FLUX.2 9B Base 以及 Hunyuan Image 3.0 Instruct。这些模型在常规图像编辑任务上都有不错的口碑,但在 POV 生成这一特定任务上全部失败——它们无法从图中特定人物的视角生成对应画面。
这说明当前开源图像模型的训练目标里,缺乏对「视角变换」这类空间推理任务的针对性优化。它们擅长局部编辑、风格迁移、内容替换,却难以完成这种需要理解场景几何关系的高阶任务。
路径二:先生成人物视角的文字描述
第二条思路是分步走:先用语言模型描述「这个人正在看到什么」,再把描述喂给图像生成模型。他使用了 Gemma 模型来完成描述环节。
结果是,模型往往跑偏去描述这个人本身的样貌,而非其视野中的内容。这暴露了多模态模型的一个常见短板:在指代消解和视角切换上,模型容易混淆「描述对象」与「对象所见」,无法准确站在第三方立场进行空间想象。
路径三:用视频模型改变镜头视角
第三条路径借助视频生成模型 Wan 2.2 TI2V,通过指令让镜头切换到目标人物的视角。这次尝试也完全失败了。不过开发者也坦言,他尚未测试更大规模的视频模型,这条路径是否彻底走不通仍有待验证。
Wan 2.2 TI2V(Text-Image to Video)是一类以图像加文字为输入、生成连续视频帧的多模态生成模型。TI2V 范式的核心优势在于:视频模型在训练时天然接触到大量镜头运动序列,因此对「摄像机从 A 点移动到 B 点」这类视角变换有一定的先验知识。然而,「镜头平移/推拉」与「完全切换到另一个人物的第一视角」在任务复杂度上存在本质差异——前者是连续的摄像机运动,后者要求模型理解场景中另一个主体的具体空间位置与朝向,并重建其单目视野,这对视频模型的空间推理能力提出了更高要求。这也解释了为何即便视频模型具备一定的视角先验,在 POV 精确切换上仍然失败。
问题的技术本质
综合三次失败,POV 生成的难点其实是空间几何理解与视角变换能力的缺失。这个任务隐含地要求模型:
- 定位目标人物在场景中的三维位置
- 推断其头部/身体朝向,从而确定视野方向
- 重建被人物身体遮挡、原图中不可见的场景内容
- 保持场景中其他元素的空间一致性
闭源模型(如 Muse Image、Nano Banana)之所以能做到,很可能是因为它们在训练数据和目标设计上包含了大量多视角、三维一致性的样本。而通用开源模型缺乏这类专门训练,自然难以泛化到该任务。
NeRF(Neural Radiance Field,神经辐射场)与 3D Gaussian Splatting 是当前最主流的两类隐式三维场景重建方法。NeRF 通过训练一个神经网络,将空间坐标与视角方向映射为颜色和体积密度,从而实现任意新视角的渲染,但其训练与推理速度相对较慢。3D Gaussian Splatting 则用数百万个带有位置、颜色、不透明度属性的三维高斯椭球表示场景,渲染速度大幅提升,近年来成为新视角合成的主流替代方案。这两类方法的核心优势在于:它们将「场景几何」与「外观」分离建模,使得从任意指定位置和朝向渲染新视角成为一个确定性的几何操作,而非依赖模型的隐式空间想象。将此类方法引入 POV 生成流水线,理论上能规避端到端生成模型在空间一致性上的根本短板。
可能的探索方向
虽然原帖尚未找到成熟的开源答案,但结合任务特性,几个方向或许值得社区继续探索:
引入显式三维中间表示:先用单目深度估计或场景重建模型(如 NeRF、3D Gaussian Splatting 类方法)恢复场景几何,再从目标人物位置渲染新视角,最后用图像模型做细节补全。这种「先几何、后生成」的流水线可能比端到端方案更可控。
更精细的提示工程:在文字描述环节,通过结构化提示明确要求模型「不要描述这个人,只描述他眼前的物体、方位和距离」,或许能改善 Gemma 类模型跑偏的问题。
测试更大的视频模型:视频模型天然带有镜头运动和视角连续变换的先验,更大参数量的视频模型可能在镜头视角切换上表现更好,这是原帖作者也认可的待验证方向。
任务专项微调:如果有足够的多视角配对数据,对开源图像编辑模型做 LoRA 或全参微调,专门训练视角变换能力,可能是最直接有效的路线。
LoRA(Low-Rank Adaptation)是一种参数高效微调方法,其原理是在预训练模型的权重矩阵旁注入低秩分解矩阵,只训练这部分新增参数(通常仅占原模型参数量的 0.1%–1%),从而以极低的计算成本将大模型适配到特定任务。对于 POV 视角变换这类需要专项能力的任务,LoRA 微调的可行性高度依赖训练数据的质量与数量:理想的配对数据应包含「同一场景下不同人物视角的图像对」,例如通过 3D 游戏引擎、合成数据管线或多摄像头采集系统构建。若此类数据难以获取,也可考虑先用合成场景(如 Blender 渲染的室内外环境)生成大规模视角对数据进行预训练,再在真实图像上做少量微调,这是当前多视角生成研究中常见的数据构建策略。
结语
POV 生成代表了图像生成从「二维内容操作」向「三维空间理解」演进的一个缩影。目前商业模型已经跑通,但成本高企;开源生态则还在摸索阶段,主流模型尚无法直接胜任。对于关注生成式 AI 前沿的开发者,这既是一个尚未被填补的空白,也是一个值得投入的技术机会。
相关推荐
小镇终止Flock合同后:AI车牌识别摄像头的余波与隐忧
美国多地政府因公众抗议取消与Flock的AI车牌识别摄像头合约,但终止合同并不意味着摄像头立即拆除或已采集数据被删除。本文分析ALPR监控技术退出潮背后的数据留存隐忧与治理难题。
Hacker News「你在做什么」月度讨论:社区创作生态观察
Hacker News 月度经典帖「Ask HN: What are you working on?」获 180 赞、558 条评论。本文解析这一社区传统的运作逻辑、互动价值及其对技术趋势观察的参考意义。
OpenArch:用PyTorch复现现代大模型架构的开源项目
OpenArch 是一个用 PyTorch 复现现代大语言模型架构的开源项目,专注于清晰可读的架构实现。本文分析其项目定位、适用人群以及这类 LLM 架构复现工具的价值与风险。