PPO并行训练机器人:如何扩展至千级智能体?

PPO扩展并行环境时需同步缩放批大小、缓冲区、学习率与时间视野,否则训练崩溃。
文章针对ML-Agents训练四足机器人时并行环境从10扩到1000导致训练崩溃的问题,指出核心矛盾并非硬件瓶颈,而是数据分布与策略更新节奏失配。PPO作为on-policy算法,其buffer_size决定了每次更新使用的经验总量;并行环境剧增而超参数不变时,每个环境贡献的轨迹被严重稀释,优势估计偏差增大、价值网络难以学习长程依赖。同时,learning_rate、num_epoch等超参数在样本量激增时存在隐式耦合,导致单次更新对策略改动过大。文章给出缩放原则:batch_size至少按环境数比例线性增加,buffer_size保持为batch_size的5-10倍;学习率可采用保守不调或平方根缩放;time_horizon适度减小;网络容量可能需增大。最后强调分阶段验证,先扩到500-1000跑通稳定训练再逼近上限。
在强化学习(RL)的实际应用中,训练速度往往是比算法设计更令人头疼的问题。Reddit上一位开发者就遇到了这样的困境:使用ML-Agents和Unity训练四足机器人,10个并行环境时效果很好,但等待3小时才能看到结果。当他尝试将并行机器人数量增加到100甚至1000时,训练曲线反而崩溃了。他的硬件理论上能支持10000个机器人同时训练,却不知道该如何调整超参数。
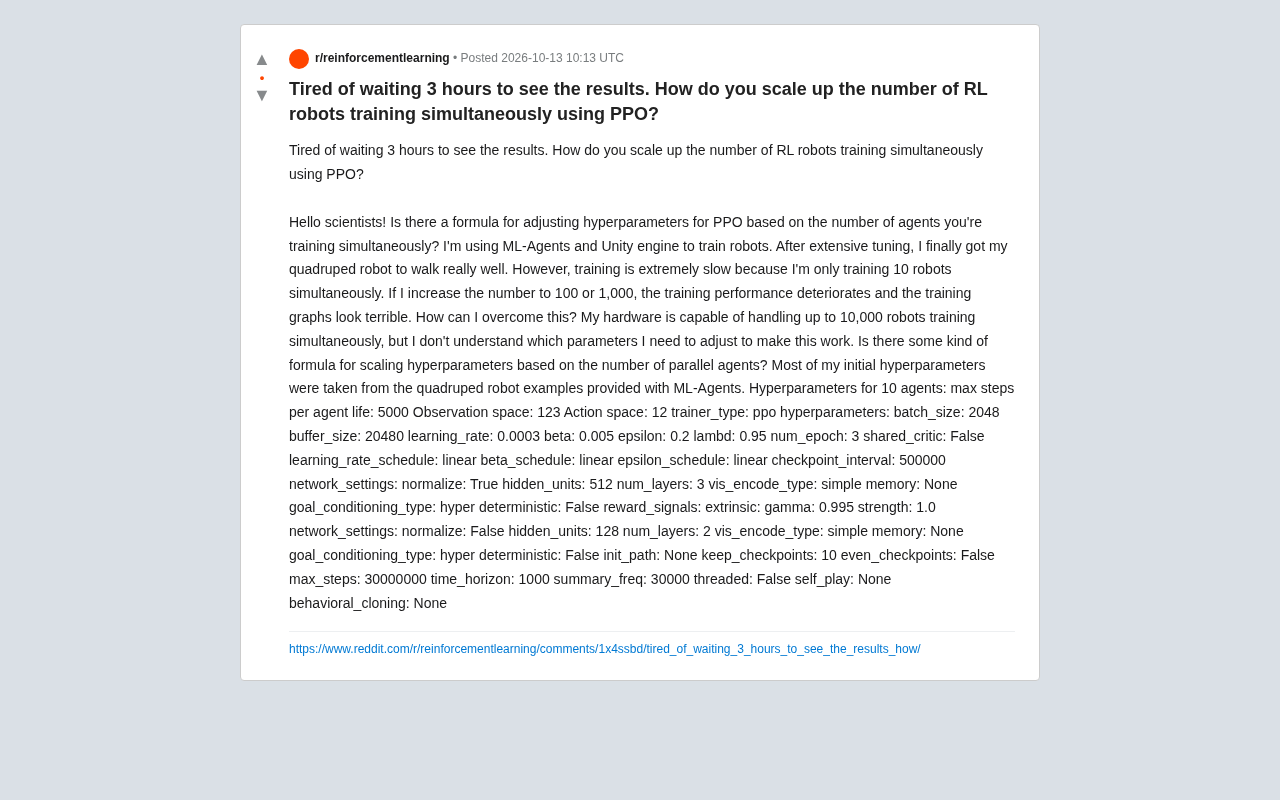
这个问题在机器人仿真训练中非常典型。核心矛盾在于:增加并行环境数量不等于简单地按比例放大 batch_size 或 buffer_size。PPO算法的稳定性依赖于经验数据的相关性和策略更新的步调一致性。当环境数量剧增时,梯度估计的方差、奖励信号的稀疏性以及网络更新的频率都会发生质变。
并行环境扩展为何导致性能崩溃?
PPO的数据收集机制被打破
PPO是一种在线策略(on-policy)算法,它要求每次更新使用的数据必须来自当前策略。在ML-Agents中,buffer_size 决定了每次更新前收集多少经验。当只有10个环境时,每个环境贡献的轨迹相对完整;当环境数扩大到1000时,同样的 buffer_size 意味着每个环境只贡献极短的片段。这会导致两个问题:一是优势函数估计的偏差增大,因为轨迹被截断;二是价值网络难以学习到长程依赖,因为每个环境的时间视野被稀释。
关于 on-policy 与 buffer_size 的关系:在 ML-Agents 中,buffer_size 对应 PPO 在两次策略更新之间收集的总经验步数(约等于 num_envs × time_horizon)。由于 PPO 是 on-policy 算法,这批数据在完成 num_epoch 次梯度更新后即被丢弃,下一轮必须用最新策略重新采样,因此 buffer 越大并不代表数据可以反复利用,而是单次更新消耗的样本更多。当环境数从 10 扩到 1000,如果 buffer_size 不变,分摊到每个环境的轨迹长度会被压缩到原来的 1/100,极端情况下单个环境可能只贡献几个时间步,轨迹在时间上被严重截断。这直接破坏了优势函数(GAE)对回报的估计——GAE 依赖连续的时序差分残差累加,轨迹越短 bootstrap 偏差越大;同时价值网络也需要足够长的时间视野才能学到状态值与长期回报的对应关系。因此,扩展并行数时同步放大 buffer_size 的本质目的,是保证每个环境仍能贡献一段长度可用的连续轨迹,而非单纯为了“数据更多”。
超参数存在隐式耦合
原始配置中,time_horizon: 1000 和 max_steps: 5000 是为少量智能体设计的。当并行数增加,每个智能体在每轮更新中实际经历的时间步大幅缩短。如果继续沿用 summary_freq: 30000,你会在训练早期看到极不稳定的奖励曲线。更关键的是,learning_rate: 0.0003 和 num_epoch: 3 的组合在大量环境并行时会导致每次更新对策略的改动过大——因为总样本量激增,同样的学习率下梯度更新的有效步长变相放大。
关于 PPO 中 learning_rate、batch_size 与更新幅度的耦合:PPO 的稳定性来自“小步更新”约束,其数学形式由 clip 目标和学习率共同决定。一次梯度更新的有效步长可以粗略看作 learning_rate × (梯度估计的方差)。当 batch_size 随环境数线性放大时,梯度估计的方差会以约 1/batch_size 的速率下降,即梯度方向更准但单步幅度并未自动变化;然而在固定 learning_rate 下,由于每轮更新用的样本更多、epoch 次数不变,策略在单次迭代中被推向新分布的总位移反而可能增大,表现为训练早期奖励剧烈震荡甚至坍塌。这正是 num_epoch: 3 在大量环境并行时显得危险的原因:同一批数据被反复使用 3 次,若这批数据规模激增,则每次 epoch 都在把策略推得更远。实践中常用的缓解手段包括按 sqrt 比例降低学习率、启用学习率线性衰减,或使用自适应优化器(如 Adam)的梯度裁剪,把单步更新幅度控制在与策略分布变化相匹配的范围内。
超参数缩放的经验公式与策略
虽然没有官方给出的精确公式,但社区实践中总结出了一些缩放原则。核心思想是:保持每次梯度更新的有效样本量与策略更新幅度之间的平衡。
线性缩放 batch_size 与 buffer_size
最直接的经验是:当并行环境数从 N 增加到 M 时,batch_size 应至少按 M/N 的比例线性增加。例如从10个环境扩展到1000个,batch_size 应从2048增加到约204800。同时 buffer_size 应保持为 batch_size 的5-10倍,以维持PPO的clip机制有效。但要注意,过大的batch_size会降低样本效率,因此建议分阶段扩展:先扩到100个环境,再逐步到500、1000。
调整学习率与更新轮次
学习率的缩放存在争议。一种保守做法是保持学习率不变,但增加 num_epoch 或使用更大的batch_size来稳定梯度。另一种做法是采用平方根缩放:学习率乘以 sqrt(M/N)。例如从10到1000,学习率调整为 0.0003 * sqrt(100) = 0.003。但这在ML-Agents中可能过于激进,建议从1.5-2倍开始尝试。
重新设计时间视野与网络结构
time_horizon 应适当减小,因为大量环境并行时,每个环境不必收集过长轨迹。可以尝试从1000降到200-500。同时,hidden_units: 512 和 num_layers: 3 对于1000个并行环境可能偏小,策略网络需要更强的表达能力来区分不同环境的状态分布。可以尝试增加到1024单元或增加一层。
关于 time_horizon、并行环境与长程依赖的关系:time_horizon 在 ML-Agents 中定义的是每个智能体在两次策略更新之间连续采样的最大步数,它决定了单条轨迹的长度上界。并行环境越多,单位真实时间内智能体与环境交互的总步数越多,因此可以用更短的轨迹凑够所需的 batch 样本量。但 time_horizon 不能无限缩短:对于四足行走这类需要多步协调动作的任务,过短的 horizon 会让智能体难以观察到“迈步—支撑—再迈步”的完整周期,优势估计也会因频繁 bootstrap 而偏乐观或偏悲观。从 1000 降到 200–500 是在样本吞吐与轨迹完整性之间取折中。至于网络容量,当环境数从 10 增到 1000,输入状态分布因地形、初始姿态、扰动不同而变得更杂,若 hidden_units: 512、num_layers: 3 的 MLP 容量不足,策略网络会退化为对所有状态输出近似平均的动作,表现为学不动或奖励停滞。因此在大规模并行时同步增大网络,本质上是提升策略对多样化状态分布的拟合能力。
ML-Agents 实战配置建议
基于原始配置,针对100-1000个并行机器人的场景,建议按以下方向调整:
- batch_size: 8192-32768(根据显存逐步增加)
- buffer_size: 81920-327680
- learning_rate: 0.0001-0.0005(谨慎调整,优先增大batch)
- time_horizon: 200-500
- summary_freq: 100000-300000(避免早期曲线抖动)
- max_steps: 保持30000000或适当增加
此外,开启 threaded: True 可能有助于多环境下的CPU并行采样。如果使用 shared_critic: False,在大量环境时考虑改为 True 以减少参数量。
最关键的一步是分阶段验证:不要一次性从10跳到1000。先做10→50→100→200的消融实验,记录每档的奖励曲线和样本效率,找到崩溃的临界点,再针对性地调整超参数。
总结
PPO并行训练的性能下降并非硬件瓶颈,而是数据分布与策略更新节奏失配。扩展并行环境时,必须同步调整batch_size、buffer_size、学习率和时间视野,保持每次更新的有效梯度信号稳定。ML-Agents社区中已有不少关于大规模并行训练的经验帖,但具体参数仍需结合任务复杂度和硬件条件做实验验证。如果硬件支持10000个环境,建议先用500-1000个环境跑通稳定训练,再逐步逼近上限。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。