PreCap激活函数:无归一化百层MLP匹敌SELU
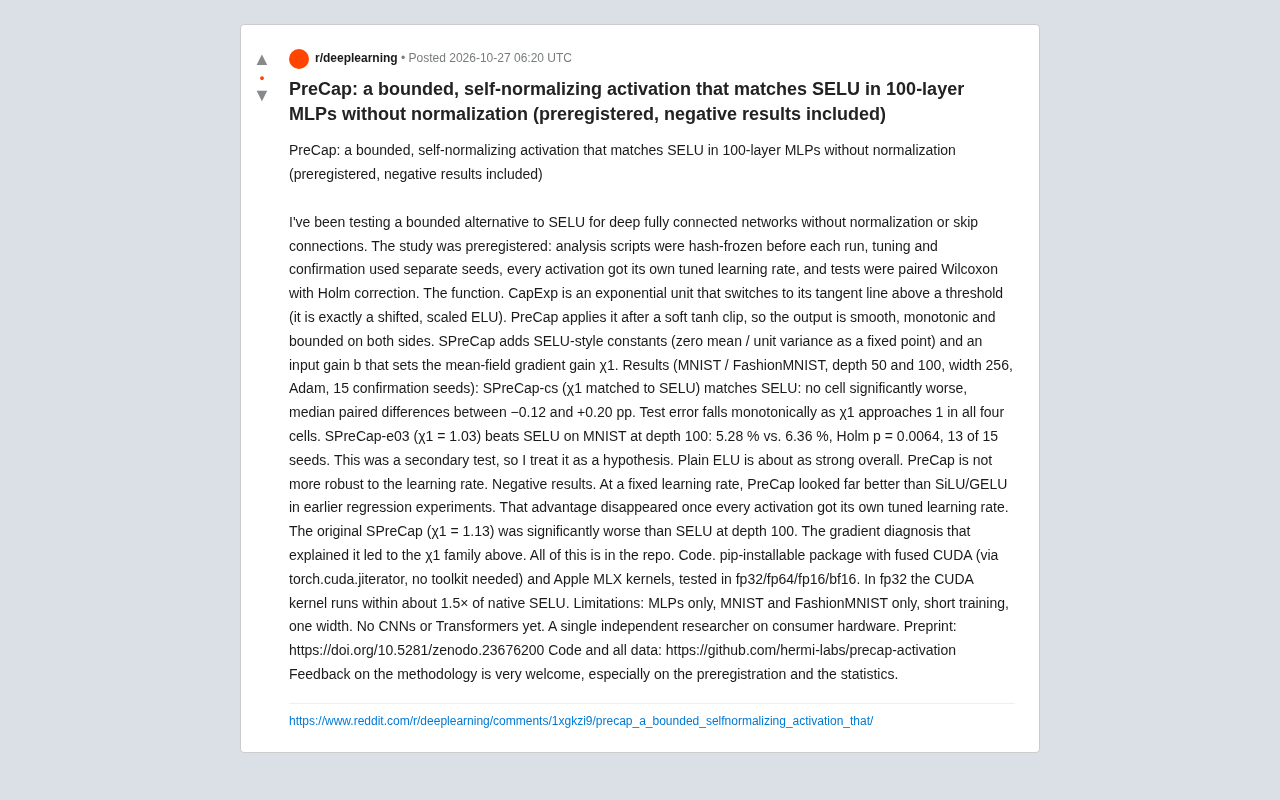
独立研究者提出PreCap激活函数,通过χ1参数控制梯度增益,在无归一化深层MLP上匹配SELU性能,并以预注册流程诚实报告负面结果。
本文介绍了一种名为PreCap的新型激活函数,旨在替代深度网络中的归一化层。PreCap的核心是CapExp(有界指数单元,等价于平移缩放的ELU),并在其前加入软tanh裁剪,使输出平滑、单调且双侧有界。SPreCap进一步引入SELU风格常数和输入增益b,以控制平均场梯度增益χ1。研究采用预注册流程,脚本哈希冻结、独立种子、配对Wilcoxon检验加Holm校正,在MNIST和FashionMNIST的50层和100层MLP上进行实验。结果显示,当χ1匹配SELU时,SPreCap性能与SELU相当;χ1=1.03的变体在100层MNIST上以5.28%错误率优于SELU的6.36%(p=0.0064),但作者仅将其视为待验证假设。研究还诚实报告了负面结果:公平调参后PreCap的早期优势消失,原始SPreCap(χ1=1.13)显著差于SELU。工程上提供了pip可安装包、融合CUDA核和Apple MLX核,fp32下速度约为原生SELU的1.5倍以内。局限性包括仅测试MLP和简单数据集,尚未涉及CNN或Transformer。
引言:深度网络归一化的替代思路
在深度全连接网络中,归一化层(如BatchNorm)和跳跃连接几乎成了标配,但它们也带来了额外的复杂性和计算开销。有没有可能设计一种激活函数,自身就能维持信号在网络中的稳定传播,从而摆脱对归一化的依赖?Reddit上一位独立研究者发布的PreCap激活函数,正是朝着这个方向的一次系统性尝试。该研究采用了预注册(preregistration)的严谨流程,并公开了所有代码与数据,甚至诚实地报告了负面结果。
什么是PreCap?从CapExp到自归一化
CapExp:有界的指数单元
PreCap的核心构建块是CapExp。它本质上是一个指数单元,但当输入超过某个阈值后,会切换为切线(即线性)延伸。研究者指出,CapExp恰好等价于一个经过平移和缩放的ELU。这种设计让函数在正区间保持有界,避免了指数量级的爆炸。
PreCap则在CapExp之前加入了一个软tanh裁剪(soft tanh clip),使得整个函数输出平滑、单调且双侧有界。而SPreCap进一步引入了SELU风格的常数(将零均值、单位方差作为固定点),并增加了一个输入增益b,用来设定平均场梯度增益χ1。
ELU与SELU:ELU(Exponential Linear Unit)是激活函数家族中的经典成员,定义为当输入为正时输出等于输入(线性),当输入为负时输出为 α(e^x - 1)。其特点是负区间平滑且下界为 -α,有助于缓解梯度消失。SELU(Scaled ELU)则在ELU基础上乘以缩放因子 λ(约1.0507),并固定 α≈1.6733,使得当输入服从零均值单位方差时,输出也近似保持零均值单位方差,从而具备自归一化性质。SPreCap 中的「S」正是借鉴了 SELU 的这一自归一化思想。理解 ELU/SELU 的构造,有助于把握 CapExp 为何被描述为「平移缩放的 ELU」,以及 SPreCap 如何通过常数设定来追求类似的自稳定传播。
关键参数χ1
χ1是理解SPreCap行为的关键。它衡量的是梯度在平均场意义下的放大或衰减程度。研究者发现,当χ1接近1时,测试误差在四个实验单元中都单调下降。这一发现直接引导了后续对χ1取值的精细调优。
平均场理论(mean-field theory):平均场分析是研究深度神经网络信号传播的常用理论工具。它将每一层的预激活和梯度视为随机变量,通过假设层间独立性,推导其方差(或相关)如何逐层演化。χ1(通常记作 χ₁)即是在这一框架下定义的梯度增益系数:它近似表示反向传播时梯度方差在相邻层之间的放大倍数。若 χ1 > 1,梯度可能逐层放大导致不稳定;若 χ1 < 1,梯度可能衰减。理想情况下 χ1 ≈ 1 可使梯度信号在深度方向上保持稳定。SPreCap 通过输入增益 b 来调节 χ1,从而在平均场意义上控制信号传播的稳定性。这一概念源自神经网络的初始化理论(如 He 初始化、SELU 的自归一化分析),是理解深度网络无需归一化即可训练的关键视角。
实验设计与统计严谨性
这项研究的实验方法值得单独讨论。作者在每次运行前对分析脚本进行了哈希冻结,调参和确认阶段使用不同的随机种子,每个激活函数都单独调优了学习率,并且统计检验采用配对Wilcoxon检验加Holm校正。这种预注册流程在独立研究者的工作中并不常见,显著提升了结果的可信度。
实验在MNIST和FashionMNIST上进行,深度为50层和100层,宽度256,使用Adam优化器,确认阶段使用15个种子。所有数据、代码和预印本均可公开获取。
预注册(preregistration)与哈希冻结:预注册是指研究者在数据收集和分析之前,公开登记研究假设、实验设计、分析方法和主要结局指标,以减少事后选择性报告(如 p-hacking)带来的偏差。在本研究中,作者在每次运行前对分析脚本进行哈希冻结,即计算并记录脚本的密码学哈希值,确保分析代码在实验过程中未被篡改。这种做法增强了结果的可复现性和可信度。配对Wilcoxon检验与Holm校正:配对Wilcoxon符号秩检验是一种非参数统计方法,用于比较两组配对样本的中位数差异,不依赖正态分布假设。当同时进行多个假设检验时,需控制族错误率;Holm校正是一种逐步下降的多重比较校正方法,比Bonferroni校正更有效但同样严格。这些统计工具的组合在机器学习实证研究中较为严谨,尤其适合独立研究者提升结论的可信度。
主要结果:SPreCap与SELU的对比
χ1匹配SELU时:性能相当
当SPreCap的χ1被调整到与SELU匹配时(SPreCap-cs),它在所有实验单元中都没有显著差于SELU。配对中位差异在−0.12到+0.20个百分点之间,这个范围非常窄,说明两者在统计上难分伯仲。
χ1=1.03时的意外优势
一个次要测试中,χ1设为1.03的SPreCap-e03在100层MNIST上取得了5.28%的测试错误率,而SELU为6.36%。Holm校正后的p值为0.0064,15个种子中有13个种子表现更好。作者谨慎地将其标记为假设(hypothesis),因为这是次要测试,需要独立验证。
普通ELU表现同样强劲
你可能没注意到,普通的ELU在整体表现上与SPreCap相当。这提示CapExp带来的增益可能并不完全来自其特殊设计,而是与ELU家族的整体特性有关。
负面结果:诚实报告的失败
这项研究最有价值的部分之一,是它对负面结果的完整报告。
早期回归实验中,在固定学习率下,PreCap看起来远优于SiLU和GELU。但当每个激活函数都获得各自调优的学习率后,这一优势完全消失了。这提醒我们:跨激活函数的比较必须公平调参,否则结论可能严重偏倚。
另外,原始的SPreCap(χ1=1.13)在100层时显著差于SELU。正是对这一失败案例的梯度诊断,才引出了后续χ1参数族的调优。
PreCap也并不比SELU对学习率更鲁棒。
工程实现与性能
作者提供了一个可通过pip安装的包,包含融合CUDA核(通过torch.cuda.jiterator实现,无需CUDA工具包)和Apple MLX核,并在fp32、fp64、fp16和bf16下进行了测试。在fp32下,CUDA核的运行速度约为原生SELU的1.5倍以内。
这对于一个独立研究者在消费级硬件上完成的项目来说,工程完成度相当高。
融合CUDA核与torch.cuda.jiterator:融合核(fused kernel)指将多个逐元素操作(如激活函数的裁剪、指数、线性组合等)合并为单个GPU内核执行,以减少内存读写和内核启动开销。torch.cuda.jiterator 是PyTorch提供的一个工具,允许用户通过Python函数动态生成CUDA内核,而无需手写C++/CUDA代码或安装CUDA工具包。这大大降低了自定义算子的开发门槛。Apple MLX:MLX是苹果公司为Apple Silicon芯片推出的机器学习框架,提供类似NumPy的API并针对统一内存架构优化。作者为PreCap同时提供CUDA和MLX核,表明其关注跨硬件平台的可移植性。fp32/fp64/fp16/bf16:这些是不同精度的浮点数格式,fp32为单精度,fp64为双精度,fp16和bf16为半精度(bf16动态范围更大),测试多种精度有助于评估激活函数在混合精度训练中的数值稳定性。
局限性与未来方向
作者坦率列出了局限:仅测试了MLP,仅使用MNIST和FashionMNIST,训练时间短,且只测试了一种宽度。尚未涉及CNN或Transformer架构。
这些限制意味着PreCap的实用价值目前仍停留在概念验证阶段。要判断它是否能成为归一化的通用替代品,还需要在更复杂的架构和更大规模的数据集上验证。
总结与启示
PreCap的研究展示了独立研究者如何通过预注册、严格统计和诚实报告负面结果来产出可信的工作。虽然它目前还不能替代归一化层,但χ1参数与测试误差之间的单调关系,以及SPreCap在特定设置下超越SELU的迹象,为激活函数设计提供了有价值的线索。
对于关注深度学习基础研究的读者,这个项目的方法论本身或许比结果更值得借鉴。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。