Prompt Lottery:LLM评审对同义改写的敏感度危机

同义改写提示会使LLM评审结果漂移甚至反转排名,多提示聚合可缓解。
该研究揭示LLM-as-a-Judge存在“Prompt Lottery”现象:语义等价但措辞不同的提示变体会导致LLM评审给出不一致判决,在某些设置下甚至反转模型间的相对排名。通过覆盖多样任务、评委家族与模型骨干的大规模实验,并结合10名人类标注者的基线对比,研究发现LLM评审对同义改写的敏感度是人类的6-9倍,一致性下降幅度低于可用性研究普遍接受的阈值。研究进一步提出多提示聚合策略,通过对多个提示变体的判断进行一致性加权,显著提升评估鲁棒性。结论是单一提示评估不足以支撑可靠的模型排序,评估协议需引入提示变体集成。
引言:LLM-as-a-Judge的隐忧
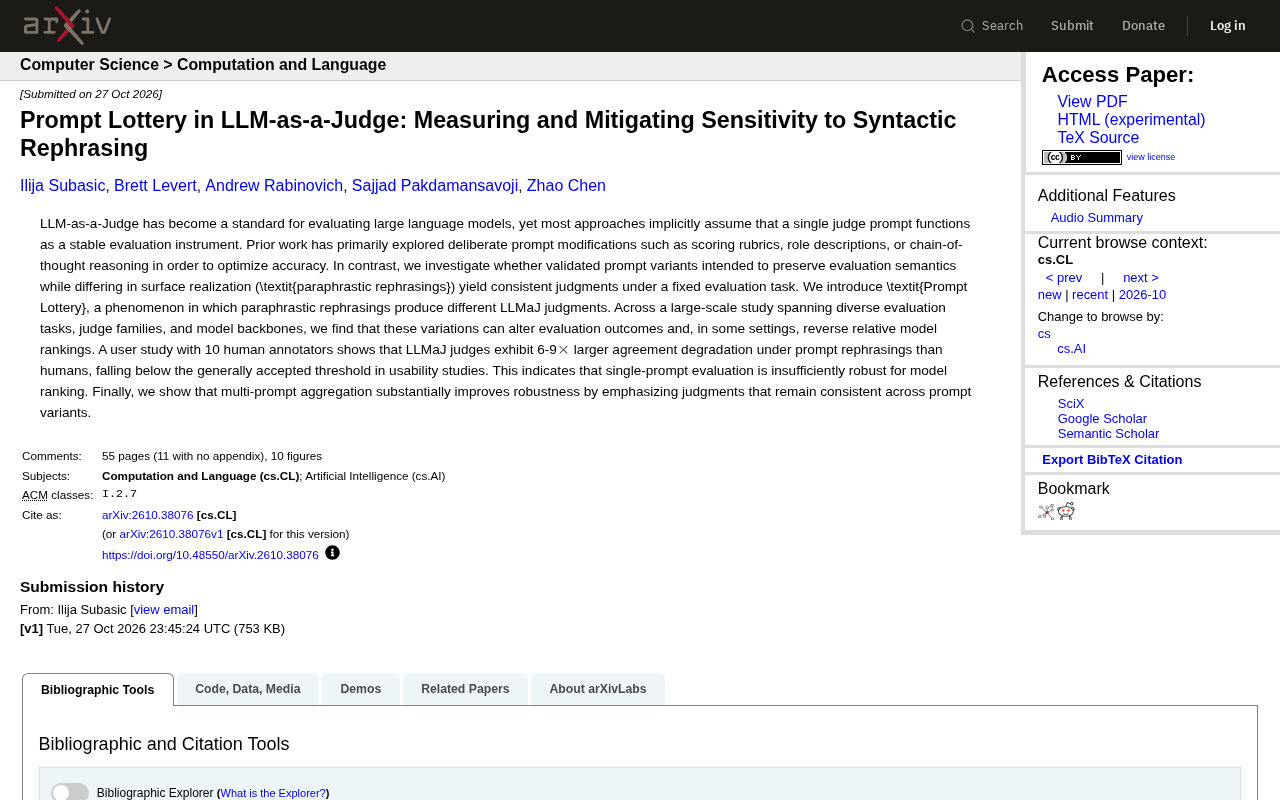
LLM-as-a-Judge(LLMaJ)已成为评估大语言模型性能的常用范式,但大多数方法隐含了一个关键假设:单一的评审提示词(prompt)能够作为稳定的评估工具。然而,一项题为《Prompt Lottery in LLM-as-a-Judge: Measuring and Mitigating Sensitivity to Syntactic Rephrasing》的研究挑战了这一假设。该研究揭示,即使经过验证、语义等价但表面措辞不同的提示变体(即同义改写),也会导致LLM评审给出不一致的判决。研究者将这种现象命名为Prompt Lottery。
LLM-as-a-Judge(LLMaJ) 是指用一个能力强的大语言模型(如 GPT-4、Claude 等)充当评审,对另一个模型的输出进行打分或偏好判断的评估范式。常见形式包括成对比较(pairwise comparison,判断两个回答哪个更好)、单答案打分(pointwise scoring)以及基于参考答案的评分。相比人工评估,LLMaJ 成本低、可扩展性强,已被广泛用于模型排行榜(如 Chatbot Arena 的自动评审变体)、RLHF 奖励建模和学术基准测试。但其成立依赖若干隐含假设:评审模型能理解任务意图、评分标准在提示中表述充分、且判决对提示的表面形式不敏感。Prompt Lottery 研究正是针对第三条假设提出质疑,指出评审输出的稳定性可能被高估。
核心发现:同义改写如何撼动评估结果
实验设计与规模
研究团队开展了一项大规模实验,覆盖多样化的评估任务、评委家族(judge families)和模型骨干(model backbones)。他们对比了原始提示与经过验证的同义改写提示(paraphrastic rephrasings),这些改写旨在保持评估语义不变,仅改变表面实现。
同义改写(paraphrastic rephrasing) 在此语境下特指保持评估语义不变、仅改变句法结构或措辞表达的提示变体,例如主动句与被动句互换、同义词替换、从句顺序调整、增删礼貌性修饰语等。研究强调这些改写经过人工验证,确保不引入评分标准的变化,因此任何判决差异都可归因于表面形式而非任务语义。这与对抗性提示(adversarial prompt)或提示注入不同:后者刻意诱导错误行为,而同义改写模拟的是真实实践中不同标注者、不同模板引擎自然产生的措辞差异。正因改写是“无害”的,其引发的判决漂移才更具警示意义——它说明 LLMaJ 的方差来源之一是无法通过语义校验消除的句法噪声。
主要结论
- 评估结果波动:同义改写能够改变LLMaJ的评估结果,在某些设置下甚至反转模型间的相对排名。这意味着仅凭单一提示的评审结果进行模型排序可能不可靠。
- 远超人类的敏感度:一项包含10名人类标注者的用户研究表明,LLMaJ评委在同义改写下的一致性下降幅度是人类的6-9倍,且低于可用性研究中普遍接受的阈值。
- 多提示聚合的有效性:研究表明,通过多提示聚合(multi-prompt aggregation),强调那些在提示变体间保持一致的判断,可以显著提升鲁棒性。
方法论:从测量到缓解
测量Prompt Lottery
研究者首先量化了同义改写对LLMaJ判断的影响。他们并非随意修改提示,而是使用经过验证的、语义保持的改写版本,从而确保差异仅来自表面措辞。这种严谨的设计使得结论更具说服力:即使提示在语义上等价,LLMaJ的判断也会发生漂移。
人类基线对比
通过10名人类标注者的参与,研究建立了人类在同义改写下的一致性基线。结果显示,LLMaJ评委的敏感度远高于人类,这暗示当前基于单一提示的评估流程可能高估了模型的真实差异。
缓解策略:多提示聚合
研究者提出,利用多个提示变体的聚合判断,并赋予那些在不同变体间保持一致的判断更高权重,可以有效提升评估的鲁棒性。这一策略不依赖于对提示的刻意优化,而是通过集成思路降低方差。
多提示聚合(multi-prompt aggregation) 借鉴了集成学习(ensemble learning)降低方差的经典思路:对同一评估任务构造多个语义等价但措辞不同的提示,分别获取评审判决,再通过投票、平均或一致性加权进行合并。一致性加权的核心直觉是,若某条判断在多个提示变体下都稳定出现,则它更可能反映模型的真实能力而非提示伪影;反之,仅在特定措辞下出现的判断应被降权。这一策略与自一致性(self-consistency)采样有相似之处,但区别在于变化维度是提示而非解码随机性。代价是评审调用次数成倍增加,因此实践中需在鲁棒性收益与推理成本之间权衡,例如仅对排名接近的模型对启用多提示聚合。
对AI评估实践的启示
单一提示评估的局限性
Prompt Lottery现象表明,将LLMaJ视为稳定评估工具存在风险。在模型排行榜、A/B测试或学术对比中,若仅依赖一个提示,排名可能因措辞的微小变化而翻转。这对依赖LLMaJ进行决策的团队是一个警示。
多提示聚合的实用价值
多提示聚合提供了一种简单而有效的缓解方案。实践者可以在评估流程中引入多个语义等价的提示变体,并采用一致性加权策略,从而获得更可靠的模型排序。这虽然增加了计算成本,但相比错误排序带来的风险,可能是值得的。
未来方向
该研究呼吁社区重新审视LLMaJ的评估协议。未来的工作可以探索更鲁棒的聚合方法、自动生成语义等价提示变体的技术,以及将人类一致性作为评估LLMaJ质量的指标之一。
结语
《Prompt Lottery》研究揭示了LLM-as-a-Judge中一个被忽视的脆弱性:同义改写足以动摇评估结论。通过多提示聚合,我们有望构建更稳健的评估体系。在LLM快速迭代的今天,确保评估工具本身的可靠性,与提升模型能力同样重要。
相关推荐

Vibe Coding全栈实战:AI编程从入门到企业级落地
从Cursor到Claude Code,这套B站AI编程实战课程以四个递进项目覆盖全栈开发、开源二次开发与团队协作。文章解析AI编程带来的前端岗位震荡、五人选五十人的效率变革,以及企业级项目所需的方法论。

大卫·布莱恩全球寻访真魔术:从南非到日本与印度
大卫·布莱恩在《Do Not Attempt》特辑中走访南非、日本与印度,记录Spinning车手、黑曼巴蛇保护者、居合术大师与苦行者的真实绝技,探讨魔术与人类极限挑战之间的边界。

触屏MacBook要来了?Vergecast爆料苹果高管回应
Vergecast播客披露记者与苹果高管John Ternus的对话,谈及触屏MacBook与Apple Pencil支持问题。Ternus回应称iPad才是手写笔最佳设备,记者则押注MacBook终将支持Apple Pencil。