ProteinGeoBench:前沿智能体擅长结构查询,却迷失于几何计算

ProteinGeoBench揭示蛋白质结构AI智能体查得好算得差,单一总分掩盖能力短板。
ProteinGeoBench基准测试包含131个蛋白质结构任务,收集了四个前沿模型4249次运行轨迹及26个模型4486次额外试验。结果显示,三个前沿模型得分密集在0.785至0.816之间,统计上无法区分,第四个得0.707。更关键的发现是任务类型分化:数值计算任务仅28个,却占所有模型共同失败任务的一半,而大量元数据查询任务稀释了总分,掩盖了几何计算短板。此外,单次运行时23.9%的bootstrap重采样会排出不同第一名,排行榜对评测预算高度敏感;网络访问与工具框架的影响难以干净分解。作者建议按任务族分别报告结果,并披露运行次数、工具框架与访问条件。
一个被分数掩盖的真相:查得好,算得差
在蛋白质结构分析中,前沿AI智能体展现出一个耐人寻味的反差:它们能快速检索结构元数据,却在从坐标计算几何关系时频频失手。这正是ProteinGeoBench基准测试揭示的核心问题——一个看似简单的性能分数,究竟在多大程度上反映了模型能力,又在多大程度上反映了评估配置本身?
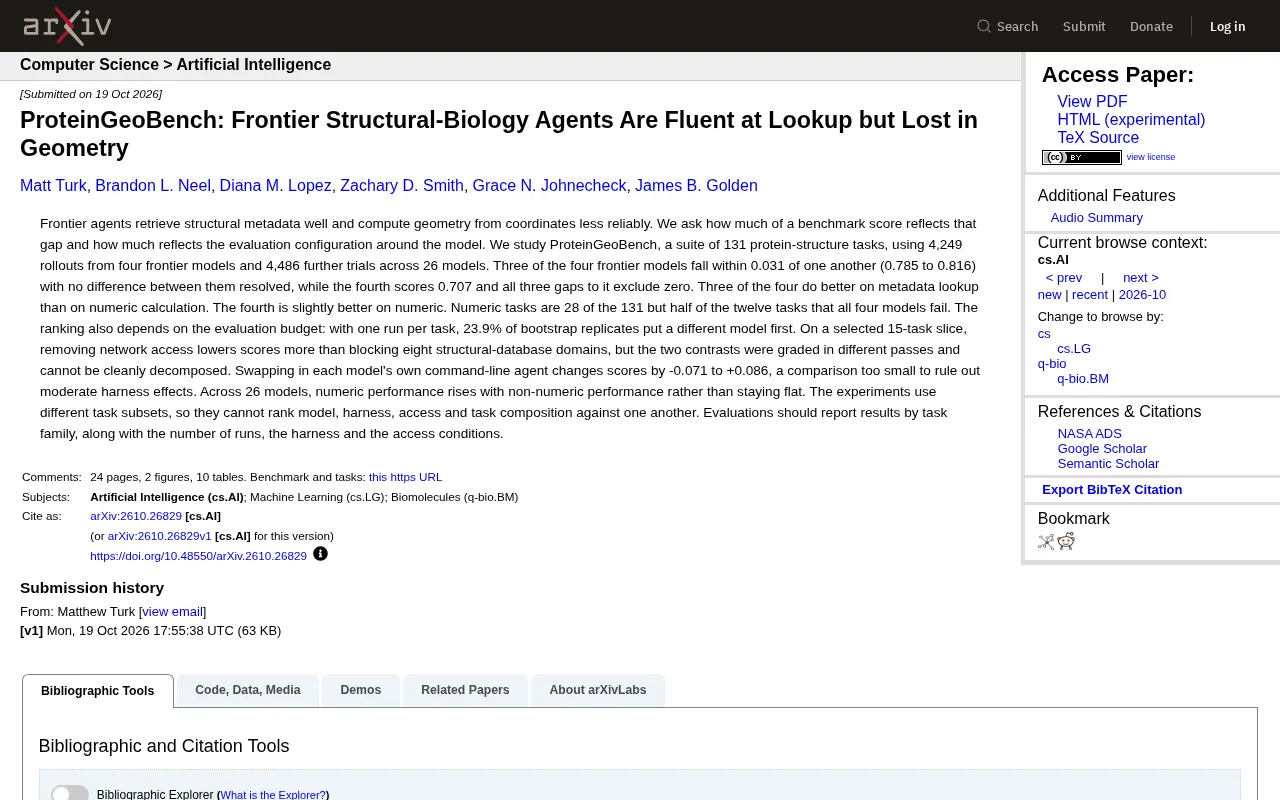
该基准包含131个蛋白质结构任务,研究者收集了四个前沿模型的4,249次运行轨迹,以及26个模型的4,486次额外试验。结果呈现出一种微妙的分布:四个前沿模型中有三个的得分密集在0.785到0.816之间,彼此差距仅0.031,统计上无法区分;第四个模型得分为0.707,与前三者的差距均显著异于零。
这个分数表面看是模型能力的排名,但论文的作者提醒我们:评测配置——包括运行次数、外部工具访问权限、任务子集选择——对结果的影响可能不亚于模型本身的差异。
元数据查询与数值计算:两类任务的分化
更值得关注的发现藏在任务类型的分化中。四个前沿模型里,有三个在元数据查询任务上的表现优于数值计算任务,只有第四个模型在数值任务上略占优势。
这种分化的意义在于任务构成的权重。131个任务中,数值计算类只有28个,但十二个“所有四个模型都失败”的任务里,有一半属于数值计算。换句话说,数值任务虽少,却是失败最集中的区域。当一个基准的总分被大量元数据查询任务“稀释”时,高分可能掩盖了模型在几何计算上的真实短板。
研究者给出的建议很直接:评估应当按任务族(task family)分别报告结果,而不是只给一个总分。这意味着,未来看到“某模型在蛋白质结构基准上得分0.8”时,我们需要追问:这0.8里有多少来自查表,多少来自真正的计算?
任务族(task family) 是评估设计中常用的分组单位,指按照任务所需的认知或操作技能划分的一组题目,例如“元数据查询”与“数值计算”。同一任务族内部的题目共享相似的解题流程与失败模式,因此分组统计能揭示聚合分数掩盖的结构性差异。在基准测试中,若不同任务族的题量悬殊,总分会被题量大的族主导,导致模型在少数族上的严重短板被平均掉。这正是论文建议按任务族分别报告结果的方法论依据:分组报告迫使评估者正视能力分布的不均衡,而非用一个标量掩盖它。
排行榜的脆弱性:一次运行可能排错名次
评估预算对排名的影响同样不容忽视。论文指出,如果每个任务只运行一次,23.9%的bootstrap重采样会把不同的模型排到第一位。这意味着,在单次运行的评测设置下,接近四分之一的重复实验可能给出不同的冠军。
这不是说模型之间没有真实差异,而是说差异的幅度与评测噪声处于同一量级时,排名本身就变得脆弱。对于一个被用来宣称“某模型领先”的排行榜,这种不确定性必须被公开。
Bootstrap重采样 是一种非参数统计方法:从原始评测结果中有放回地反复抽取样本(此处以任务为单位),每次重算模型得分与排名,从而估计排名的抽样波动。若在大量重采样中第一名频繁易主,说明模型间的得分差异落在评测噪声范围内,排名不具稳健性。文中“23.9%的重采样排出不同第一名”即指:在单次运行的设置下,接近四分之一的模拟重复实验会给出与原始排名不同的冠军。这一指标直接量化了排行榜对评测预算(每任务运行次数)的敏感程度。
网络访问与工具权限:难以干净分解的变量
在选定的15个任务切片上,研究者对比了几种访问条件的变化。移除网络访问后分数的下降幅度,大于屏蔽八个结构数据库域名的影响。但作者诚实地指出,这两个对比是在不同的评测轮次中完成的,无法干净地分解出各自独立的效应。
同样,将每个模型替换为其自带的命令行智能体(harness)后,分数变化范围从-0.071到+0.086。这个区间太宽,不足以排除中等程度的工具框架效应。换句话说,模型分数里有一部分可能属于“外挂”的贡献,而非模型本身。
Harness(命令行智能体框架) 指围绕底层模型搭建的执行外壳,负责工具调用、命令执行、上下文管理与错误重试等。同一模型接入不同harness,实际表现可能明显不同,因为harness决定了模型能否访问外部工具、如何解析返回结果、以及失败后是否重试。因此,基准分数中的一部分应归因于harness而非模型权重本身。论文中替换自带harness后分数变化达-0.071至+0.086,正说明框架效应与模型效应量级相当,评估报告若不披露harness,跨研究的分数就难以直接比较。
26个模型的横向观察:数值能力不会孤立提升
在对26个模型的扩展试验中,一个趋势浮现出来:数值计算表现随着非数值表现一起上升,而不是停滞在某个水平。这暗示元数据理解与几何计算能力之间存在相关性——查得准的模型,往往也算得相对好。
但作者谨慎地指出,不同实验使用了不同的任务子集,因此无法将模型、工具框架、访问条件和任务构成这四个因素相互排序。这是一个方法论上的坦诚:我们知道了差距存在,但还不知道每个因素的权重。
对评测实践的启示
ProteinGeoBench的研究指向一个更广泛的议题:AI智能体在科学任务上的评测,需要比“总分排行榜”更细致的报告规范。作者的建议包括:
- 按任务族分别报告结果,而不是只给聚合分数
- 明确说明每个任务的运行次数
- 披露所使用的工具框架(harness)
- 披露网络与数据库访问条件
对于结构生物学这样一个依赖精确几何计算的领域,“查得到”和“算得对”是两种不同的能力。一个能检索PDB条目却算不准原子间距离的智能体,在真实的科研工作流中可能给出看似合理却错误的结论。基准测试的价值,不在于给模型排座次,而在于揭示这种能力结构上的不均衡——而这恰恰是单一分数最容易掩盖的东西。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。