PuppyRouter模型榜0923:GLM5.3爆冷夺冠,GPT6新发

PuppyRouter最新榜单中GLM5.3 Flash日榜登顶,GPT-6 Sol凭半价性价比强势上线,速度与成价比成竞争新轴心。
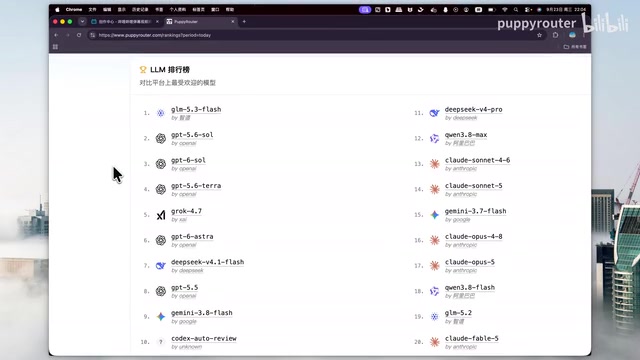
PuppyRouter最新模型调用量排行榜显示,GLM5.3 Flash打破GPT-5.6 Sol长达一个月的霸榜,首次拿下日榜第一。同日上线的GPT-6 Sol以仅为5.6 Sol一半的价格迅速获得推荐,成为性价比首选;而旗舰款GPT-6 Extra则在Computer Use、SVG绘制、Frontier Code等前沿能力榜单上保持领先,与Sol形成"旗舰—性价比"分工。Gemnet 3.8 Flash凭借极致速度跻身前十,DeepSync V4.1 Flash作为原生多模态模型同样进入榜单。榜单整体揭示出当前AI模型竞争的三个新维度:用户对性价比的高度敏感、速度成为差异化卖点、以及旗舰与中段模型之间的明确分工。需注意,该榜单用户群体以Coding需求为主,结果存在场景偏向,不等同于模型综合能力排名。
PuppyRouter模型排行榜解读:GLM5.3 Flash黑马登顶,GPT6系列新鲜上线
时隔许久,PuppyRouter再度更新了模型调用排行榜。这份基于真实用户调用量的榜单,某种程度上比纯粹的基准测试更能反映开发者在实际工作中的选择偏好——毕竟用户用脚投票,性价比与可用性往往比跑分更有说服力。本期榜单最大的看点,是长期霸榜的GPT-5.6 Sol首次被拉下马,取而代之的黑马是GLM5.3 Flash。
本文基于PuppyRouter(puppyrouter.com)Rankings页面的当日数据及UP主的实测点评,梳理榜单前十名的表现与定位。
榜首易主:GLM5.3 Flash成最大黑马
在PuppyRouter的定价体系下,性价比最高的位置此前通常属于GPT-6 Sol,而非GLM5.3 Flash。但本期榜单中,GLM5.3 Flash凭借极高的受欢迎程度一举拿下日榜第一。
这一结果之所以罕见,是因为过去至少一个月里,榜首位置一直被GPT-5.6 Sol牢牢占据——它在本周榜、本月榜中依然处于霸榜状态。GLM5.3 Flash能在日榜上实现碾压式超越,说明这款模型在特定场景下已经积累了相当强的用户黏性。
新发布的GPT-6 Sol:性价比成最大卖点
排在前列的GPT-6 Sol是OpenAI当天发布、PuppyRouter随即上线的新模型。UP主给出的评价聚焦于"性价比"三个字。
从实测体验看,GPT-6 Sol在部分能力维度上超越了GPT-5.6 Sol,但在另一些能力上又不及后者,属于互有胜负的状态。真正的杀手锏在于价格——GPT-6 Sol的定价仅为GPT-5.6 Sol的一半,某些情况下甚至比Tera更低。在能力接近、价格减半的前提下,它成为UP主在站内综合考虑价格后最推荐的模型之一。
中段梯队:速度与综合能力的权衡
第五名Grok 4.7的特点是"干事猛、速度快",综合能力不算差,但也明显不属于最顶尖的那一档。UP主对它的定位是一款快速且有性价比的实用型模型。
第六名GPT-6 Extra则是OpenAI目前最强劲的模型,无论是在Computer Use、SVG绘制还是Frontier Code等前沿榜单上,都处于领先地位。它与GPT-6 Sol形成了明显的"旗舰—性价比"分工。
第七名DeepSync V4.1 Flash是一款原生多模态模型,也是DeepSync官方首个采用Encoder-Decoder架构的模型。不过UP主指出,尽管宣称为Encoder-Decoder,其本质仍偏向某种Decoder结构。从站内性价比角度衡量,这款模型同样表现领先。
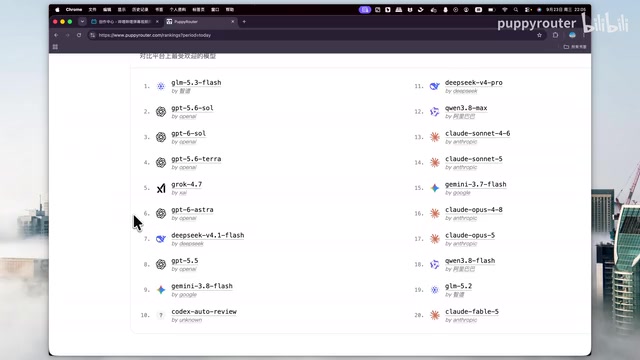
Encoder-Decoder架构与纯Decoder架构是大语言模型设计中的两种主流范式。传统Encoder-Decoder(如早期的T5、BART)由编码器将输入压缩为语义表示、再由解码器生成输出,擅长处理翻译、摘要等需要整体理解输入的任务。当前主流的GPT、LLaMA等大模型则几乎全部采用纯Decoder架构,以自回归方式逐token生成文本,在开放式生成和代码编写上表现突出。DeepSync V4.1 Flash宣称采用Encoder-Decoder架构,理论上意味着它在理解输入结构方面有额外设计,但UP主指出其实际行为仍偏向Decoder模式,这种"名实不符"的情况在多模态模型中并不罕见——厂商有时会将局部的跨模态编码模块冠以Encoder-Decoder之名,而整体生成逻辑依然是自回归Decoder。
写作与速度的差异化选手
第八名GPT-5.5虽然版本号较低,却在写作领域及多个场景中拥有稳定的拥趸。此前评论区曾有网友反馈调用到了5.5,UP主起初以为是配置失误,后来发现是用户主动选择——这款模型在写作能力等方面有着鲜明且难以替代的特点。不过UP主也坦言,站内绝大多数用户仍偏向Coding方向,因此5.5的受众相对小众。
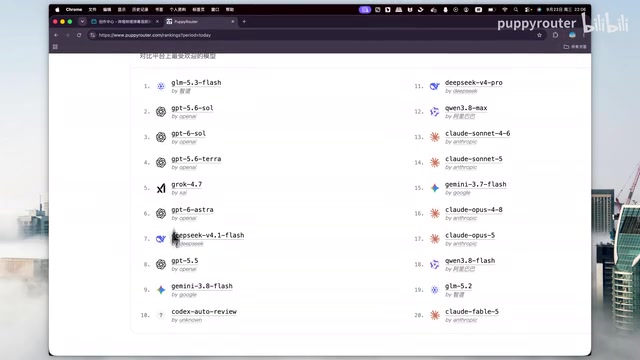
第九名Gemnet 3.8 Flash的关键词只有一个:快。除了快还是快。它的能力中规中矩,但极致的速度挽救了一切,这也让它在站内颇受欢迎。速度优先的使用场景下,它是值得考虑的选择。
特殊存在的第十名与混战的11-20名
第十名严格来说并不是一个独立模型。它本质上是GPT-5.6或用户所使用的GPT-6模型,被封装成了Auto Review(替我审批)模式下调用的模型。如果不开启Auto Review模式、或使用完全访问模式,这个"模型"就不会被调用。它的上榜更多是功能封装带来的统计结果。
第11到20名则呈现混战格局,各类模型交错分布。值得一提的是,Cloud家族当天发布的Cloud Ops 5.5目前仅在Cloud Max分组上线,尚未进入Curl分组和Cursor分组,因此调用量不足、未能上榜。
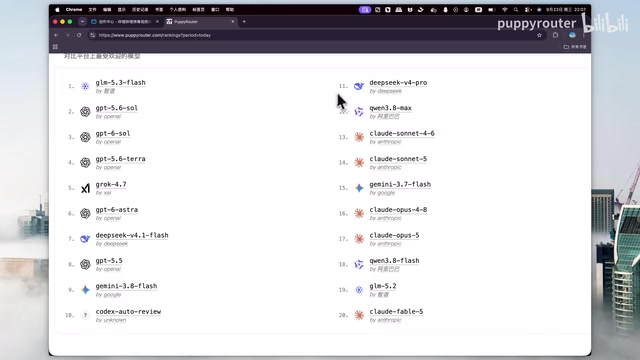
Auto Review(替我审批)是PuppyRouter的一种工作流封装模式,区别于用户直接选定单一模型的"完全访问模式"。在Auto Review模式下,平台会根据任务类型自动调度后端模型——本期榜单中第十名的调用量,实质上来自该模式自动路由到GPT-5.6或GPT-6系列的统计叠加,并非某款独立发布的新模型。这种封装设计的意义在于降低模型选择门槛:用户无需手动评估哪款模型最适合当前任务,平台代为决策。但也因此,其榜单排名更多反映的是该功能的使用频率,而非某一底层模型本身的受欢迎程度,解读时需加以区分。
榜单背后的信号
综合这期榜单可以看出几点趋势:其一,用户对"性价比"的敏感度极高,GPT-6 Sol凭借减半的价格快速赢得推荐,GLM5.3 Flash的登顶也印证了这一逻辑;其二,速度正在成为重要的竞争维度,Gemnet 3.8 Flash靠速度稳居前十即是例证;其三,旗舰模型(如GPT-6 Extra)仍在前沿能力上保持领先,但日常高频调用的主力,往往是那些在能力与成本之间找到平衡点的中段模型。
需要提醒的是,本榜单反映的是PuppyRouter站内用户的调用偏好,用户群体以Coding需求为主,因此榜单结果会向编程场景倾斜,并不等同于模型的全面能力排名。想查看最新的日榜、周榜、月榜数据,可前往puppyrouter.com的Rankings页面实时查询。
PuppyRouter是一个模型聚合调用平台(AI Router),核心价值在于将多家厂商的大语言模型统一接入,用户通过单一接口即可按需切换不同模型,平台负责计费、限流和路由管理。这类平台的排行榜数据与官方基准测试(如MMLU、HumanEval)存在本质差异:基准测试在标准化题集上衡量模型的"天花板能力",而调用量榜单反映的是真实开发者在生产环境中的持续选择——价格、响应速度、稳定性、API兼容性等工程因素都会影响结果。因此同一模型在基准测试中排名靠前,未必在调用榜单中居于前列;反之亦然。理解这一区别,有助于将榜单结论应用于正确的决策场景。
相关推荐

吴恩达联手Anthropic:Claude Code保姆级实战教程全解析
吴恩达与Anthropic合作推出Claude Code短课程,系统讲解清晰上下文、并行会话、MCP服务器等最佳实践,并通过RAG聊天机器人、Jupyter数据分析、Figma转前端三个实战项目,带你从零掌握这款高自主性编程助手。

入门Agent只推荐三个:ZeroStack、Claude Code与DeepSeek Harness
B站UP主推荐三款入门Agent:ZeroStack适合轻量设备,Claude Code生态完善,DeepSeek Harness易于集成插件。本文梳理各工具适用场景与实用技巧。

AI Agent如何操控你的电脑?Hermes三层工具链全解析
B站UP主小悠拆解Hermes操作电脑的三层工具链:出厂自带的Terminal、文件修改与代码执行底座,按需开启的联网搜索、视觉分析、语音合成与浏览器桌面控制,以及通过CLI和MCP自由扩展的外部生态,并解答SSH连上却操作不了的常见困惑。