Python 3.15 采样分析器实战:火焰图与源码热力图
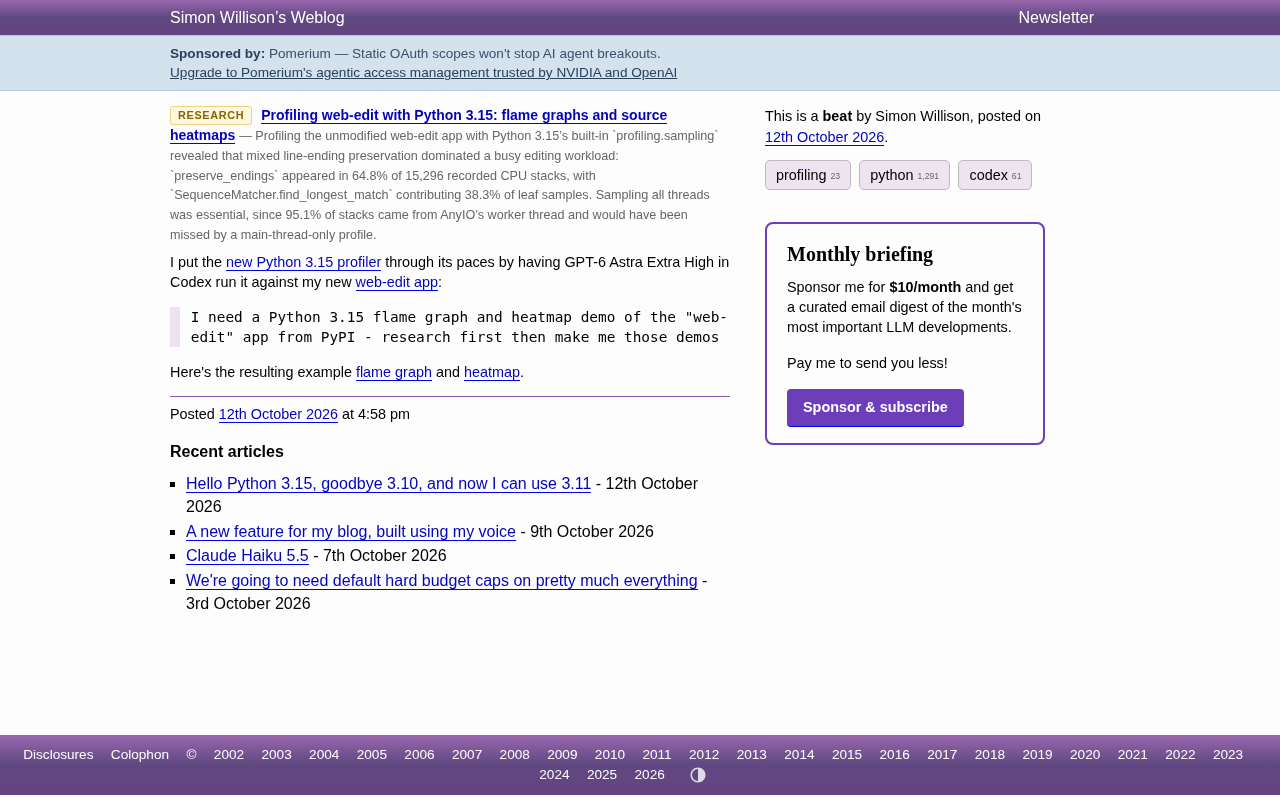
Python 3.15 内置采样分析器,开发者借 AI 生成火焰图与源码热力图完成 web-edit 性能剖析。
Python 3.15 引入了官方内置的采样分析器,以固定频率对调用栈采样,相比 cProfile 等确定性分析器开销更低,更适合长时间运行的服务型程序。知名开发者 Simon Willison 借此对自研 web-edit 应用做了一次完整剖析,他把整个过程交给 Codex 中的 GPT-6 Astra Extra High 驱动:AI 先调研应用结构与分析器用法,再运行剖析并产出交互式火焰图和源码热力图。火焰图从宏观展示调用栈耗时分布,宽而高的帧即优化重点;热力图把采样结果映射到具体代码行,实现行级瓶颈定位。这一实验表明,内置采样器降低了 Python 性能调优门槛,而 AI 工具的能力边界正从写代码扩展到做性能研究与实验自动化。
Python 3.15 引入了一个全新的采样分析器(sampling profiler),这一特性正在改变开发者理解和优化 Python 程序性能的方式。知名开发者 Simon Willison 最近用它对自己开发的 web-edit 应用做了一次完整剖析,并借助 AI 编程工具生成了火焰图与源码热力图。这项实验不仅验证了新分析器的实用性,也展示了 AI 辅助性能分析的可能性。
Python 3.15 采样分析器带来了什么
传统的 cProfile 等确定性分析器会对函数调用进行逐次记录,开销较大,容易扭曲程序的真实性能表现。Python 3.15 的采样分析器采取不同的思路:它以固定频率对调用栈进行采样,从而在较低开销下获得函数耗时的统计分布。
Simon Willison 在其研究仓库中专门记录了这一特性。相比逐调用计数,采样方式更适合长时间运行的服务型程序,也更适合与火焰图这类可视化工具配合使用。火焰图的每一层代表调用栈的一层,横向宽度代表该函数占用的采样比例,让性能瓶颈一目了然。
这一特性的意义在于:Python 长期缺少官方内置、低开销且易于可视化的性能分析手段,开发者往往依赖 py-spy 等第三方工具。3.15 将采样分析能力纳入标准库,降低了性能调优的门槛。
采样分析器与确定性分析器的核心区别在于对程序执行过程的侵入程度。确定性分析器(如 cProfile)通过钩子拦截每一次函数调用和返回,精确记录调用次数和累计时间,因而结果精确到每一次调用;但正因如此,它会引入显著的运行时开销,在高频调用场景下可能让程序慢数倍,并且开销本身会改变程序的执行特征,导致测量结果失真,即所谓的“观察者效应”。采样分析器则完全不修改被分析程序,而是在后台以固定时间间隔(例如每毫秒)中断解释器,抓取当前线程的调用栈快照,最后统计每个函数出现在样本中的频率来估算耗时占比。这种方式的优势是开销低且与被分析程序耦合小,适合线上服务和长时间运行的任务;代价是无法给出精确的调用次数,短命函数可能被漏采,因此需要足够长的采样窗口和合适的采样频率才能得到稳定结论。
用 AI 生成火焰图与热力图的工作流
这次实验的一个关键点在于,整个分析和可视化过程是由 AI 编程助手驱动的。Simon 向 Codex 中的 GPT-6 Astra Extra High 提出了如下指令:
我需要一个 Python 3.15 的火焰图和热力图演示,针对 PyPI 上的 "web-edit" 应用——先做研究,然后给我做出这些演示。
AI 助手先调研了 web-edit 应用的结构和 Python 3.15 分析器的用法,然后运行剖析、收集采样数据,并生成两个可视化产物:一个是交互式火焰图,另一个是源码热力图。
这个流程值得关注的地方在于,性能分析属于需要一定专业经验的领域——如何选择采样点、如何解读调用栈、如何定位热点函数。AI 助手能够自主完成从调研到产出可视化的全链路,说明它已经具备了将工具链组合起来解决实际问题的能力。
火焰图由 Brendan Gregg 在 2011 年提出,是一种将大量调用栈样本聚合后可视化的技术。它的纵轴是调用栈深度,每一层代表一个栈帧,从底部的主函数向上逐层展开被调用的子函数;横轴并非时间轴,而是把所有样本按函数名字典序排列并合并,因此同一帧的宽度直接对应它在全部样本中出现的比例,宽度越大说明该函数占用的 CPU 时间越多。阅读火焰图时,注意力应先放在“宽而平”的帧上,它们代表在多个调用路径中反复出现的热点函数;再横向比较同级帧的宽度,找出耗时占比最高的分支。需要特别留意的是,火焰图的横轴顺序不代表执行先后,不能据此推断调用顺序;此外它反映的是 CPU 占用情况,对于等待 I/O 而被阻塞的时间通常不可见,因此常需要与阻塞分析或异步追踪结果结合使用。
火焰图与源码热力图解读
火焰图以调用栈为基础,横向展开为时间轴,每一帧的宽度反映了该函数在采样中出现的频率。宽而高的帧通常是需要优先关注的优化点。对于 web-edit 这类 Web 编辑应用来说,火焰图能清晰揭示请求处理、文本解析、模板渲染等环节的时间占比。
源码热力图则更进一步,把采样结果直接映射回源代码行。开发者无需猜测哪一行代码耗时最多,热力图会用颜色深浅标注每行的采样命中情况。这种"行级"视角对于定位循环内部的瓶颈、序列化开销或意外的阻塞调用尤其有用。
Simon 提供的两个产物都可以在线访问:火焰图以 HTML 形式呈现,支持交互式探索;热力图则以目录索引形式展示源码行的热度分布。这种可视化组合,把抽象的采样数据转化为可以直接采取行动的优化线索。
源码热力图与火焰图的关键差异在于映射的粒度与视角。火焰图停留在“函数”这一层,回答的是哪个函数耗时最多;而源码热力图把每一条采样记录按其在源码中的位置聚合,直接以颜色深浅或数值标注每一行代码被采样命中的次数,回答的是“哪一行代码最耗时”。在实现上,采样器抓取到的通常是字节码指令位置或行号,需要借助调试符号与源码映射表将其还原到具体的源文件行。热力图的典型用途包括:定位循环体内部代价最高的语句、发现被反复调用的序列化或正则表达式开销、识别隐藏在简单赋值背后的属性查找或哈希计算。使用热力图时应注意,同一函数被内联或优化后行号映射可能不准,此外单行若包含多个表达式,采样无法进一步区分它们的相对开销,必要时需手动拆分代码来验证。
对开发者的实际启示
这次实验传递出几个信号。Python 3.15 内置采样分析器让性能剖析不再是少数人的专利,标准库层面的支持意味着更多工具和库可以围绕它构建。同时,AI 辅助工具正在从"写代码"扩展到"做性能研究"——AI 可以读文档、跑实验、产出可视化,开发者则聚焦于解读结果和决策。
对于日常需要处理性能问题的 Python 开发者来说,一套可行的工作流正在成形:用 3.15 采样分析器收集数据,生成火焰图定位宏观瓶颈,再用源码热力图精确定位代码行。这条链路足够轻量,适合集成到日常开发中,而不是等到性能危机出现才临时抱佛脚。
随着围绕 Python 3.15 分析器的工具生态逐渐成熟,我们可以预期更多可视化方案和自动化分析流程出现。
相关推荐

育儿付费从何时成为常态?职场妈妈与托育变迁
育儿付费何时成为常态?本文梳理从70-80年代托育中心兴起、90年代联邦补贴挂钩工作要求,到污名下降与成本上升的演变,并探讨倡导者推动托育与带薪产假追赶其他国家的25年努力。

AI智能体最该接管的任务是什么?Reddit热议
Reddit热议:你最希望AI智能体完全接管哪项任务?跨应用数据迁移、CRM更新、报告生成位列榜首,但可靠性不足和信任鸿沟成为自动化落地的最大障碍。

产品市场匹配的红色警报:顶级VC与Superhuman创始人实战指南
Iconiq、Sapphire Ventures投资人与Superhuman创始人Rahul Vohra分享产品市场匹配(PMF)的红色警报与实战方法,包括40%失望度法则、留存曲线和获客成本等关键指标。