Python爬虫实战:18个案例带你从零入门

B站18个案例的Python爬虫教程,以爬小说为例讲透requests、UA伪装与编码处理及合规红线。
本文介绍了一套面向零基础的B站Python爬虫教程,以爬取小说网站为切入场景,串联起HTTP请求、User-Agent伪装和编码处理三大核心知识点。文章先说明爬虫的本质是模拟浏览器自动抓取网页数据,应用覆盖学术研究、信息聚合、搜索引擎索引、竞品监控和自动化测试等方向。随后演示最简入门流程:安装requests库、发送GET请求、设置headers伪装UA、处理中文乱码,并给出浏览器抓包定位URL与请求方法的具体方法。最后强调robots协议、请求频率控制、只爬公开数据等合规红线,并指出该教程适合零基础小白入门,但复杂反爬与分布式爬取仍需进阶学习。
网络爬虫是获取公开数据的重要工具,也是Python初学者最容易上手的实战方向。B站上一套涵盖18个实战案例的Python爬虫教程,以爬取小说网站为切入点,把HTTP请求、User-Agent伪装、编码处理等核心知识点串成了一条完整的学习路径。
爬虫到底能做什么
网络爬虫本质上是一个自动获取网页内容的程序,它模拟人类浏览网页的行为,从互联网上抓取所需数据。教程用了一个很接地气的场景来引入:起点上很多小说按章收费,几百万字的长篇一套下来要花不少钱,而爬虫可以帮你把公开章节内容抓取下来。当然,教程也明确提醒——不要针对官方付费网站下手,这类网站反爬技术强,而且爬取付费内容属于侵权行为。
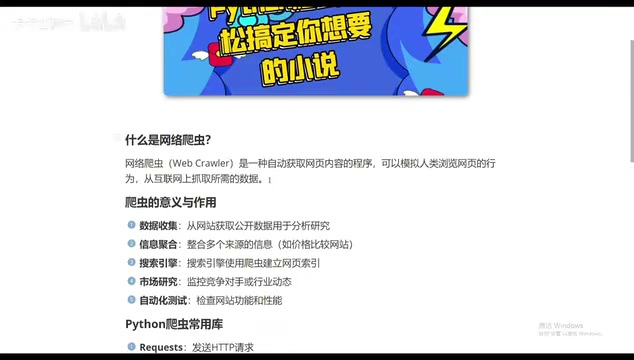
爬虫的应用远不止小说。教程列举了几个典型方向:
- 数据收集与学术研究:从网站获取公开数据用于分析
- 信息聚合:整合多个来源的信息,价格比较网站就是典型案例
- 搜索引擎索引:搜索引擎依靠爬虫建立网页索引库
- 市场研究与竞品监控:跟踪竞争对手或行业动态
- 自动化测试:检查网站功能和性能
这些场景说明,爬虫是一项通用技能,掌握了基础原理之后可以迁移到很多领域。
入门只需一个requests库
Python爬虫的入门门槛比很多人想象中低。教程演示的最简流程只需要用到requests模块,通过pip安装后,三步就能跑通第一个爬虫:
- 用
requests.get(url)向目标网站发送请求 - 将返回的数据赋给变量
- 通过
print以字符串形式输出内容
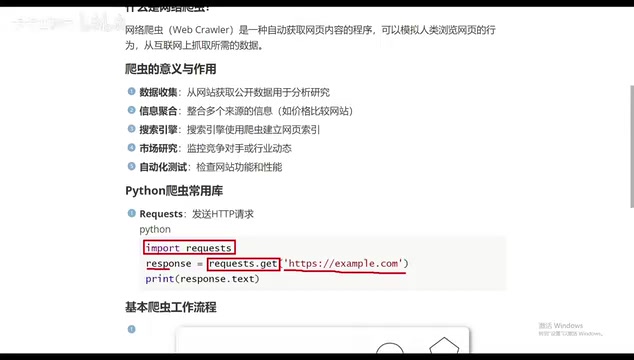
爬虫的工作流程可以概括为:发送HTTP请求获取网页内容→解析数据提取所需信息→存储数据→跟踪链接继续爬取。整个过程中,理解浏览器与服务器之间的请求-响应模型是关键。教程用了一个直观的类比:你的电脑是客户端,淘宝、京东、起点这些网站是服务器,输入网址就是向服务器发起请求,服务器返回网页内容后,爬虫再从HTML中提取你真正需要的那部分数据。
实战演示:爬取小说网站的三个关键步骤
教程以爬取一部公开小说为例,完整演示了从浏览器抓包到代码落地的过程。
第一步:找到正确的请求方式和URL
在浏览器中打开目标小说网站,右键点击"检查",切换到Network面板,刷新页面后查看第一个请求。重点确认两件事:请求的URL是什么,以及请求方法是GET还是POST。教程中该网站使用的是GET方法,所以代码里也用requests.get。
这里的"Network面板抓包"值得展开说一下。所谓抓包,是指在浏览器开发者工具中观察每一次网络请求与响应的完整过程。打开Chrome或Edge的开发者工具(F12或右键"检查")后,切到Network标签页,刷新页面,浏览器向服务器发出的所有请求(HTML文档、图片、JS、CSS、Ajax接口等)都会按时间顺序列出来。点击任意一条记录,可以在Headers里看到请求URL、请求方法(GET/POST)、请求头(含User-Agent、Cookie等);在Response或Preview里看到服务器返回的内容。爬虫开发通常关心的正是那份"数据真正所在"的请求——可能是主文档,也可能是某个返回JSON的XHR接口。掌握按类型筛选(Fetch/XHR、Doc)和搜索关键字,能大幅提高定位效率。
第二步:伪装请求头
直接用requests请求网站往往拿不到想要的内容,因为服务器会判断请求来自真人浏览器还是自动化程序。解决办法是添加headers,把浏览器的User-Agent信息以字典形式传入请求中。
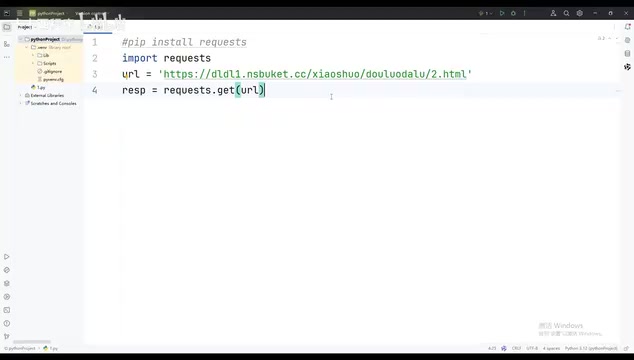
User-Agent相当于一个数据抓包的身份标识,告诉服务器"我是一个正常的浏览器"。这一步是很多初学者爬虫失败的首要原因——代码没报错,但返回的内容不对或者被拒绝。
User-Agent(简称UA)是HTTP请求头中的一个字段,格式类似"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 ...",用来告诉服务器发起请求的浏览器内核、操作系统、版本等信息。服务器通过它区分正常浏览器和脚本程序,很多网站会直接拒绝UA缺失或明显异常的请求。获取自己浏览器UA的最快方式,就是在Network面板里复制任意请求的User-Agent值。除UA外,常见的请求头还有Referer(来源页)、Cookie(登录态)、Accept-Language等;当遇到更严格的反爬时,往往需要连同这些字段一起构造,让请求看起来与真实浏览器一致。
第三步:处理中文编码
请求成功之后,打印出来的内容可能是一堆乱码。教程中的解决方案是在输出前设置编码为UTF-8。加上这行设置后,中文内容就能正常显示了。这三个步骤跑通,一个最基础的小说爬虫就完成了。
乱码的根源在于"编码"与"解码"不一致。网页内容在服务器端以某种字符集(常见为UTF-8或GBK)编码成字节流传输,requests收到的是原始字节,如果按错误的字符集去解码,中文就会显示成乱码。requests通常能根据响应头里的Content-Type自动推测编码,但推测并非总是准确,尤其对部分国内老网站会猜错。此时可以手动指定响应的编码,例如使用response.encoding = 'utf-8',或改用response.content.decode('gbk')显式解码,再打印或写入文件。判断具体用哪种编码,可查看网页源码中<meta charset=...>标签,或观察响应头中的charset参数。
写爬虫必须知道的几条红线
教程在最后专门强调了爬虫的法律和伦理边界,这部分的重量不亚于技术本身:
- 尊重robots协议:遵守网站规定的爬虫规则
- 控制请求频率:设置延迟,避免给服务器造成过大负担
- 只爬公开数据:未经授权爬取非公开数据可能触犯法律
- 合理设置代理:使用合规的请求方式,不要恶意绕过反爬机制
教程用"喜提国家三年劳饭"这种略带调侃的方式提醒违法爬取的后果,虽然表达轻松,但传递的信号很明确:技术能力越强,越需要清楚边界在哪里。
robots协议(robots.txt)是网站根目录下的一个纯文本文件,用来告知爬虫哪些路径允许抓取、哪些禁止,例如"Disallow: /admin/"。它是行业约定而非法律强制,但主流搜索引擎都会遵守,个人爬虫遵守它也是基本的行业礼仪。与之相关的还有《数据安全法》《个人信息保护法》以及《刑法》中关于"非法获取计算机信息系统数据罪"的条款:公开数据与个人信息的边界、爬取是否获得授权、是否影响目标网站正常运行,都是判断合规与否的关键。此外,爬取付费、需登录或涉及个人隐私的内容,即使技术上能够实现,法律风险也远高于抓取公开页面。
适合谁学
这套18个案例的教程定位非常清晰——面向零基础小白。从最基础的库安装讲起,逐步过渡到真实网站的爬取实战,每个知识点都配有浏览器端的对照操作。对于想用Python做点实际项目、又不知道从哪开始的初学者来说,爬虫是一个反馈快、成就感强的切入点。需要注意的是,教程覆盖的是入门级内容,面对复杂反爬机制、动态渲染页面、大规模分布式爬取等场景,还需要进一步学习。
如果你已经掌握了Python基础语法,想找一个练手项目,从爬虫开始是个不错的选择。关键在于动手跑通第一个案例,后面的路会越走越宽。
相关推荐

Gmod TTT:Boba的连胜神话与游戏设计启示
深入分析Gmod TTT模组游戏的角色系统、道具创意与多人社交博弈机制,从Boba连胜现象探讨随机性设计与游戏平衡的关系,揭示这款经典模组的持久魅力来源。

FlexBudget:在统一算力预算下公平比较KV缓存淘汰策略
AMD工程师在PyTorch Conference提出FlexBudget,通过固定kernel和显存预算、只替换KV缓存淘汰规则,实现training-free的公平方法比较,全部基于核心PyTorch实现。

Anthropic 2万亿估值拆解:AI上市潮为何接连折戟
Anthropic寻求2万亿美元估值,相当于史上最大十起科技IPO估值总和。但利率飙升、IPO撤回、TAM通胀、循环融资闭环正在动摇AI上市潮的定价基础。本文拆解2万亿估值背后的逻辑漏洞,以及英伟达为何反而便宜。