PyTorch训练随机性溯源:六类入口与控制策略

PyTorch训练中随机性分散在六个环节,仅设torch种子不足以复现,需系统控制并区分统计复现与逐比特复现。
文章系统梳理了PyTorch训练流程中随机性的六个入口:Python/NumPy随机状态、权重初始化时序、DataLoader的shuffle生成器、多进程worker的独立随机状态、Dropout等随机层的操作顺序依赖以及GPU非确定性算子。仅设置torch.manual_seed远远不够,需要同时固定random和numpy.random,确保在模型创建前设种子,为DataLoader显式传入自定义Generator,使用worker_init_fn为每个worker播种,并考虑启用确定性算法。文章强调跨硬件和分布式配置的逐比特复现难以保证,建议在方法比较时运行多个种子并报告均值与离散程度,同时养成记录种子、库版本、commit hash和数据划分标识的实验习惯。
为什么“设了种子”还是复现不了?
在深度学习实验中,设置随机种子几乎成了标配动作。但很多开发者都遇到过这样的困惑:明明固定了torch.manual_seed(0),两次训练的结果仍然存在细微差异。Reddit社区的一篇技术讨论帖系统梳理了PyTorch训练流程中随机性的六个入口,并给出了对应的控制手段。这个问题的本质在于,随机性并非来自单一源头,而是分散在Python层、数据管道、模型初始化以及GPU算子等多个环节。
六个随机性入口逐一拆解
1. Python与NumPy的随机状态
数据加载、数据增强以及用户自定义代码中,常常混用random和numpy.random。只设置PyTorch的种子并不够,需要同时固定三者:
import random, numpy as np, torch
random.seed(0)
np.random.seed(0)
torch.manual_seed(0)
这一步是基础,但远非全部。
2. 权重初始化的时序陷阱
模型参数的初始化受torch种子控制,但前提是种子必须在模型创建之前设置。如果先构建模型再设种子,初始化已经消耗了随机数序列,后续设置无法回溯修正。这个时序细节容易被忽略,却是复现失败的常见原因。
3. DataLoader的shuffle生成器
DataLoader的shuffle=True内部使用随机生成器。更稳妥的做法是显式传入自定义生成器:
g = torch.Generator()
g.manual_seed(0)
loader = DataLoader(ds, shuffle=True, generator=g)
这样数据顺序的随机源就完全可控,不会与其他随机调用纠缠。
torch.Generator 是 PyTorch 中管理随机数生成器状态的独立对象,它封装了底层的伪随机数算法及其内部状态(种子和已消耗的随机数序列)。每个 Generator 实例拥有自己的状态,与全局默认生成器互不干扰。在 DataLoader 中显式传入 generator 参数的好处是:shuffle 操作只消费该生成器的随机序列,因此即使你在训练循环中调用了其他随机函数(如 dropout、数据增强),也不会改变 shuffle 的随机顺序。这在需要严格复现数据加载顺序时尤为重要。此外,使用独立 Generator 还便于在分布式训练中为不同进程派生不同但可复现的种子,避免所有进程加载完全相同的数据顺序。
4. 多进程worker的独立随机状态
当num_workers > 0时,每个worker拥有独立的随机状态,worker内部调用的增强库可能以不同方式播种。标准解法是通过worker_init_fn,从基础种子为每个worker派生并设置种子。这一环节在涉及图像增强、文本扰动等复杂预处理时尤其关键。
5. Dropout与随机层的操作顺序依赖
Dropout等随机层使用torch生成器,理论上被种子覆盖。但前提是两次运行的算子调用顺序完全一致。改变batch顺序或调用次数,都会改变随机数序列的消费方式,导致结果偏移。换句话说,种子固定只保证序列起点相同,不保证消费路径相同。
6. GPU非确定性算子
部分CUDA操作(例如基于原子加的算子)即使固定所有种子,每次运行仍会产生轻微不同的结果。可选的压制手段包括:
torch.use_deterministic_algorithms(True)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False
use_deterministic_algorithms在遇到没有确定性版本的算子时会直接报错,这反而成了定位问题的线索。部分CUDA版本还需要额外的环境变量来启用确定性矩阵乘法,具体可查阅PyTorch的复现性文档。需要权衡的是,确定性模式通常伴随性能损失。
CUDA 原子操作(atomic operations)是一种允许多个线程同时安全更新同一内存地址的机制,常见于归约、嵌入层梯度累加等场景。由于线程执行顺序不确定,每次运行中浮点加法的顺序可能不同,而浮点加法不满足结合律,因此会产生微小的数值差异。torch.use_deterministic_algorithms(True) 会强制使用确定性版本的算子(如果存在),遇到没有确定性实现的算子则抛出错误,从而暴露出隐藏的非确定性来源。需要注意的是,该设置需要配合 CUBLAS_WORKSPACE_CONFIG 环境变量(如 :4096:8)来启用确定性矩阵乘法,否则部分 CUDA 版本仍会报错。启用确定性模式后,性能通常会有 5%-20% 的下降,具体取决于模型和算子组合。
跨硬件与分布式:精确复现的边界
即便完成了上述所有设置,结果仍可能因硬件、库版本或分布式配置不同而变化。把逐比特复现当作一个需要持续测试的目标,而非默认假设,是更务实的态度。作者的建议是:在比较两种方法时,不要依赖单一种子,而应运行多个种子并报告均值与离散程度。如果方法间的差异小于种子间的波动,就不应将其解读为改进。
值得养成的实验记录习惯
每次运行记录种子、库版本、commit hash以及数据划分标识,这些信息在排查复现问题时价值极高。讨论帖最后抛出的问题也值得思考:你追求的是跨种子的统计可复现性,还是严格的逐比特复现?前者关注结论的稳健性,后者服务于调试与审计场景,两者对应不同的工程投入。
常见问题
Q:设了种子后结果仍有差异,最先排查哪里? A:优先检查多进程worker的播种逻辑和GPU非确定性算子,这两处最容易被种子覆盖不到。
Q:确定性模式会不会显著拖慢训练? A:会有性能开销,具体幅度取决于模型与算子组合,建议在调试阶段开启、正式训练时按需关闭。
Q:分布式训练下还能做到逐比特复现吗? A:跨硬件与分布式配置的精确复现非常困难,更现实的做法是追求统计层面的可复现性。
相关推荐
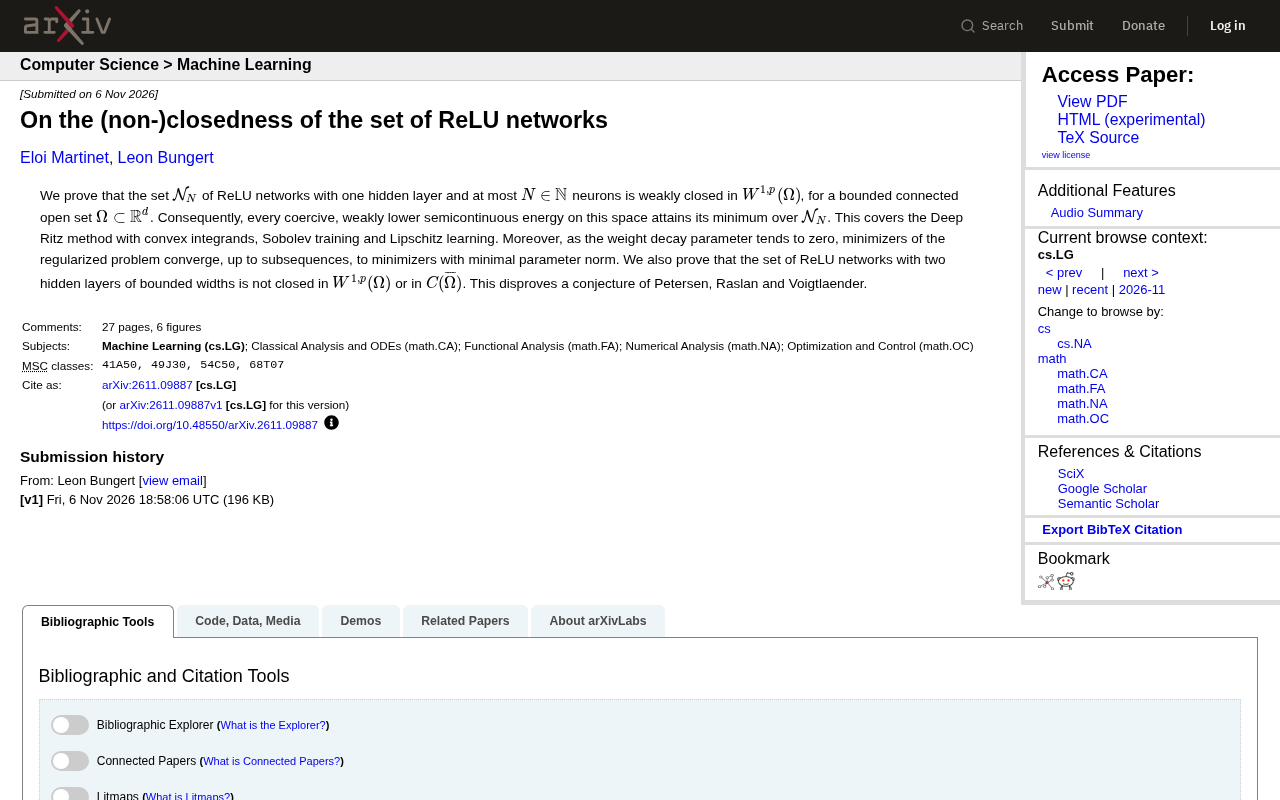
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
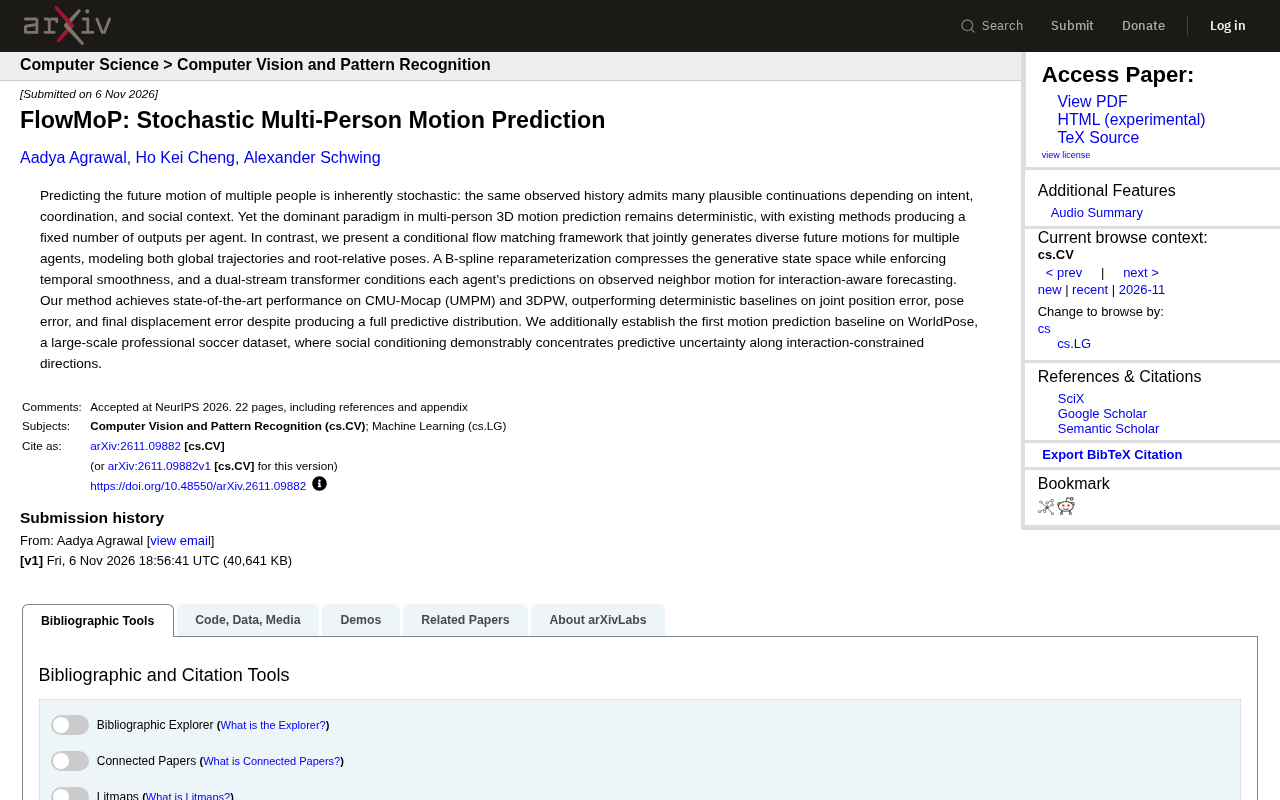
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
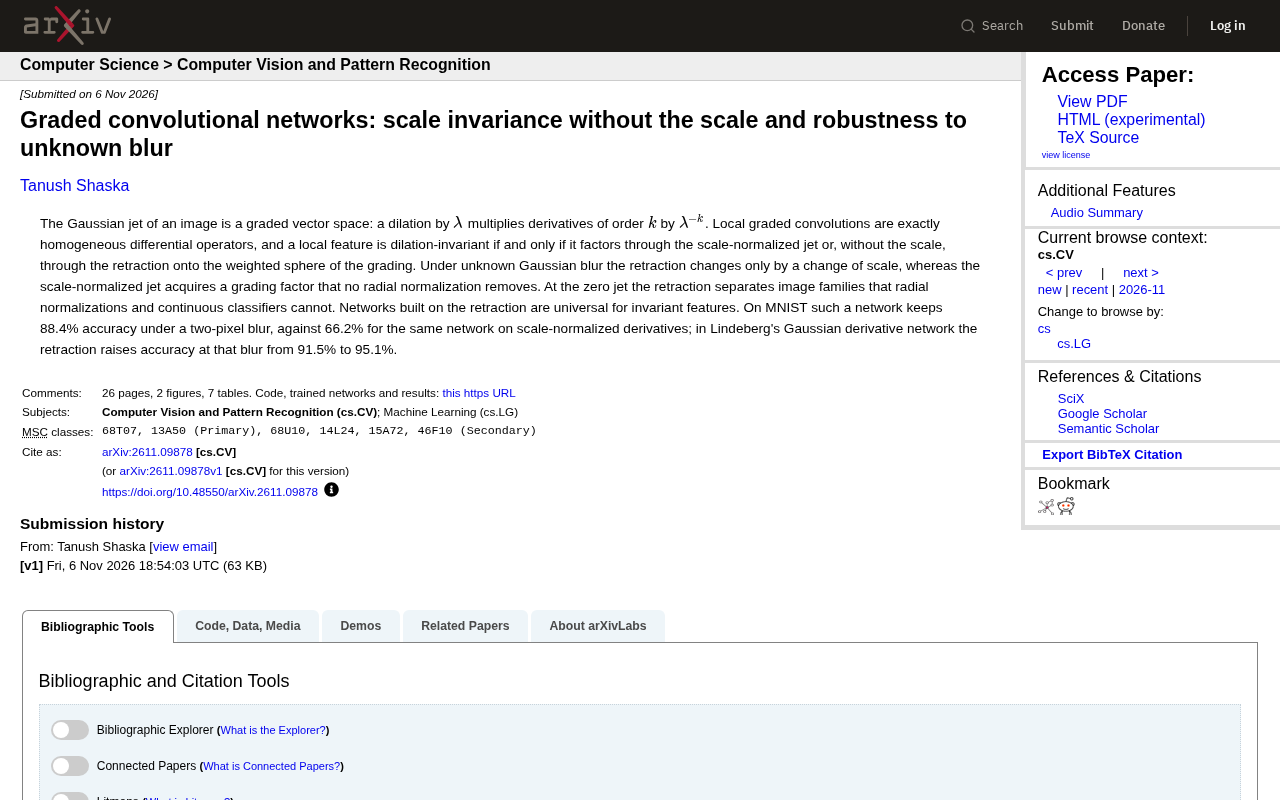
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。