Q3 全球贸易动态:地缘与宏观分析的自动生成内容乱象

一篇号称全球贸易分析的文章实为三条加密返佣链接,揭示自动生成内容以形式伪装套利的生态问题。
文章以一篇题为《Global Trade Dynamics Q3 2026》的 RSS 文章为样本,指出其正文没有贸易数据或宏观分析,只有 Binance、Ledger、Crypto.com 三条联盟返佣链接和一句"由 Nexus Intelligence 自主研究系统生成"的署名。作者将其解剖为三层:标题 SEO 外壳、工具推荐变现逻辑、"自主研究"标签的滥用。文章进一步分析 RSS 聚合器因协议开放、缺少内容验证而成为重灾区,并列出五条识别特征,如标题极具体而正文空洞、主体为带联盟参数的产品列表、结构完整但段落极短。最后指出该现象对读者信任、平台推荐系统和优质分析作者造成三方损耗,核心矛盾是内容生产边际成本趋零、筛选成本上升。
当"全球贸易分析"变成一场推荐链接秀
一篇题为《Global Trade Dynamics Q3 2026 — Geopolitical & Macroeconomic Analysis》的RSS文章,被自动化工具抓取并推送到内容系统。打开原文后,读者看到的却是:推荐工具列表——Binance、Ledger、Crypto.com 三条带返佣链接的广告,外加一行小字声明"本文由 Nexus Intelligence 自主研究系统生成"。
没有贸易数据,没有地缘政治推演,没有宏观经济模型。标题承诺的"Q3 2026全球贸易动态",正文只字未提。
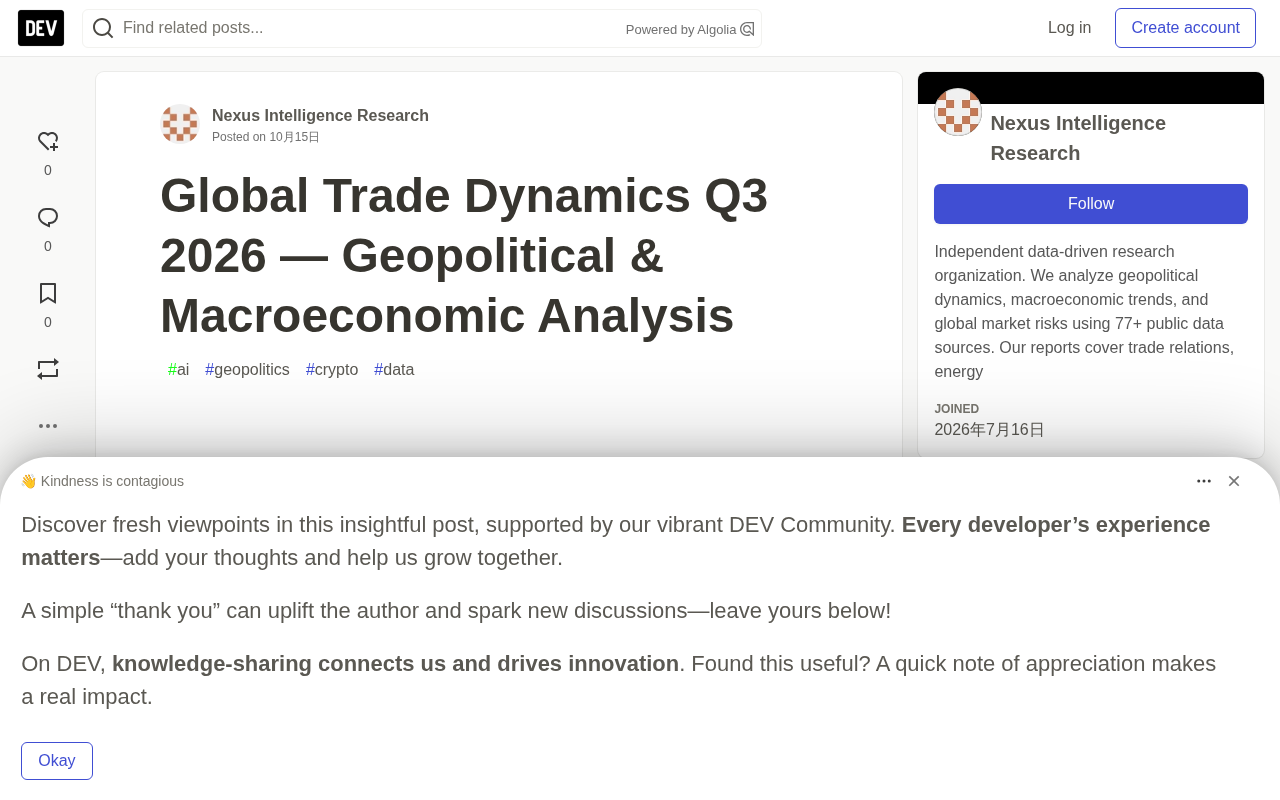
这不是孤例,而是一种正在蔓延的内容生产模式:用高价值关键词包装低信息密度的变现页面,再借助RSS和自动化发布管道扩散到聚合平台。它在形式上满足了内容分发的最低要求(标题、正文、结构标签),但在实质上制造了信息噪音。
自动生成内容的三层解剖
第一层:标题的"SEO 外壳"
"Global Trade Dynamics"本身是一个高质量关键词组合,天然吸引对国际经贸、供应链重构、地缘风险定价感兴趣的读者群。加上"Q3 2026"的时间限定和"Geopolitical & Macroeconomic Analysis"的专业后缀,标题在搜索和RSS阅读器中都具备点击吸引力。
问题在于,标题与正文之间没有任何内容契约。这不是标题党,而是标题与内容的彻底断裂——标题来自一个话题库,正文来自一个联盟营销模板,两者通过自动化脚本拼接,彼此不知对方存在。
SEO 外壳(SEO Shell)指内容的标题、摘要和结构化标签(H1/H2、meta description)被单独优化以最大化搜索与聚合平台点击,而正文并不承载对应信息。其常见做法包括:从高搜索量话题库抽取关键词组合(如"地缘政治"+"宏观"+"2026"),拼接时间限定词与专业后缀以提升专业感,再通过 schema.org 结构化数据、OG 标签等让页面在聚合器中呈现完整摘要卡片。这一策略之所以有效,是因为排序与推荐算法长期依赖标题-点击率、关键词匹配等表层信号,而非语义一致性。当标题与正文脱钩,搜索引擎的"标题-正文相关性"权重会被系统性套利。
第二层:工具推荐的变现逻辑
正文的核心结构包括一个H2标题"Recommended Tools"和三条列表项,分别指向Binance(加密货币交易)、Ledger(硬件钱包)、Crypto.com(加密资产买卖)。三个链接均包含 ref=YOUR_REF 或类似参数,表明这是联盟返佣链接的标准写法。
这一模式在加密货币内容领域尤为普遍:用任何能够带来搜索流量的标题吸引用户,然后在正文中插入返佣链接获取转化。贸易分析只是外衣,加密交易引流才是内核。两者之间的桥梁是——"凡是关注全球宏观的人,大概率对加密资产也有配置需求"这一假设。
联盟返佣(Affiliate Marketing)指内容发布者通过带追踪参数的链接(如 ref=、utm_source=)将用户导向商户,用户完成注册或交易后发布者获得佣金。在加密领域,交易平台与硬件钱包的返佣比例通常为交易手续费的一定百分比或固定推荐奖励,单次有效转化可达数十至数百美元,因此成为自动化内容的主要变现出口。与之配套的还有"追踪像素"和"转化回传"机制,使发布者能实时评估每个标题/页面的转化率,从而反向优化标题选择。这一闭环解释了为什么高流量但低相关的标题会被反复使用:其KPI不是信息价值,而是点击到注册的转化漏斗。
第三层:"自主研究系统"的署名悖论
文章末尾标注"This article was generated by Nexus Intelligence autonomous research system"。一个自称"自主研究系统"的工具,产出的内容却是三条广告链接和一句免责声明。
这暴露了一个行业性问题:"自主研究""智能生成"等标签正在被滥用为质量背书。当读者看到这类署名时,往往默认背后存在数据采集、分析、成文的完整链条,但实际交付的可能只是一个空壳。自动化越容易,填充"看起来像文章"的最低内容就越廉价。
RSS 聚合器为何成为重灾区
RSS 的设计初衷是让读者订阅可信来源的更新,但它的开放协议也意味着:任何能被解析为 XML 的地址都可以进入聚合管道。这带来两个后果:
- 验证缺失:聚合器通常只检查 feed 格式是否合法,不审查内容质量或来源可信度
- 规模效应:一个自动生成脚本可以批量产出成百上千个"文章",只要有一个被订阅或收录,就能持续触达读者
对内容审核系统而言,这类页面的检测难度在于:它有标题、有正文、有链接、有结尾声明——形式上完整。真正缺失的是信息增量:读者读完没有获得任何关于全球贸易、地缘政治或宏观经济的有效认知。
这也解释了为什么单纯的关键词过滤和长度检查无法解决问题:一篇200字的广告和一篇2000字的深度分析,后者不一定更有价值,但前者更容易被识别;而当自动生成内容开始模仿长文结构时,识别成本会进一步上升。
RSS(Really Simple Syndication)是一种基于 XML 的订阅协议,发布者提供 feed 地址,聚合器或阅读器按格式解析条目并展示。其协议只规定字段结构(title、link、description、pubDate 等),不包含来源认证、内容签名或质量评级机制,因此任何符合 XML 规范的地址都能被收录。历史上 RSS 依赖"编辑推荐"和域名声誉来筛选来源,但在自动化聚合与算法推荐兴起后,这一人工环节被大幅削弱。加之 feed 可被镜像、代理和重新发布,原始域名常被掩盖,导致聚合器既难追溯来源,也难在收录前完成内容质量判断。
对读者和平台的双向损耗
对读者:信任被消耗。当一个人点击"全球贸易分析"却被导向加密返佣链接,他下次面对同类标题时会更犹豫——无论那篇是真是假。
对平台:内容池被稀释。推荐系统和搜索排名一旦将这类页面纳入,就需要额外的信号(停留时长、跳出率、社交传播)来反向修正,而这些信号本身也可能被操纵。
对真正的分析作者:注意力被挤压。地缘贸易和宏观经济分析本是高门槛领域,需要数据源、模型和历史语境。当低成本的自动生成内容占据同一条分发管道时,优质内容的边际曝光收益下降。
内容农场(Content Farm)与"信息增量"是理解这类损耗的关键术语。信息增量指读者阅读后获得的、此前不具备的有效认知或可操作结论,它不同于字数、段落数等形式指标。内容农场则是以低成本批量生产形式合格内容、通过广告或联盟变现的运营模式,其经济性建立在"生产边际成本低于单次转化收益"之上。当生成式工具将单篇成本压低到接近于零,农场式扩张会迅速稀释平台内容池,推高推荐系统识别真实价值的成本;同时,高跳出率与短停留时长等负向信号一旦被用作训练数据,还可能污染排序模型,使优质内容的曝光进一步受限。
自动生成内容的识别清单
从这篇样本中可以提炼出几条实用的识别特征:
- 标题极具体,正文极空洞——标题包含具体时间、具体领域、具体分析类型,正文却没有任何对应细节
- 正文主体是工具/产品列表——且链接带有明显的联盟参数
- 结尾有"自动生成"或"AI研究系统"声明——但没有说明数据来源或方法论
- 页面结构完整但段落极短——H2/H3 齐全,但每个小节只有一到两句话
- 来源不明——通过RSS分发,但原始域名与署名系统名称不一致或无法查证
这些特征单独出现不一定说明问题,但叠加出现时,内容的信息价值极大概率低于形式价值。
谁在受益,谁在受损
回到这篇样本本身:它不是一个需要被"分析"的贸易报告,而是一个需要被"识别"的内容样本。它的存在意义不在于传递信息,而在于测试内容生态的过滤能力——从RSS抓取到聚合收录,从标题生成到链接插入,每一环节都在测试自动化系统对"形式合格但实质空洞"的容忍度。
对内容创作者而言,这个样本的价值是反向的:它清晰地展示了什么样的内容应该被避免。对平台而言,它提出了一个持续存在的问题——当生产内容的边际成本趋近于零时,筛选内容的边际成本必然上升。
全球贸易分析需要真实的贸易数据、地缘事件追踪和宏观框架。自动生成系统可以辅助信息整理,但无法替代分析本身。当"自主研究"四个字被用来包装三条返佣链接时,受损的不只是读者的注意力,还有整个自动化内容工具的信用基础。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。