QAgent:让AI智能体告别"凭感觉上线"的自动化质检工具
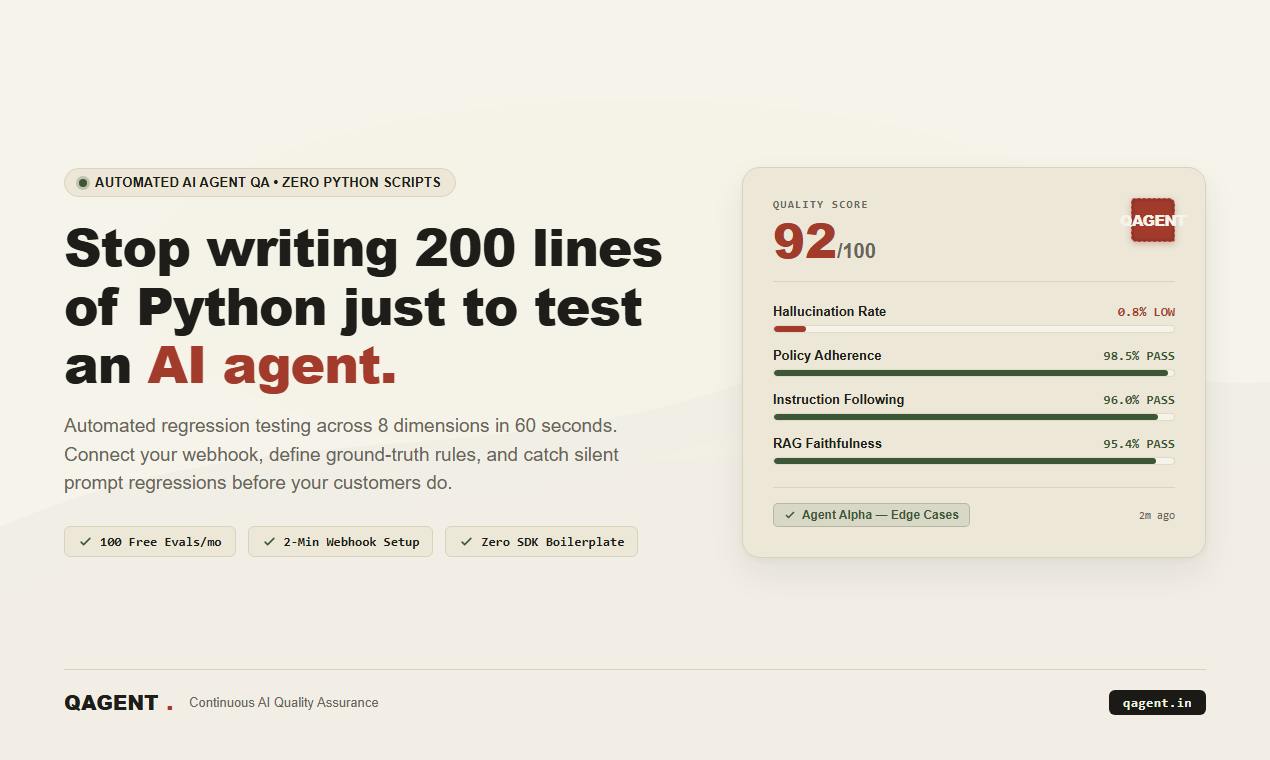
QAgent将AI智能体的质量测试系统化,以正确性评分、幻觉检测等能力取代"凭感觉上线"。
AI智能体快速进入生产环境,但多数团队缺乏系统化的质量验证手段,幻觉输出、策略违规等问题可能直接暴露给真实用户。QAgent是一款专为AI智能体设计的自动化测试工具,提供正确性评分、基于ground truth的幻觉检测、策略合规验证和RAG基准测试四大核心能力,旨在将主观的质量判断转化为可重复、可量化的测试流程。该产品在Product Hunt上线后获72票、当日排名第18,触达了真实市场需求,但具体评测精度与使用体验仍有待更多用户验证。随着AI Eval赛道竞争日益激烈,QAgent能否脱颖而出,将取决于其产品深度与易用性。
AI智能体正在快速走进生产环境,但一个尴尬的现实是:许多团队仍在"凭感觉"决定何时把它推给真实用户。缺乏系统化的质量验证,意味着幻觉、策略违规和错误回答可能直接暴露给客户。近期登上 Product Hunt 的开发者工具 QAgent 试图解决这一痛点——它把"AI 智能体的质量测试"变成一套可自动化、可量化的流程。
从"凭感觉发布"到可度量的质量
QAgent 的口号直击行业软肋:"Stop shipping on vibes"(别再凭感觉上线)。这句话背后反映的是当前 AI 应用开发的普遍困境。传统软件有成熟的单元测试、集成测试体系,但生成式 AI 的输出具有不确定性,一次看似正常的对话并不能保证下一次不会出错。
在 Product Hunt 上,QAgent 归类于 Developer Tools、Artificial Intelligence 和 Bots,由 Abhiram Reddy.K 打造,上线后获得 72 票、排名当日 #18。虽然票数不算爆款,但它切中的问题——AI 智能体的可靠性验证——正是越来越多团队在落地阶段绕不开的关卡。
QAgent 的四大核心能力
根据官方描述,QAgent 提供了围绕 AI 智能体质量的一整套评估维度:
正确性评分(Correctness Scoring)
工具会对智能体的回答打分,衡量其输出是否符合预期。这为团队提供了一个可追踪的量化指标,而不是主观判断"这个回答好不好"。
幻觉检测(Hallucination Detection)
QAgent 强调基于"ground truth"(真实基准答案)来检测幻觉。这一点很关键——脱离参照标准的幻觉检测往往流于形式,而对齐真实答案才能真正识别出模型"一本正经胡说八道"的情况。
所谓"幻觉"(Hallucination),是指大语言模型在没有事实依据的情况下生成听起来合理但实际错误的内容,例如捏造不存在的引用、日期或政策条款。检测幻觉通常有两种路径:一是基于模型自身的置信度或内部一致性判断,二是将输出与外部"ground truth"数据集进行语义比对。后者更可靠,但需要团队事先准备标注好的标准答案库。对于企业级应用,ground truth 通常来源于官方文档、产品手册或经人工审核的问答对。没有这一参照基准,再复杂的检测算法也只能识别格式异常,难以判断内容真实性。
策略合规验证(Policy Adherence)
对于面向企业和客户的智能体,是否遵守既定的业务规则、合规要求同样重要。QAgent 可以验证智能体的回答是否越界,避免因违规输出带来的法律或品牌风险。
RAG 基准测试(RAG Benchmarking)
检索增强生成(RAG)已成为企业级 AI 应用的主流架构。QAgent 提供 RAG 基准测试能力,帮助团队在错误回答触达真实用户之前,评估检索与生成环节的整体表现。
检索增强生成(Retrieval-Augmented Generation,RAG)是一种将外部知识库与语言模型结合的架构:系统先根据用户问题从文档库中检索相关片段,再将这些片段作为上下文传给模型生成回答。这一架构能有效减少幻觉、让模型引用最新或私有数据,因此在企业知识助手、客服机器人等场景中被广泛采用。RAG 的质量取决于两个环节:检索阶段能否召回真正相关的文档,以及生成阶段能否忠实利用检索到的内容而不"脑补"。基准测试通常会分别评估这两个环节的指标,例如检索召回率(Recall)和答案忠实度(Faithfulness),帮助团队定位瓶颈究竟在检索还是生成侧。
为什么这类工具正在变得重要
AI 智能体的评估(Evaluation)正在成为一个独立且快速增长的细分赛道。随着智能体从 Demo 走向生产,团队需要回答几个硬问题:它的准确率是多少?会不会编造事实?会不会违反公司政策?RAG 检索到的内容质量如何?
这些问题无法靠人工抽检解决。QAgent 这类工具的价值在于把主观的质量感受转化为可重复、可回归的测试流程——就像传统软件的 CI/CD 一样,让 AI 应用在每次迭代后都能跑一遍质量检查。
对于正在构建客服机器人、内部知识助手或垂直领域智能体的开发者来说,在上线前建立这样一道质量防线,可以显著降低生产环境中的"翻车"概率。
AI 智能体评估(LLM Evaluation / AI Eval)作为独立工具赛道,近年涌现出多个代表性产品,如 Ragas、DeepEval、LangSmith 和 Brainlid 等,各自在评估维度、集成方式和定价上有所差异。这一赛道快速增长的背景是:越来越多团队已完成 Proof of Concept,正面临从原型到生产的"最后一公里"挑战——如何在没有确定性输出的前提下建立可信赖的质量保障体系。与传统软件测试不同,LLM 评估需要处理语义相似性而非精确匹配,这使得评测框架本身也依赖语言模型作为"裁判"(LLM-as-a-Judge),由此引入了评估结果本身的可靠性问题,是该领域持续被讨论的核心挑战之一。
值得关注但仍需验证
需要客观指出的是,QAgent 目前公开的信息主要来自 Product Hunt 的产品介绍,具体的评测精度、集成方式、定价和实际使用体验还有待更多用户反馈来验证。72 票的热度说明它触到了真实需求,但它能否在竞争日益激烈的 AI Eval 赛道中站稳,取决于产品的深度与易用性。
对于关注 AI 应用工程化的团队,QAgent 提供了一个值得纳入调研清单的选项。至少,它提醒了整个行业一件事:AI 智能体的质量,不该只靠"感觉"。
相关推荐
WAN 2.1 物理动效 LoRA 横评:11 款实测排名与方法论
一位 Reddit 用户用光流分析对 WAN 2.1 上 11 款物理动效 LoRA 做了控制变量横评,仅 3 款真正有效,4 款效果低于对照组。本文解析测评方法、量化数据与冠军 LoRA 的物理正确性。
Lucid与Bolt达成合作,剑指欧洲Robotaxi市场
Lucid Motors宣布与欧洲移动出行平台Bolt达成合作意向,共同探索欧洲Robotaxi市场,但目前尚未落地车辆订单。本文解析这一合作的背景、模式与行业意义。
谷歌英伟达联手Emerald AI:破解数据中心电网困局
谷歌、英伟达、Anthropic 联合 Emerald AI 组建新联盟,计划为数据中心寻找 100 GW 电网容量,破解 AI 算力扩张下的电力瓶颈。本文解析联盟构成与技术路径。