QASecClaw实验:多智能体协作与验证反馈的可靠性边界

研究通过五个实验表明,在确定性证据已存在时,扩展语言模型上下文或智能体规模收益有限,验证器反馈虽提升正确判定但引入更多错误。
该研究围绕“上下文数量扩展”“验证器反馈”“证据可靠性”三条线索,使用Qwen2.5-Coder-7B-Instruct等模型完成13,638次请求。实验发现:将上下文从1增至50,token使用量增49倍,但不安全代码清除率未提升;原始验证器反馈将平均正确判定从12.7提至22.0,错误判定从1个增至7个,而JBMC+JVM基线更稳健;模型能拒绝70%-100%的适用反例,构造检查可正确分类所有证据包;三个Defects4J缺陷均未发现目标缺陷。结果支持在测试环境中采用确定性证据准入策略,并暴露判定聚合、反馈解读和评估覆盖的局限。
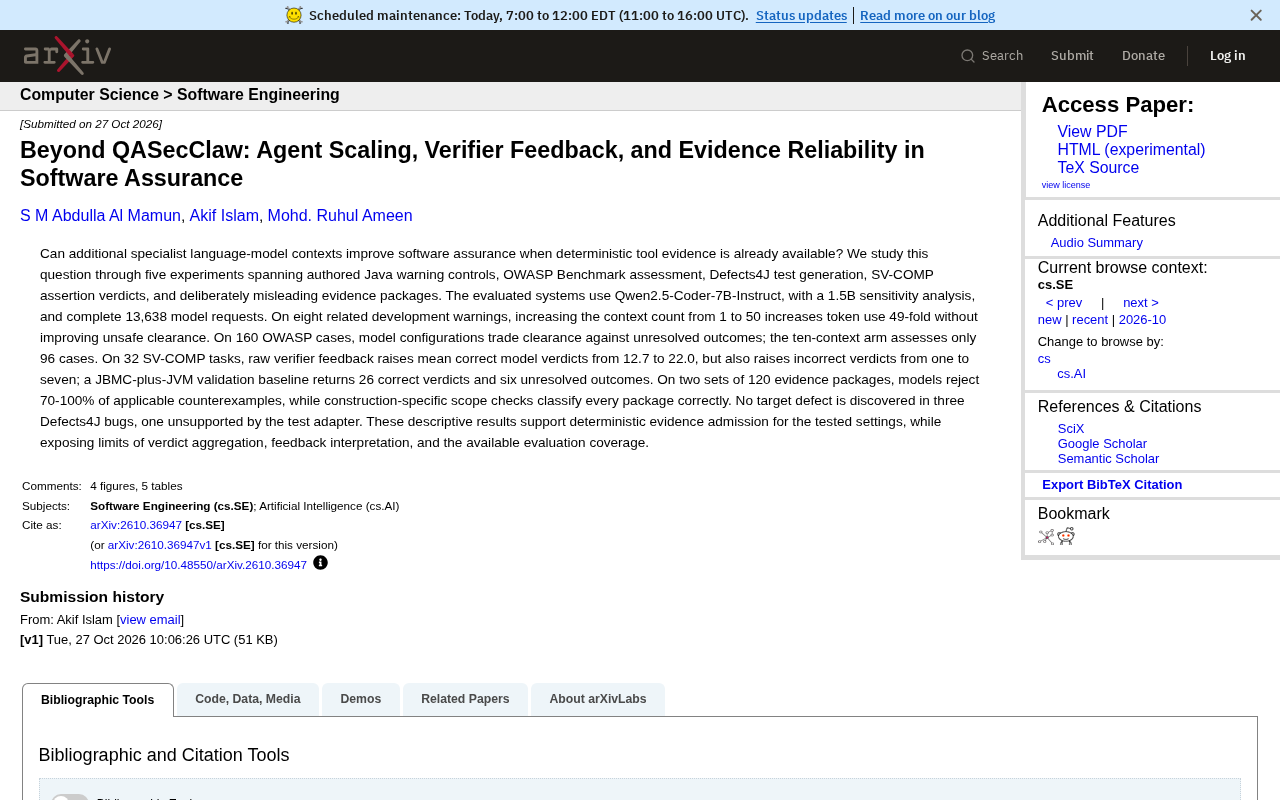
当确定性工具已经能提供证据时,增加更多专精语言模型的上下文能否提升软件保障的效果?一篇题为《Beyond QASecClaw: Agent Scaling, Verifier Feedback, and Evidence Reliability in Software Assurance》的研究通过五个实验探讨了这个问题,覆盖Java警告控制、OWASP Benchmark评估、Defects4J测试生成、SV-COMP断言判定以及故意误导的证据包。实验使用Qwen2.5-Coder-7B-Instruct,并辅以1.5B模型进行敏感性分析,共完成13,638次模型请求。
实验设计与核心发现
研究围绕“上下文数量扩展”“验证器反馈”“证据可靠性”三条线索展开。在八个相关开发警告上,将上下文数量从1增加到50,token使用量增加了49倍,但并未提升不安全代码的清除率。这意味着单纯增加模型上下文规模,在确定性证据已经存在时,收益非常有限,甚至可能带来成本浪费。
在160个OWASP案例上,不同模型配置在“清除”与“未解决”结果之间进行权衡;十上下文实验组仅评估了96个案例,暴露出评估覆盖的局限性。研究还发现,在32个SV-COMP任务上,原始验证器反馈将平均正确模型判定从12.7提升到22.0,但同时将错误判定从1个增加到7个。一个JBMC加JVM的验证基线返回了26个正确判定和6个未解决结果。这表明验证器反馈能提升正确率,但也可能引入新的错误,需要谨慎解读。
QASecClaw 是一个基于智能体(agent)架构的软件保障框架,其核心思想是将语言模型与确定性工具(如静态分析器、验证器)结合,由智能体协调证据收集与推理。本研究的“Agent Scaling”指的是通过增加智能体数量或上下文规模来扩展系统能力,而非单纯扩大模型参数量。Ware 等人在此前工作中提出 QASecClaw 原型,而本文进一步系统评估了扩展策略的有效性边界。
OWASP Benchmark 是由 OWASP 基金会维护的 Java 漏洞检测基准,包含数千个刻意构造的漏洞与误报案例,用于评估静态分析工具和 AI 模型在真实漏洞模式上的检测能力。Defects4J 则是广泛使用的 Java 缺陷数据集,提供真实项目中的缺陷版本与测试用例,常用于评估自动程序修复和测试生成技术。SV-COMP 是国际软件验证竞赛,其任务涵盖断言检查、可达性分析等,为验证器提供标准化基准。
验证器反馈的双刃剑效应
验证器反馈看似是提升模型判定质量的有效手段,但实验数据揭示了其复杂性。正确判定数量显著上升的同时,错误判定也成倍增加。这意味着模型可能过度依赖反馈信号,将部分模糊或错误的反馈当作可靠依据,导致误判。
研究对比的JBMC-plus-JVM验证基线表现更为稳健:正确判定更多,且未解决结果更少。这暗示在软件保障场景中,确定性验证工具与模型推理的结合方式需要精心设计——不是简单地把反馈丢给模型,而是需要建立证据准入机制,确保只有可靠的证据进入模型决策环节。
JBMC(Java Bounded Model Checker)是 CBMC 工具链中针对 Java 字节码的有界模型检查器,能够对 Java 程序进行符号执行和断言验证。JVM 验证基线指在 JVM 上直接运行程序并检查断言的传统动态验证方法。两者结合形成的基线,利用 JBMC 的静态穷举能力与 JVM 的动态执行结果相互印证,从而在 SV-COMP 任务上获得更高的正确判定数和更少的未解决结果。这种组合方式体现了确定性工具在证据生成上的优势:它们不依赖概率推理,输出结果具有可复现性和可审计性。相比之下,语言模型基于反馈信号调整判定时,可能将模糊或错误的反馈内化为决策依据,导致误判增加。
证据可靠性与误导性输入
在两套各120个证据包的测试中,模型拒绝了70%到100%的适用反例,而针对构造特定范围的检查则能正确分类所有证据包。这一结果说明,模型在面对误导性证据时具备一定的识别能力,但并非万无一失;而基于构造规则的检查在特定范围内更为可靠。
在三个Defects4J缺陷上,没有发现目标缺陷,其中一个缺陷甚至不被测试适配器支持。这进一步说明,当前评估覆盖范围有限,模型在真实缺陷发现上的能力仍受制于测试基础设施和证据质量。
对软件保障实践的启示
这些描述性结果支持在测试环境中采用确定性证据准入策略,同时暴露了判定聚合、反馈解读和评估覆盖方面的局限。对于实践者而言,盲目扩展智能体数量或上下文规模并不可取;更有效的路径是构建可靠的证据筛选机制,明确验证器反馈的适用边界,并持续扩展评估覆盖范围。
研究没有给出“智能体 scaling 万能”的结论,反而提醒我们:在软件保障这类高风险领域,确定性工具的可靠性仍是基石,语言模型更适合作为辅助角色,而非替代品。未来的工作需要在更多真实缺陷和更丰富的证据类型上验证这些发现。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。