QERA:先提问再回答,破解隐式上下文推理难题

QERA让模型在作答前先向上下文提问,弥补隐式需求盲区。
文章围绕 CL-bench Life 基准揭示的问题展开:前沿大模型在真实生活上下文学习任务上解决率不足 20%,根源在于用户的最终请求并不等于完整需求规格,超过 80% 的评分标准与请求内容词重合度不足 60%,模型对隐式标准的通过率仅 67%,明显低于显式标准的 81%。为此研究者提出 QERA 架构,将请求转化为需求清单与类型化信息需求,经代码过滤保证忠实性,再从全对话检索证据、用验证过的引文反复提问,并通过受保护的局部修复完善答案。该方法无需训练和预定义评分标准,平均每任务约四次 LLM 调用。在 405 个任务上,QERA 平均解决率达 21.0%,超过最强推理时基线的 18.2% 与直接回答的 14.6%,且 token 消耗远低于对比方法。
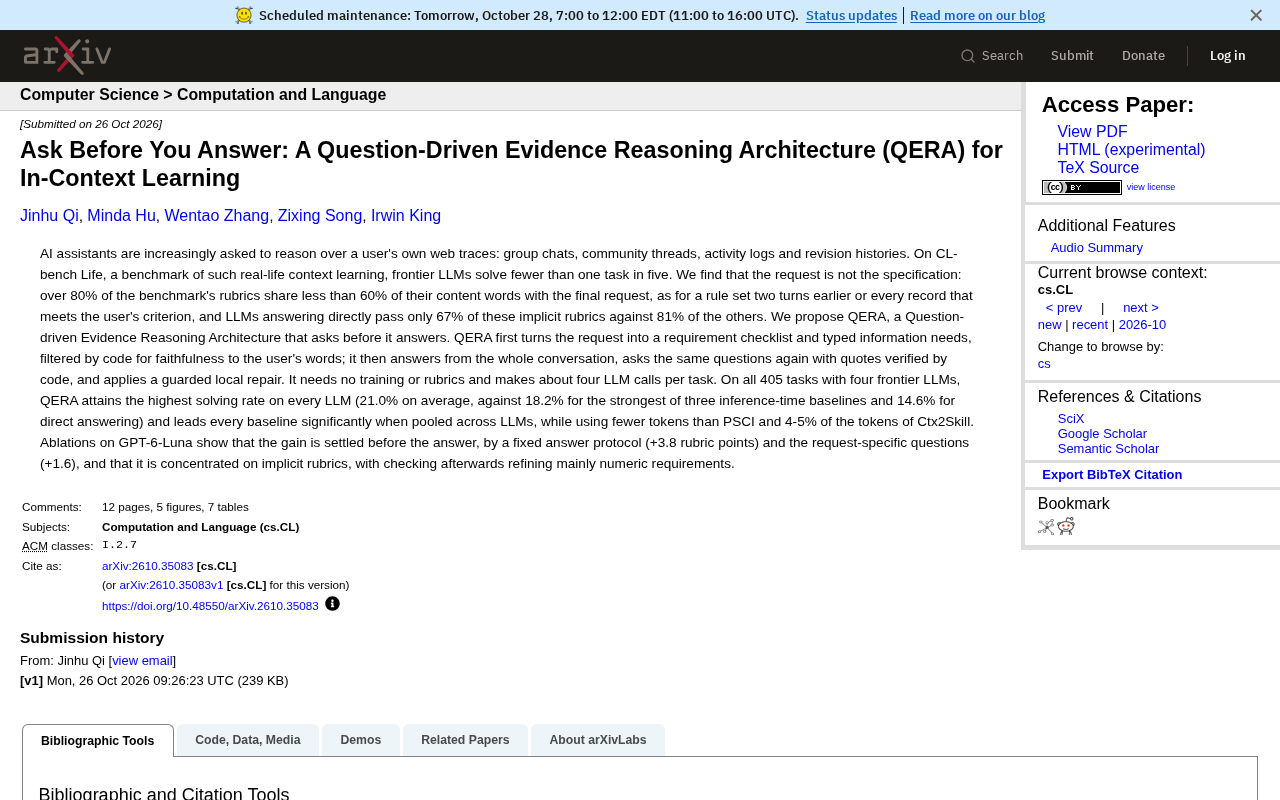
当 AI 助手需要基于用户的个人网络痕迹——群聊记录、社区帖子、活动日志、修订历史——进行推理时,它们的表现往往令人失望。在 CL-bench Life 这一评估真实生活上下文学习的基准上,前沿大模型解决的任务不足五分之一。问题出在哪里?一篇新论文给出了关键洞察:用户的请求并不等于完整的需求规格。
被忽视的隐式需求:请求之外的规则
研究者发现,在 CL-bench Life 基准中,超过 80% 的评分标准与最终请求的内容词重合度不足 60%。这意味着大量关键信息隐藏在对话历史中,而非当下这一句请求里。例如,用户可能在两轮对话前才提到一套规则,又或者期望模型找出符合其标准的所有记录——这些都没有在最终请求中明说。
数据印证了这一点:当大模型直接回答时,对隐式评分标准的通过率仅为 67%,而对显式标准的通过率则达到 81%。这近 14 个百分点的差距,揭示了当前上下文学习的一个系统性盲区——模型过于关注“问答”的即时性,而忽略了“证据”的完整性。
上下文学习(In-Context Learning) 指模型不更新参数、仅依靠提示中提供的示例或信息完成任务的学习范式。它在短提示、单轮问答中表现优异,但在长对话、多轮积累的真实场景下面临挑战:相关信息分散在历史各轮,与当前请求的语义距离远,模型容易只依据最后一轮请求作答,从而遗漏早期出现的前提条件。CL-bench Life 正是为刻画这类"长跨度、多来源、需求不完整"的真实生活场景而设计的基准,因此它暴露出的问题具有代表性,而非某个模型的偶然失误。
QERA 架构:提问先于作答
针对这一痛点,研究者提出了 QERA(Question-driven Evidence Reasoning Architecture,问题驱动的证据推理架构)。其核心思想直白却有效:在回答之前,先向上下文提问。
QERA 的工作流程分为几个关键步骤:
需求清单化:它将用户请求转化为一份需求清单和类型化的信息需求,并通过代码过滤,确保这些需求忠实于用户的原始表述——避免模型自行脑补或偏离用户意图。
全对话检索与自检:QERA 从整个对话中寻找答案,然后带着代码验证过的引文再次提出同样的问题。这种“提问-验证-再提问”的循环,确保了证据的准确性和相关性。
受保护的局部修复:在形成初步答案后,QERA 还会应用一种带防护机制的局部修复,针对性地完善回答。
整个架构无需训练,也不需要预先定义的评分标准,平均每个任务仅进行约四次 LLM 调用。
推理时基线(inference-time baselines) 指不训练模型、仅在推理阶段通过提示策略或流程编排提升表现的方法,常见的有思维链、自洽性采样、自我反思与多轮自我提问等。与 QERA 对比的 PSCI、Ctx2Skill 均属此类。它们的共同局限在于:优化重点通常是"如何更好地回答当前问题",而非"当前问题是否已涵盖全部需求"。QERA 的差异化正在于把需求识别与证据检索前置为独立阶段,而不是在生成答案后再做补救,这也解释了消融实验中收益为何集中出现在答案生成之前。
实验结果:稳定超越基线
在全部 405 个任务上,研究者用四种前沿大模型对 QERA 进行了测试。结果显示,QERA 在每一个模型上都取得了最高的解决率——平均 21.0%,而三种推理时基线中最强者的成绩为 18.2%,直接回答则为 14.6%。跨模型汇总后,QERA 显著领先所有基线。
效率方面同样可圈可点:QERA 使用的 token 数量少于 PSCI,仅为 Ctx2Skill 的 4% 到 5%。这对于实际部署意味着更低的成本和更快的响应。
消融实验进一步揭示了性能提升的来源。在 GPT-6-Luna 上的分析表明,收益在生成答案之前就已经确立:固定的回答协议贡献了 3.8 个评分点,而针对特定请求的问题贡献了 1.6 个评分点。更重要的是,这种提升集中在隐式评分标准上,事后的检查则主要精炼数值型需求。
消融实验(ablation study) 通过逐一移除或替换系统的某个组件,观察性能变化,以判断各部分的实际贡献。这里的关键在于区分"固定的回答协议"与"针对特定请求生成的问题"两类贡献:前者是通用的作答结构约束,对所有任务都起作用;后者依赖具体请求动态生成,更具针对性。结果显示前者贡献更大(3.8 个评分点),说明在长上下文任务中,一个稳定的作答与核对流程本身就能显著减少遗漏;而后者主要补足请求特有的细节。这一发现对工程实践的启示是:即便不实现完整的 QERA,为长上下文问答固定一套"先列需求、再取证据、后作答"的协议,也能获得可观收益。
启示:从“即问即答”到“先问后答”
QERA 的价值不仅在于刷榜。它指出了一个被广泛忽视的设计原则:在复杂上下文场景中,理解问题比回答问题更重要。当前的 AI 助手往往被优化为“快速响应”,但面对用户长期积累的碎片化信息时,这种模式容易漏掉关键前提。
通过将需求显式化、证据检索前置化,QERA 用极少的额外调用代价换取了更可靠的推理。对于构建个人知识助手、客服机器人或任何需要处理长对话历史的系统而言,这一思路提供了可复用的工程范式。
当然,21.0% 的绝对解决率也提醒我们,真实生活上下文学习仍是难题。但 QERA 至少证明了一件事:让模型学会“先问再答”,是通往更高准确率的一条有效路径。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
30行Python自建MCP服务器并接入Claude Code
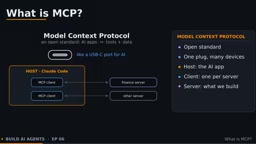
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。