企业AI安全防护指南:为什么传统防火墙保护不了你的AI
传统防火墙对AI语义层盲区的剖析,以及企业应对影子AI、Agent失控与提示词注入的分层防御框架。
本文从一个真实的行业痛点出发,揭示了传统防火墙在AI时代的根本局限:它只能检查网络层的数据包与端口,无法理解AI对话的语义内容,导致数据泄露、Agent失控和提示词注入等新型威胁完全穿透现有防线。文章梳理了企业AI应用面临的三类核心风险——员工主动将敏感数据喂给外部大模型的"影子AI"、AI Agent在错误指令下执行危险操作的权限滥用、以及利用自然语言绕过AI安全机制的提示词注入攻击。针对市场上营销话术泛滥的现状,文章给出了务实的选型维度,并介绍了正在成型的新品类"AI网关"的定位与价值。最终结论是:企业应采用技术分层防御与管理制度并行的策略,将AI安全纳入正式议程。
传统防火墙为何在AI时代失灵
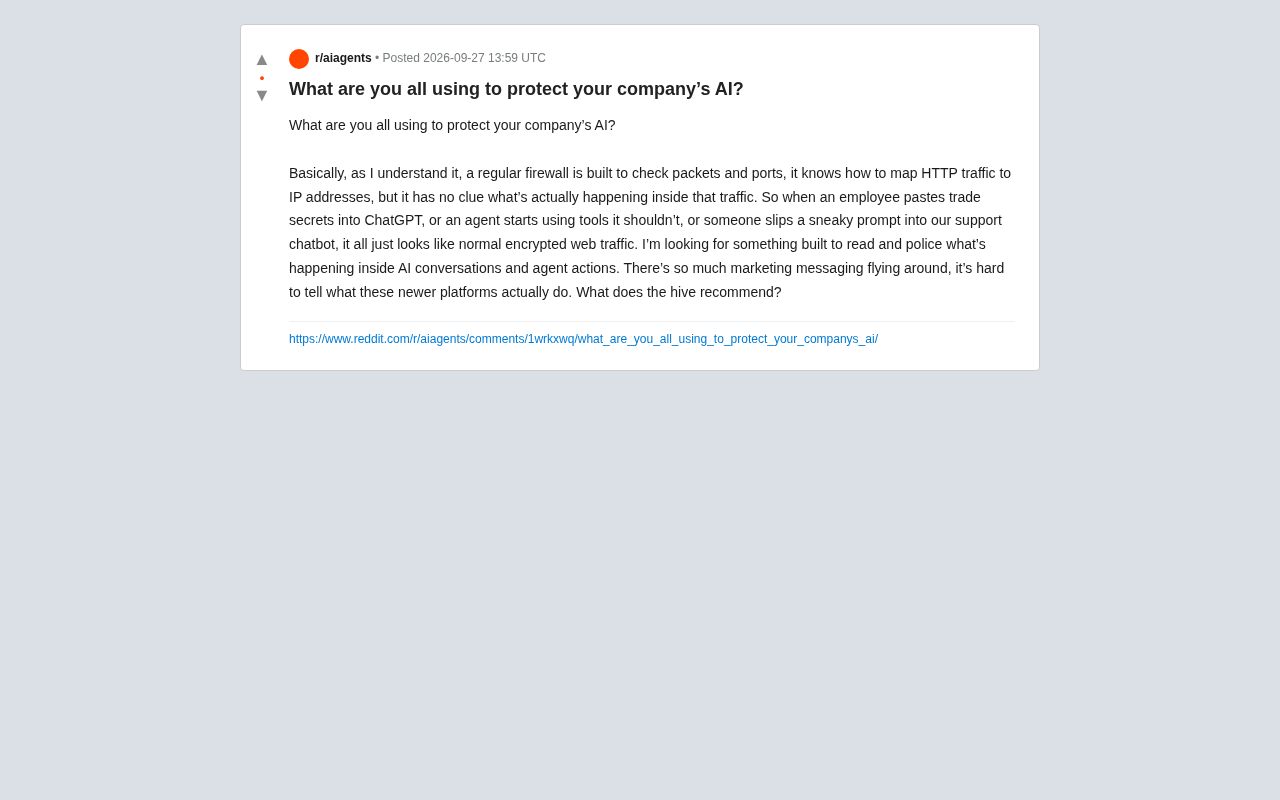
一个在Reddit上引发讨论的问题,戳中了当下企业IT安全的软肋:当员工把商业机密粘贴进ChatGPT、当AI Agent调用了不该调用的工具、当有人在客服聊天机器人里塞进一段隐蔽的提示词注入攻击时——你的传统防火墙毫无察觉。
原帖发起者一针见血地指出了问题本质:常规防火墙的设计逻辑是检查数据包和端口,它擅长把HTTP流量映射到IP地址,但它完全不知道流量内部究竟发生了什么。在它眼里,一段泄露商业机密的对话和一次正常的网页浏览,都只是「加密的Web流量」而已。
这个观察揭示了AI安全的核心矛盾:安全防护的边界正在从「网络层」向「语义层」迁移。传统安全设备关心的是「谁在和谁通信」,而AI安全需要回答的是「他们在说什么、AI在做什么」。
AI带来的三类全新安全风险
从原帖描述中,可以清晰梳理出企业AI应用面临的三大风险类型,这也是任何AI安全方案必须覆盖的场景。
数据泄露:影子AI的隐患
最普遍也最容易被忽视的,是员工把敏感信息主动喂给外部大模型。销售把客户名单粘贴进ChatGPT做总结,工程师把内部代码丢给AI助手debug,法务把合同条款交给模型润色——这些行为在员工看来是提升效率,在安全团队看来却是数据在不受控地外流。这类未经审批就使用的AI工具通常被称为「影子AI」(Shadow AI),是当前企业最直接的数据合规风险。
「影子AI」是「影子IT」概念在AI时代的延伸。影子IT泛指员工未经IT部门批准自行引入的软件或服务,而影子AI专指未经安全审查就被用于处理企业数据的AI工具——包括公共ChatGPT、各类AI写作助手或第三方插件。其危险性不仅在于数据可能被模型提供商用于训练,更在于企业对数据流向完全失去可见性,无法满足GDPR、HIPAA等合规框架对数据处理记录的要求。调查数据显示,超过60%的企业员工在使用AI工具时未向雇主报备,这意味着大多数企业的数据泄露风险敞口远比IT团队意识到的要大。
Agent失控:工具调用权限滥用
随着AI Agent的普及,风险从「说错话」升级到「做错事」。当一个Agent被赋予调用工具、访问数据库、执行操作的能力时,一旦它在错误的指令或被操纵的情况下调用了不该调用的工具,后果可能是删除数据、发送错误邮件甚至转账。这类风险的可怕之处在于,Agent的行为是动态生成的,传统的静态权限规则很难提前穷举所有场景。
提示词注入:新型攻击面
第三类是原帖提到的「有人在客服聊天机器人里塞进一段隐蔽的提示词」,也就是提示词注入攻击(Prompt Injection)。攻击者通过精心构造的输入,诱导AI模型绕过原有指令、泄露系统提示词、或执行恶意操作。这已经被OWASP列为大模型应用的头号安全威胁,且因为攻击载体是自然语言,传统的WAF规则几乎无法有效识别。
提示词注入攻击分为两种主要形式:直接注入(Direct Injection)是攻击者直接在与AI的对话框中输入恶意指令,试图覆盖系统提示词;间接注入(Indirect Injection)则更为隐蔽,攻击者将恶意指令藏在AI会读取的外部内容中——比如网页正文、上传的PDF文档或数据库记录——当Agent抓取这些内容时,就会在不知情的情况下执行嵌入其中的指令。后者对配备了联网或文件读取能力的AI Agent危害极大,因为攻击面已经从用户输入扩展到了AI能触及的一切数据源。OWASP将其列为LLM应用十大风险之首,正是因为自然语言本身既是功能载体也是攻击载体,在语义层面难以用规则穷举防御。
市场噪音下,企业该看什么
原帖作者的另一个痛点非常真实:「满天飞的营销话术,很难分辨这些新平台到底能做什么」。这正是AI安全赛道当前的现状——概念先行,大量厂商都在贴「AI安全」「AI防火墙」的标签,但实际能力参差不齐。
对于正在选型的企业,与其被营销词汇迷惑,不如回到能力本身,重点考察方案是否覆盖以下几个维度:
- 内容级检测能力:能否解密并理解AI对话的实际内容,而不只是看流量元数据。这是区分「真AI安全」和「换皮防火墙」的分水岭。
- 数据防泄漏(DLP)集成:能否识别对话中的敏感信息(PII、密钥、源代码、财务数据)并阻断或脱敏。
- Agent行为监控:能否记录和管控Agent的工具调用链路,设置可执行操作的边界。
- 提示词攻击防护:是否内置针对Prompt Injection、越狱(Jailbreak)的检测模型。
- 可观测性与审计:能否提供完整的AI使用日志,满足合规审计需求。
一个正在成型的新品类:AI Gateway
业界正在围绕这些需求形成一个新的产品品类,常被称为「AI网关」(AI Gateway)或「LLM防火墙」。它的定位类似于AI流量的中间层代理:所有进出大模型的请求都经过它,在这一层完成内容检查、敏感信息过滤、权限校验和行为审计。
这种架构的价值在于,它把安全策略从分散的应用层集中到了一个统一的控制点,既能覆盖员工使用SaaS大模型的场景,也能管控企业内部Agent的行为。相比在每个应用里各自实现安全逻辑,网关模式更易于维护和统一治理。
需要提醒的是,AI安全目前仍处于快速演进阶段,没有任何单一工具能一劳永逸。更务实的做法是分层防御:用网关做流量管控,用DLP做数据识别,用策略引擎约束Agent权限,再辅以员工培训减少「影子AI」的滋生。技术手段和管理制度双管齐下,才是当前阶段可落地的答案。
AI网关在技术实现上通常以反向代理的形式部署在应用与大模型API之间,对外暴露与原始API兼容的接口,使业务代码无需改动即可接入。核心能力模块一般包括:请求/响应的实时内容扫描(调用独立的分类模型或规则引擎)、Token级别的敏感信息检测与替换、基于角色的工具调用权限矩阵,以及完整的请求链路日志。部分产品还引入了「护栏」(Guardrails)机制,允许企业用自然语言定义策略(例如"禁止输出任何竞争对手产品名称"),由模型本身或独立分类器在运行时执行。这一架构与传统API网关(如Kong、APISIX)在流量代理思路上一脉相承,但检测层从基于规则的流量特征分析转向了语义理解,是其本质区别。
写在最后
这个来自一线从业者的提问,本质上反映了一场安全范式的转变。当AI从「工具」演变为「会自主行动的实体」,安全防护也必须从检查数据包升级到理解语义、监控行为。传统防火墙不会消失,但它需要一个懂AI的搭档。对企业而言,现在就该把「AI安全」纳入正式的技术选型议程,而不是等到第一次数据泄露事件发生之后。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。