企业级Agent落地难?三层多智能体架构破解传统Agent六大坑

传统单Agent存在六大工程化陷阱,企业级落地需转向规划、执行、校验三层多智能体架构。
文章从大模型商业落地的四个阶段(原生模型、提示工程、RAG、Agent)切入,指出Agent阶段才使大模型具备自主规划、执行与调用工具的能力。但以旅游规划Demo为例,传统单Agent暴露出六大工程化缺陷:硬编码关键词导致泛化差、工具调用代码耦合、缺乏预算约束、数据无校验导致幻觉外露、串行调用响应缓慢、单点故障引发全流程崩溃。根源在于规划、调用、校验全部耦合在一个循环中。解决方案是三层多智能体架构:规划层负责意图理解与任务拆解,执行层由并行工作的专用子Agent组成,校验层拦截幻觉与超预算结果并触发重试。文章最后给出选型建议,强调工程化能力比模型选型更关键,并引用数据显示中国企业级AI智能体市场将从2025年的212亿元增长至2029年的3300亿元。
企业级AI Agent落地常被简单Demo误导,真实业务中传统单Agent架构漏洞百出。本文从大模型商业落地四阶段出发,剖析传统Agent在幻觉、硬编码、串行调用等方面的致命缺陷,并引出三层多智能体架构的工程化必要性。
大模型商业落地四阶段:从原生模型到智能体
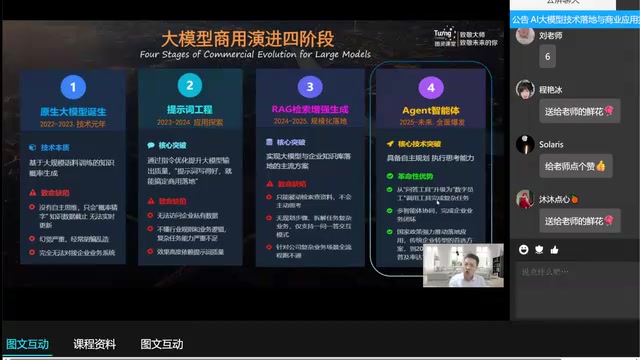
大模型的企业级应用并非一蹴而就。据B站技术分享梳理,商业落地大致经历四个阶段:原生大模型、提示工程、检索增强生成(RAG)以及智能体(Agent)全面爆发。
原生大模型依赖海量公开数据训练,能写文案、写代码,但无法自主思考,知识存在截止日期,一旦被问到训练数据之外的内容,就容易“一本正经地胡说八道”。提示工程通过优化提示词提升输出质量,却依然无法访问企业私有数据,也无法处理复杂业务流程。RAG 将企业内部的表格、文档、图片等数据存入知识库,回答前先检索,解决了私有数据访问问题,但本质上仍是被动检索、一问一答,无法主动规划复杂任务。
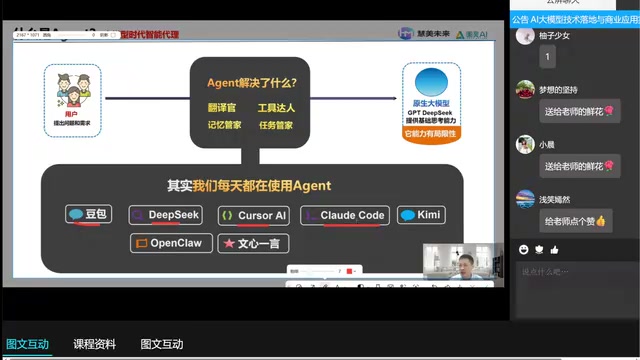
到了 Agent 阶段,大模型才真正具备自主规划、执行和调用工具的能力,从“回答问题”升级为“解决问题”。这也是当前企业数字化转型中,除 RAG 之外的重点落地方向。
传统单Agent的六大工程化陷阱
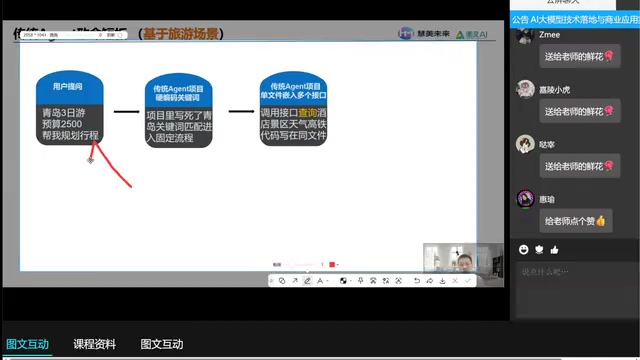
很多开发者用旅游规划场景演示Agent,看似跑通,实则埋雷。以一个“青岛三日游、预算2500元”的需求为例,传统Agent的典型实现会依次踩中以下坑:
坑一:硬编码关键词,泛化能力极差
代码中写死“青岛”二字,通过关键词匹配预设流程。用户改说“山东海边玩三天”,系统直接报错。真实企业场景中用户需求千变万化,硬编码注定无法落地。
硬编码与语义理解的区别:硬编码是指开发者将业务逻辑以固定字符串、正则或分支判断的方式直接写死在代码中,比如 if "青岛" in user_query。这种方式在输入域封闭时稳定,但一旦用户换用同义表达、方言、错别字或更抽象的描述(如“山东半岛看海”),匹配就会失效。与之相对,基于大模型语义理解的做法是将用户意图作为自然语言输入交给模型解析,输出结构化的意图和参数(如目的地、天数、预算),再由程序据此路由。语义理解牺牲了一定的确定性和延迟,但换来了对长尾表达的泛化能力,这也是多智能体架构中规划层存在的根本价值:用模型替代人工枚举规则。
坑二:工具调用逻辑塞进单个文件
为图省事,把所有接口代码写在一个文件里。改一个参数或地址,就可能引发全局崩溃。项目从1.0迭代到2.0时,维护成本急剧上升。
坑三:缺乏预算约束,成本失控
用户明确提出2500元预算,但大模型不具备成本控制意识,可能推荐高价网红酒店和餐厅,最终总花费远超预算。在企业场景中,这意味着报价错误、资源浪费。
坑四:数据真实性无校验,幻觉直接暴露给用户
Agent调用接口出错或超时后,不会做二次校验,可能编造不存在的高铁班次、餐厅或景点。旅游场景影响体验,金融、医疗场景则可能引发事故。
坑五:串行执行,响应缓慢
查询天气、酒店、美食等接口按顺序串行调用,单次调用耗时数秒,整体响应可能长达六到九秒。在高频电商咨询或客服场景中,用户体验极差。
坑六:单点故障导致全流程崩溃
任一接口超时或网络故障,整个流程直接回滚。前期消耗的大量 token 成本付诸东流,项目难以真正上线。
什么是Agent框架里的“工具调用”(Function Calling):工具调用是大模型与外部世界交互的标准化机制。开发者把可用的接口(查天气、订酒店、搜索车次)以结构化描述(名称、参数schema、用途说明)注册给模型,模型在对话中判断需要哪个工具,并输出符合schema的JSON参数,由运行时执行后把结果回灌给模型继续推理。这一机制让Agent从“只会生成文本”变为“能执行动作”。但它也带来文章提到的风险:模型可能选错工具、编造参数,或对失败结果不做校验直接采信,因此工具治理与结果校验层必不可少。
三层多智能体架构:企业级落地的工程化答案
传统单Agent的缺陷根源在于:规划、工具调用、结果校验全部耦合在一个循环里。企业级项目需要引入分层多智能体架构,将职责拆解。
通常可划分为三层:规划层负责理解用户意图、拆解任务并制定执行计划;执行层由多个专用子Agent组成,分别负责调用酒店、交通、天气等工具接口,可并行工作;校验层对执行结果做真实性、预算和一致性检查,发现异常时触发重试或降级。
这种架构带来的改变是实质性的。规划层不再硬编码关键词,而是依赖大模型的语义理解;执行层并行调用接口,显著缩短响应时间;校验层拦截幻觉和超预算结果,避免错误直接触达用户。单一接口故障也不会导致全流程崩溃,系统具备容错和恢复能力。
多智能体(Multi-Agent)与单Agent的本质差异:单Agent是在一个推理循环里完成感知、规划、调用、总结的全部步骤,上下文窗口有限、职责混杂,任何一步出错都会污染后续推理。多智能体则把任务拆给若干角色明确的Agent,每个Agent拥有独立的提示词、工具集和上下文,通过编排器(Orchestrator)或消息传递协作。其工程收益包括:可并行执行缩短延迟、单Agent失败可隔离重试、每个Agent的提示词与工具可独立测试和版本管理。代价是系统复杂度提高,需要额外的编排、状态管理和可观测性建设,这正是企业级落地需要权衡的地方。
企业级Agent的选型与落地建议
从行业分类看,Agent 大致分为公司类、角色类、工具类和行业类。公司类如车企官网的智能顾问,角色类如AI虚拟主播,工具类聚焦单一功能痛点,行业类则深入财务、电商、工业等B端全流程,开发周期长、成本高,但价值也最大。
对于传统行业企业,落地Agent时应避免直接套用Demo级代码。先梳理业务链路中的高频、规则明确、数据敏感的环节,再评估是否适合用多智能体架构承接。工程化能力——包括工具治理、校验机制、可观测性——往往比模型选型更决定项目成败。
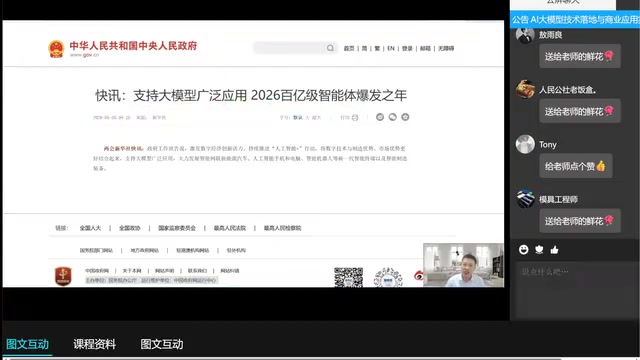
据B站分享中引用的央视报道数据,中国企业级AI智能体市场规模2025年已达212亿元,预计2026年增至449亿元,2029年有望突破3300亿元。市场在快速增长,但真正能落地的,一定是那些把工程化坑填平的项目。
可观测性在Agent系统中的含义:不同于传统服务的日志与指标,Agent系统的可观测性需要记录完整的推理链路——每一轮的输入上下文、模型输出的工具选择与参数、工具返回结果、校验层判定以及重试决策。只有这些数据被结构化留存,团队才能回答“这次为什么推荐了超预算的酒店”“这个幻觉是从哪一步引入的”这类问题。缺乏可观测性时,Agent的行为接近黑盒,故障无法复现、成本无法归因,线上调优无从下手。因此文中把它与工具治理、校验机制并列,视为决定项目成败的工程化基础能力。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。