语音智能体三明治架构实战:STT+LLM+TTS延迟优化与避坑指南

语音智能体的架构之争
构建一个真正可用的企业级语音智能体(Voice Agent),远比想象中复杂。它不仅要能听、能说,还要具备智能体(Agent)该有的循环迭代、意图识别、工具调用和上下文管理能力。而更棘手的是,这些能力之间往往存在天然的矛盾。
据B站相关技术分享的实战演示,语音智能体的底层架构目前主要可以分为三类:三明治架构、原生实时语音架构(Speech-to-Speech),以及两者融合的混合架构。本文将结合真实项目落地经验,重点剖析三明治架构的设计思路与避坑要点。
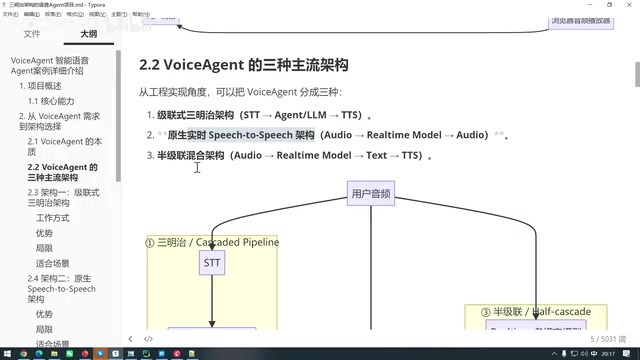
三种主流架构的本质区别
三明治架构:STT + LLM + TTS
三明治架构是目前最常见、也最务实的语音智能体方案。它的核心思路是:把一个强大的大语言推理模型(LLM)夹在中间,前面加上语音转文本(STT)模型负责识别,后面加上文本转语音(TTS)模型负责播报。
这种架构像三明治一样,把负责"思考"的智能体推理模型夹在语音输入输出之间。它最大的优势在于——你可以自由选择当前最强的推理模型作为智能体的大脑,而不必受限于模型本身是否支持语音。
原生实时语音架构(Speech-to-Speech)
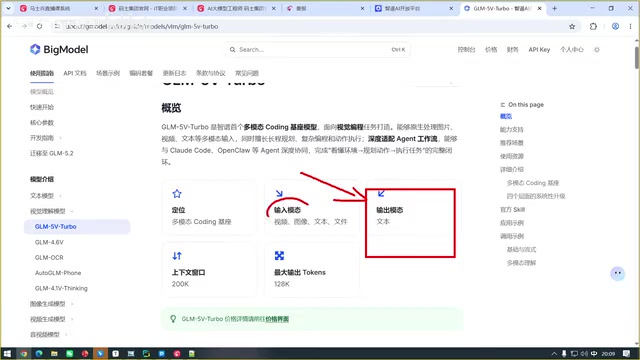
第二种是原生实时的 Speech-to-Speech 架构。它要求你找到一个能够实时进行语音交互的多模态大模型——注意,这里的关键词是"实时(real-time)"。
真正意义上的语音多模态大模型,不仅输入可以是语音、图片、文字、视频,输出也必须支持语音。这一点常被误解。很多人以为某些知名多模态模型就满足要求,但实际上它们大多是输入支持多模态、输出却只支持文本。
据分享者实测,市面上真正成熟稳定的实时语音多模态大模型,无论国内还是国外,目前几乎找不到理想的选择。
混合架构
第三种是结合了三明治与原生实时特点的混合架构,兼具两者优势,但实现复杂度也更高。
核心矛盾:实时性与智能体能力的博弈
为什么输出文本的模型无法满足需求?
这里有一个关键的判断标准:延迟性。真正专业的语音智能体,其延迟应该控制在 0.2 秒以内,让人类几乎感受不到卡顿。
如果采用输出为文本的模型(如某些 4B、24B 规格的模型),即便你在后端把文本再转成语音,整个链路的延迟也会明显被用户感知到。这正是市面上大量语音产品体验不够流畅的根本原因。
如何判断一个模型适合做智能体?
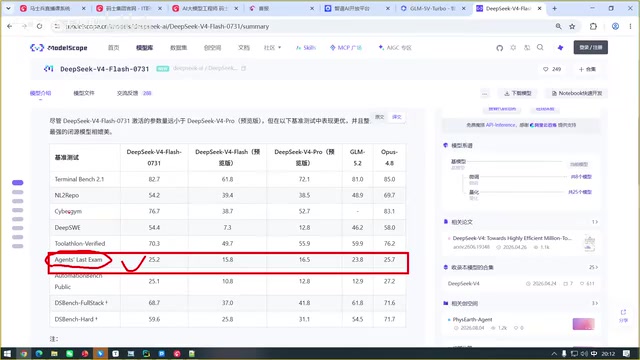
评判一个模型能否胜任智能体核心推理任务,最重要的看两个基准测试得分:
- 智能体能力(Agent)得分:衡量模型的意图识别与工具调用准确性
- Coding 能力得分:衡量模型的逻辑推理与代码生成能力
据分享内容,国内多款顶级推理模型在这两项指标上已经非常接近国际一线水平。
全模态模型的短板
你可能没注意到,某些全模态大模型虽然同时支持语音输入和语音输出,非常适合做语音交互,但它们在智能体基准测试上的得分却远远低于主流推理模型。
这就形成了一个两难困境:
- 全模态模型:语音能力强,智能体能力弱
- 顶级推理模型:智能体能力强,不支持语音
要同时满足实时性和强推理能力,几乎没有完美的现成方案。
三明治架构的落地实践
为什么选择三明治方案
面对上述矛盾,参考近期的相关论文,构建改进的三明治方案是当前最务实的路径。其核心思路是:把重心放在智能体这一端。
智能体的核心推理模型仍然采用智能体基准测试得分优异的顶级模型。这些模型只是不支持语音——那就在它前面加 STT、后面加 TTS,把它"夹"在中间。
关键难点:延迟优化方案
三明治架构最大的痛点就是实时性会下降,用户会感觉到明显的延迟。因此,能否落地成功,核心就在于能否解决延迟问题。
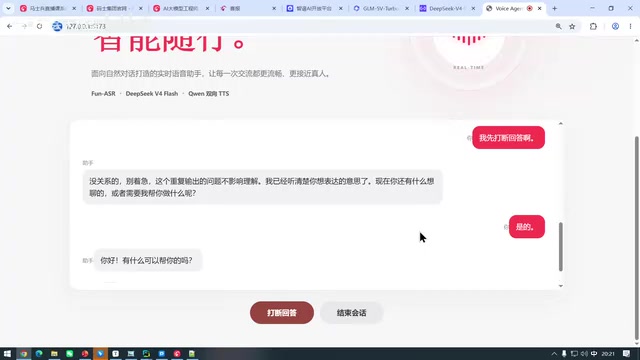
在实际演示中,该项目通过前置 STT 和后置 TTS 的精细优化,实现了大约 0.3 秒左右的响应延迟。当用户说完话后,系统几乎无需等待就能开始播报结论,实测效果相当流畅。
真实避坑经验
以下是实战中最值得注意的三个坑:
1. 播报时的打断识别问题
当系统正在朗读回复时,用户此时说话,识别效果会明显变差。这需要专门的打断(barge-in)机制来优化,确保用户可以随时中断系统播报。
2. 消息堆叠不能过于简单
Demo 中使用了非常简单的列表来做消息堆叠,但在生产环境中这样做会引发阻塞问题。上下文管理必须采用更严谨的队列或状态机设计。
3. 工具调用的稳定性
演示中查询天气的工具调用曾出现报错,说明工具调用链路的健壮性需要重点打磨,包括超时处理、重试机制和降级策略。
总结与落地建议
企业级语音智能体的落地,本质上是在实时性与智能体能力之间寻找平衡。对于绝大多数企业场景而言,三明治架构(STT + 强推理 LLM + TTS)仍是当前最务实、最可控的选择。
落地时的关键在于:
- 推理模型选择智能体基准测试得分高的顶级模型
- 把工程重心放在延迟优化上,目标做到 0.3 秒以内
- 重视打断机制、上下文管理和工具调用的健壮性
- 做好监控和降级方案,确保生产环境的稳定性
随着实时多模态大模型的成熟,未来 Speech-to-Speech 原生架构或混合架构可能会成为主流,但在此之前,扎实做好三明治架构的工程优化,才是当下最靠谱的落地路径。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。