浅层神经网络为何先学正弦分量?正交多项式动力学框架给出新解释
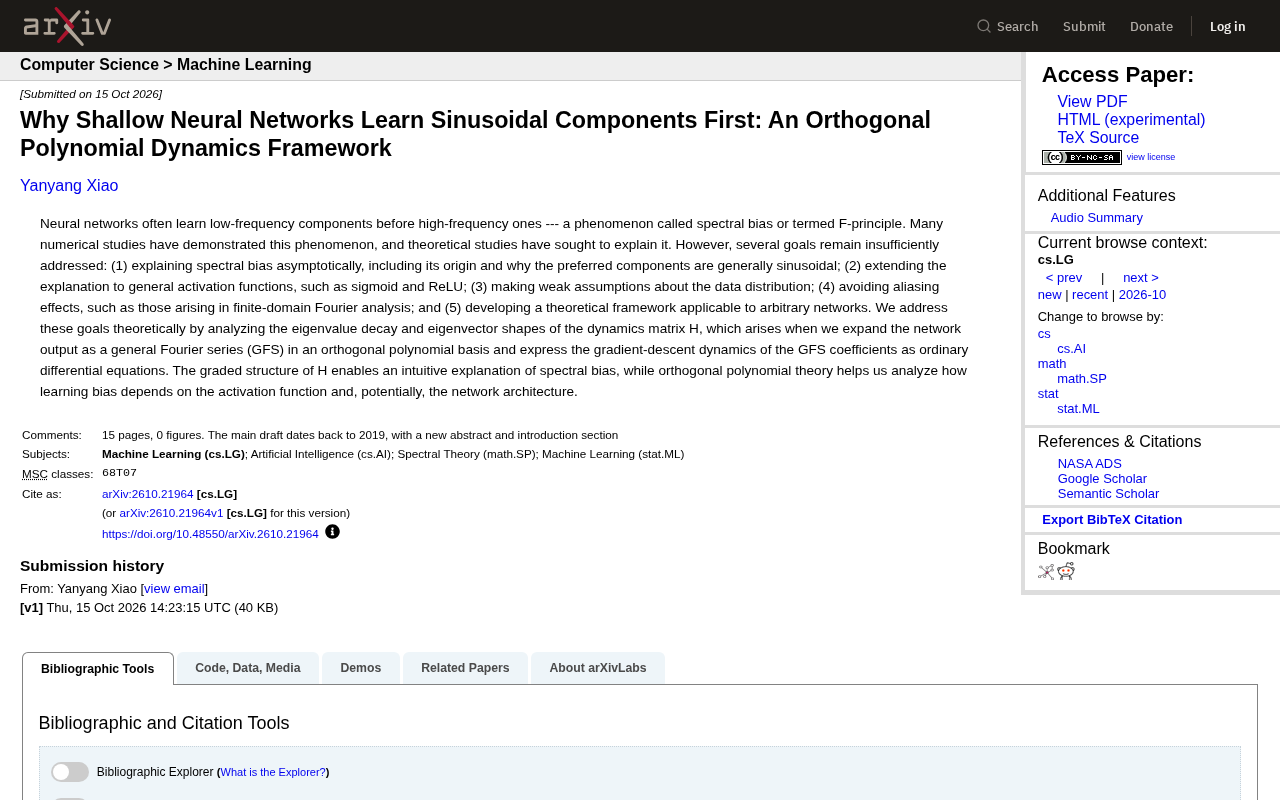
新研究用正交多项式动力学框架,从矩阵H的分级结构解释了神经网络为何先学低频正弦分量。
文章介绍了一项关于神经网络谱偏置(F-principle)的理论研究。传统解释依赖有限域傅里叶分析,存在混叠、数据分布假设强、难以推广到一般激活函数等局限。新工作将网络输出在正交多项式基下展开为广义傅里叶级数,把梯度下降对系数的演化写成常微分方程组,并构造出动力学矩阵H。H的分级结构使高频分量对应更小特征值、更慢时间尺度,从而从谱的角度解释了低频先被学到的现象,并说明激活函数通过改变H的谱结构影响学习顺序。该框架绕开混叠问题、减弱数据分布假设,可覆盖sigmoid与ReLU等一般激活函数,但向任意网络结构的推广仍待验证。
神经网络在训练时总是先学会低频、平滑的模式,再去拟合高频、剧烈的变化——这个被称作谱偏置(spectral bias)或F-principle的现象,早已被大量数值实验反复观察到。但一个更根本的问题长期悬而未决:为什么神经网络偏好的恰恰是正弦分量?又为什么不同类型的激活函数都表现出类似倾向?
一项最新的理论研究尝试从动力学角度回答这些问题。作者通过将网络输出在正交多项式基下展开为广义傅里叶级数(GFS),并把梯度下降对系数的演化写成常微分方程组,从而构造出一个可解析分析的动力学矩阵 H。整个解释框架的核心,就落在这个矩阵的特征值衰减与特征向量形状上。
谱偏置的传统解释与遗留难题
谱偏置并不是新话题。早期研究大多借助有限域上的傅里叶分析来刻画这一现象,简单直观,却带来若干难以回避的局限。论文明确列出了五个此前研究未能充分解决的目标:
- 如何渐近地解释谱偏置,包括它的起源,以及为什么被偏好的分量通常是正弦形式;
- 如何把解释推广到 sigmoid、ReLU 等一般激活函数;
- 如何对数据分布作出更弱的假设;
- 如何避免混叠效应——这在有限域傅里叶分析中几乎不可避免;
- 如何建立适用于任意网络结构的理论框架。
这些问题看似分散,实则指向同一个诉求:已有的解释更像是特定设定下的近似,而非关于学习动力学本身的统一刻画。
谱偏置与F-principle:谱偏置(spectral bias)又称F-principle(Frequency principle),指神经网络在拟合目标函数时,其输出误差在各个频率分量上的收敛速度随频率升高而系统性减慢。该现象最早由Xu等人在2019年前后通过大量数值实验系统刻画,随后Rahaman等人在2019年的工作从理论上给出了近似解释。它最直观的体现是:训练轨迹在函数空间中总是先经过低频、光滑的近似解,再逐步逼近高频、振荡的细节;即便网络有足够的容量拟合高频成分,梯度下降的动力学也会优先把低频分量压到极小误差。值得注意的是,这一偏置并非缺陷,而是理解泛化、隐式正则化以及网络为何在过参数化下仍不易过拟合的关键线索之一。
正交多项式基下的动力学矩阵 H
作者的做法是把网络输出投影到一组正交多项式基上展开。这一步替换掉了传统傅里叶分析所依赖的三角函数基,带来的直接好处是:正交多项式理论本身拥有一套成熟的逼近与谱分析工具,可以直接拿来分析学习偏置如何依赖激活函数。
在这种展开下,梯度下降对广义傅里叶级数系数的更新被写成一组常微分方程。方程中的耦合结构由一个动力学矩阵 H 描述。H 的关键性质在于它呈现分级结构(graded structure):不同频率分量对应的特征值以可预测的方式衰减。频率越高的分量,其特征值越小,对应的动力学时间尺度越慢——这正是低频先被学到的直接原因。
原文将这一结构称为"对谱偏置的直观解释",而正交多项式理论则进一步承担了分析激活函数依赖性的任务。这意味着,激活函数的选择不是无关紧要的细节,而是通过改变 H 的谱结构,直接塑造了学习过程中各分量的相对快慢。
正交多项式与广义傅里叶级数(GFS):所谓广义傅里叶级数,是指把函数按任意一组关于某权函数正交的多项式基展开,而不是仅限三角函数。常见的正交多项式系统包括勒让德(Legendre)多项式、切比雪夫(Chebyshev)多项式、埃尔米特(Hermite)多项式等。它们在加权内积下满足正交性,因此展开系数可以逐项独立计算,且截断误差具有成熟的逼近论界。相较于三角函数基,正交多项式基的一个关键优势是:它们天然定义在整个实数区间上,配合合适的权函数可以适配不同的激活函数与数据分布,从而避免把分析限制在有限域内。将网络输出写成GFS后,原本关于'频率'的讨论就被转化为关于'多项式阶数'或'谱指标'的讨论,这为把梯度下降的演化写成系数空间的常微分方程提供了便利。
分级结构(graded structure)的含义:论文中H矩阵的分级结构,是指其谱(特征值分布)随指标呈现出规律性的层次衰减。具体来说,与低频或低阶分量对应的特征向量所配的特征值较大,这些方向在梯度流下的收缩速率更快,因而被优先学习;而高频或高阶分量对应的特征值较小,其动力学时间尺度更长,需要更长的训练时间才能显著下降。这种特征值随频率单调或近乎单调衰减的模式,正是谱偏置的直接数学来源。分级结构还意味着不同分量之间存在耦合:H通常不是对角矩阵,而是近似块对角或带状矩阵,高階分量的学习会受低阶分量的残余误差影响,这为理解训练后期的精细调整提供了更丰富的图像。
相比既有框架的三个改进
这套框架的价值,可以对照前面列出的难题来评估。
其一,摆脱了有限域傅里叶分析的混叠困境。 传统做法在有限域上做傅里叶分解时,高频分量会因为采样或边界效应而与低频分量混淆,导致对"偏好哪些频率"的判断本身就可能失真。改用正交多项式基后,这一干扰来源被绕开。
其二,对数据分布的假设更弱。 论文强调其分析并不依赖对数据分布的强假设,这使得结论的适用范围更广,而不是只在特定输入分布下成立。
其三,激活函数覆盖更一般。 sigmoid 和 ReLU 这类常见但性质迥异的激活函数,都被纳入同一分析路径。这一点尤其重要——ReLU 非光滑、sigmoid 饱和,两者的谱行为差异显著,却都能被 H 的特征结构所容纳。
至于"适用于任意网络结构"这一目标,原文的表述相对谨慎:正交多项式理论"有潜力"帮助分析学习偏置如何依赖网络架构。这说明向深层或任意拓扑网络的推广,仍是这一框架需要继续验证的方向,而非已经完成的结果。
有限域傅里叶分析与混叠效应:在传统做法中,研究者通常把网络输入限制在一个有限网格或有限区间上,对网络输出离散采样后做离散傅里叶变换。这种处理会带来混叠(aliasing):当信号中存在高于采样率一半的频率成分时,它们会被错误地折叠到低频区间,导致高频与低频分量在频谱上不可区分。此外,有限域的周期性延拓还会人为引入边界处的不连续,进一步污染频谱。对于分析'网络偏好哪些频率'这一问题而言,混叠意味着观测到的频率成分可能并非网络真正学习的成分,结论的可靠性因此打折。改用定义在整个实数域上的正交多项式基后,展开不存在周期性延拓和离散采样带来的折叠问题,从而在原理上规避了这一干扰。
一个值得关注的解释视角
这项工作的意义不在于推翻了什么,而在于换了一套数学语言来描述同一个现象。傅里叶基天然适合谈论"频率",但它在有限域上的技术包袱较重;正交多项式基牺牲了一点频率直觉,换来的是更干净的谱分析和更灵活的激活函数适配性。
矩阵 H 的分级结构提供了一种可操作的直觉:学习的快慢顺序,本质上由动力学矩阵的谱决定。这也暗示,如果能够通过架构或初始化去调整 H 的谱,或许就能在一定程度上调控模型的学习顺序——这对于需要优先捕捉高频细节的任务,可能是有价值的线索。
当然,从浅层网络到任意结构的跨越,从理论刻画到实际训练中的可预测性,中间仍有相当距离。论文将自身定位为理论框架的搭建,而非工程方案,这一分寸把握是恰当的。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。