前Cursor工程师五个月实战:如何让AI Agent自动合并PR

前Cursor工程师用验证技能与三层架构约束,把对AI Agent的信任从微观管理推向PR自动合并。
前Cursor工程师Lauren分享了与AI Agent协作的方法论:核心是一条“信任曲线”——信任度越高,工程师越不需要充当验证瓶颈,其本人在12天内已合并近800个PR。实现路径分两块:一是“验证技能”,通过Chrome DevTools协议让Agent真正运行应用、抓取trace,再配合“功能地图”让Agent理解模糊报告并自主复现问题,这些技能被整理为开源插件PStack,并用Eval机制像单元测试一样持续打磨。二是“三层约束”:硬约束来自架构与CI,软约束是规则和BugBot,最差的是人肉审查,每次PR留言都应转化为硬性规则。他还指出Greenfield原型风险大于Brownfield,前期token投入换来团队整体ROI。
当一位在Cursor工作五个月的工程师醒来发现20个PR已被AI Agent自动合并,这背后是一套关于"信任曲线"的完整方法论。前Cursor工程师Lauren在B站分享了他的实践:从最初紧盯单个Agent,到如今让Agent自动合并PR,核心在于验证(Verification) 与环境约束。
从"人肉瓶颈"到"自动合并":一条信任曲线
Lauren展示了一张手绘图表:横轴是时间,纵轴是信任度,曲线与他在Cursor的贡献量呈反比——第一个月因不熟悉代码库产出极低,随着对Agent信任度提升,上个月他合并了1000个PR,本月仅12天已近800个。
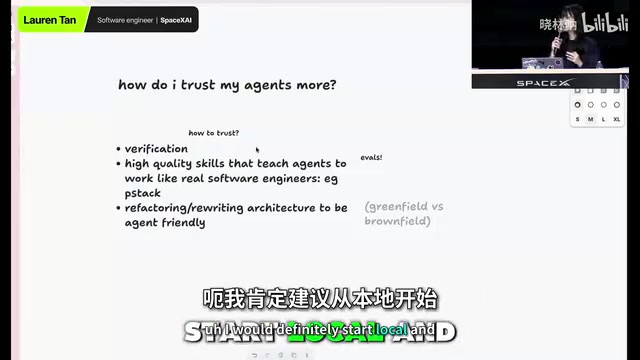
"信任"是贯穿始终的关键词。他用管理团队类比:如果不信任下属,就会陷入微观管理,花费大量时间检查每一行代码。同样,不信任Agent时,工程师只能成为验证瓶颈——Agent写代码,人打开本地环境测试,截图错误贴回去,循环往复,无法并行。
第一块拼图:验证技能让Agent自己跑起来
验证被Lauren视为与Agent协作最重要的技能。他希望Agent能真正运行代码、抓取CPU trace、打开iOS模拟器,像用户一样测试。
他举了Cursor Agent Window的例子。刚入职第一周,团队面临一周后上线的压力,他需要优化性能却对代码库一无所知。他打开Chrome DevTools抓取trace,截图发给Agent,Agent自信地指出"就是这里",但修复后问题依旧——Agent在猜测。
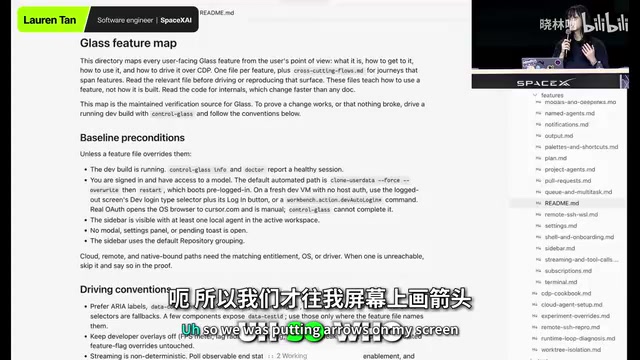
于是Lauren构建了"控制玻璃"(Control Glass)技能,让Agent能通过Chrome DevTools协议操控Electron应用并抓取trace。但新的问题出现:Agent能运行应用,却不知道"左侧边栏"在哪里,也不知道如何导航到具体功能。
这催生了"功能地图"(Feature Map)——一份教Agent如何到达所有功能的文档,包括从用户视角出发的路径、快捷键、用于CDP选择的DOM元素和属性。有了它,即使面对"???"这样的模糊用户报告,Agent也能理解上下文并自主复现问题。
Chrome DevTools 协议(CDP) 是 Chrome 浏览器对外暴露的一套基于 WebSocket 的调试接口,开发者可以通过它远程控制浏览器:启动页面、执行 JavaScript、抓取性能 trace、读取 DOM 与网络请求等。Lauren 所说的“让 Agent 通过 CDP 操控 Electron 应用”,本质上是把 Agent 接入这套接口,使它像自动化测试脚本一样点击按钮、读取状态、采集性能数据,而不是仅凭代码猜测问题所在。Electron 应用同样内置 Chromium,因此天然支持 CDP,这也是该方案能够落地的前提。
PStack:把工程品味编码成技能
Lauren将技能集合整理为开源插件PStack(名字戏仿Y Combinator CEO Garry Tan的GStack)。它的核心是增量构建:观察Agent的失败模式,每发现一个就编写一个对应技能。
比如他注意到Agent常自信地说"问题一定在这里",但查看工具调用记录后发现它根本没读相关代码。于是"How"技能诞生——强制Agent先搜索代码、使用子Agent、禁止猜测。
PStack还提供"创建验证技能"和"维护验证技能",后者依靠评估(Evals) 机制。Lauren将Eval比作Agent的单元测试:主协调Agent生成评分标准,然后生成多个子Agent在单独目录中执行任务,目录名称刻意模糊以免Agent意识到自己正在被评估,因为"Agent能察觉并改变行为"。更妙的是,Eval支持爬山算法——在Cursor中用/loop命令反复循环,直到所有评分达到10分。
爬山算法(Hill Climbing) 是一种经典的局部搜索优化方法:从当前解出发,不断尝试邻近的候选解,只保留评分更高的那个,如此迭代直到无法再改进。Lauren 把它用在 Eval 上,含义是让评分标准固定、让 Agent 反复生成新方案并保留得分更高的版本,用 /loop 命令自动循环多轮。它不保证找到全局最优,但实现简单、每轮都有可测量的提升,非常适合“让 Agent 自己把某类任务从 6 分磨到 10 分”这种场景。
三层约束:让代码库自己管住Agent
当被问及GrokBot(Cursor新发布的Agent编排应用)如何管理代码质量时,Lauren提出了三层约束模型。
硬约束来自架构。 GrokBot采用名为"Dune"的框架,被描述为"Electron版的Next.js,专为Agent编写而设计"。它强制功能代码按目录共置,禁止useEffect,甚至禁止代码注释——因为Agent会写"Lauren说不能这样做"这类无意义的历史注释。CI会检查依赖图,阻止electron main和electron renderer目录间意外导入,避免渲染线程被阻塞导致掉帧。
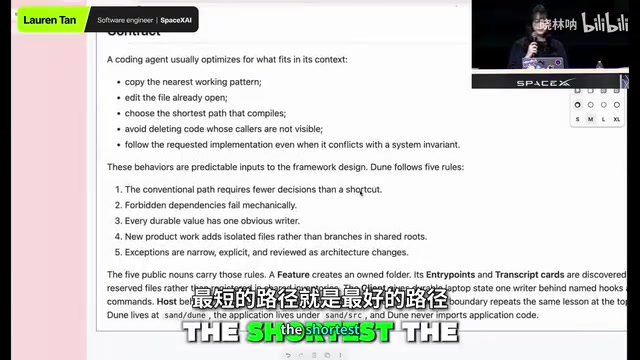
软约束是规则和提示。 BugBot在CI上运行代码审查,.cursorrules遍布各处。但Lauren强调软约束不可单独依赖:"如果你只有规则和BugBot,代码库迟早会变成垃圾。"
最差的是人肉审查。 他提出一个尖锐观点:每次在PR下留言"这里不应该这样做",都应视为代码异味。正确做法是问自己:如何把这个约束变成硬性规则?如何变成lint规则或CI失败?
共置(co-location) 指把同一功能的组件、逻辑、样式、测试放在同一个目录下,而不是按技术类型分层(如把所有组件放一处、所有 hooks 放另一处)。对 Agent 而言,共置显著降低了“找到相关代码”的成本:修改某功能时只需在一个目录内读取与编辑,减少跨目录检索和遗漏。这也是“为 Agent 编写而设计”的架构观的核心——目录结构本身就是一种约束,它让 Agent 的搜索空间更小、行为更可预测,从而在不增加人工审查的前提下提升正确率。
重构的争议:Greenfield才是最大风险
Lauren对"该不该重写"给出了反直觉判断:Brownfield应用反而更安全,因为大型科技公司的基础设施——权限限制、护栏、约定——本就为"最不熟练的工程师"设计,Agent同样受用。
真正的风险在Greenfield。完全vibe-coded的原型没有任何护栏,Agent会用最方便的方式解决问题,代码库逐渐失控。他透露自己花了超过600个PR重构GrokBot到"Dune"架构,现在已不再看代码——"我花了很多token才让代码库达到这个状态。"
成本与回报:Token不是开销,是投资
面对"普通人没有无限token"的质疑,Lauren承认在AI实验室工作有资源优势,但强调这是ROI问题。前期重构和建立约束需要大量token,但回报是团队整体效率提升——设计师、产品经理甚至GTM人员都能直接提交功能。
"agents让我能做到以前做不到的事,"他说,"我一个人不可能花几年时间构建这套框架。"他用厨师类比当前工程师角色:不再是亲自炒菜,而是设计厨房、分配任务、确保环境高效运转。
跨职能团队的新可能
话题最后转向产品团队如何跟上。Lauren认为GrokBot成了非技术人员的"Cursor时刻"——iMessage式界面、可命名的Agent、自然编排方式,让PM和设计师能以可持续的方式贡献代码。"严格约束让非工程专家也能高水平参与,"他说,"这让我非常兴奋。"
从紧盯着一个Agent到放手让20个PR自动合并,这条路没有捷径,唯有通过验证建立信任,再用架构约束固化信任。正如Lauren反复强调的:一切最终都回到信任。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。