前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构

以前端视角拆解OpenClaw:智能体=模型+规划+记忆+工具,TS可先行。
本文基于B站一场「前端全栈+AI」公开课,以现象级产品OpenClaw为样本,面向前端开发者拆解系统级AI智能体的构成。文章先给出通用公式「Agent=大模型+规划+记忆+工具调用」,并用React的UI=f(state)作类比,再将智能体分为工作流型、通用型、垂类三类。随后剖析OpenClaw的CLI、Core、Web三层架构,指出插件化(微内核)是共性设计,MCP与Skills只是不同抽象层级的变体。讲师用TypeScript实现简化版后强调,企业级真正难点在安全沙箱、长程记忆与可观测性。最后给出技术路径建议:前端应先用TypeScript打通LangChain/LangGraph,再考虑迁移Python,而Java在AI应用层位置尴尬。
B站一场公开课上,讲师连续数月围绕“前端全栈+AI”展开,这次把焦点放在了一个现象级产品OpenClaw(原名Clawdbot,后几经更名)上。与其说这是一次产品演示,不如说是一次面向前端开发者的架构拆解:系统级AI智能体到底由什么构成,前端工程师如何基于TypeScript技术栈参与甚至主导这类产品的开发。
智能体的通用公式:模型+规划+记忆+工具
讲师反复强调一个判断:不管市面上的智能体产品看起来多复杂,本质都逃不出一个公式——Agent = 大模型 + 规划(Planning)+ 记忆(Memory)+ 工具调用(Tool Use)。
这个公式的价值在于拆解认知门槛。大模型层涉及文本、图像、视频、数字人等模型选型;规划层对应ReAct等推理模式;记忆层包括上下文存储与持久化方案;工具层则延伸出MCP、Skills等标准化协议。讲师用React源码中的UI = f(state)作类比:状态驱动视图更新,正如模型驱动智能体行为。
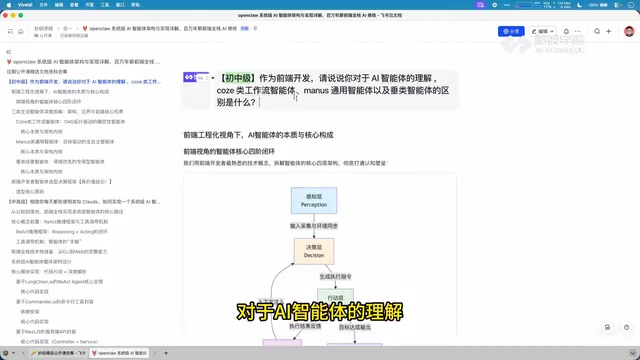
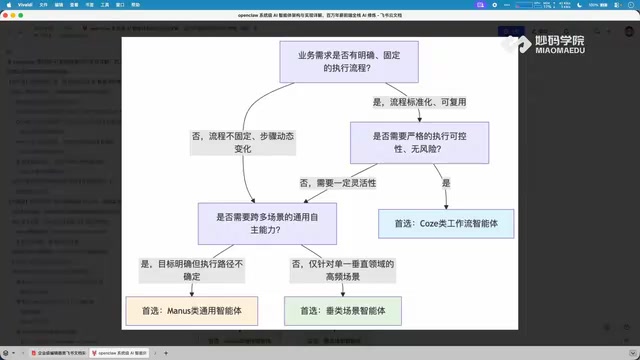
在此基础上,智能体被分为三类:工作流型智能体(基于DAG编排,如扣子/Coze式的拖拉拽节点)、通用型智能体(依赖规划能力自主拆解任务,如Manus)、垂类智能体(面向特定领域,如剪映智能剪辑、Figma AI)。面试中被问及“Codex和Manus的区别”时,回答的锚点就是这个分类框架。
ReAct 是 Reasoning + Acting 的缩写,由 Shunyu Yao 等人于 2022 年提出,是当前智能体规划层最主流的推理范式之一。它的核心思想是让大模型交替进行「思考(Thought)」和「行动(Action)」:模型先输出一段推理说明当前意图,再决定调用哪个工具、传什么参数,拿到工具返回的「观察(Observation)」后继续下一轮推理,直至任务完成。相比一次性生成完整计划再执行(如 Plan-and-Execute),ReAct 是边想边做、根据反馈动态调整,因此更适合工具调用频繁、环境不确定性高的场景。LangChain 中的 AgentExecutor、LangGraph 中的 ReAct 预置图都是这一范式的工程实现。理解 ReAct 有助于把握「规划层」到底在做什么——它并非让模型凭空拆解任务,而是把推理与工具反馈编织成一个可循环、可中断、可观测的执行链路。
MCP(Model Context Protocol) 由 Anthropic 于 2024 年底开源,定位是「模型与外部数据源、工具之间的统一通信协议」。在 MCP 出现之前,每接一个工具(数据库、文件系统、第三方 API)往往要写一套定制适配代码,工具数量一多便形成 M×N 的适配爆炸。MCP 采用客户端-服务端模型:工具提供方实现一个 MCP Server 暴露能力(resources、tools、prompts),智能体侧实现 MCP Client 按统一协议发现并调用,从而把适配成本降为 M×1+N×1。它常被类比为「AI 时代的 USB-C」或「工具领域的 LSP(Language Server Protocol)」。与 Skills 相比,MCP 更偏底层通信与能力发现,Skills 更偏面向具体任务的高层能力封装,两者可叠加使用——Skills 内部完全可以通过 MCP 调用外部工具。
系统级智能体的三层架构
以OpenClaw广告为参照,讲师给出了一个清晰的分层:CLI命令行层、Core核心引擎层、Web界面层。CLI层用Commander封装onboard和dashboard等命令,负责服务启动与初始化;Core层是智能体调度中心,基于LangChain引入模型、注册工具插件、执行推理循环;Web层基于Next.js,通过HTTP与WebSocket和服务端通信。
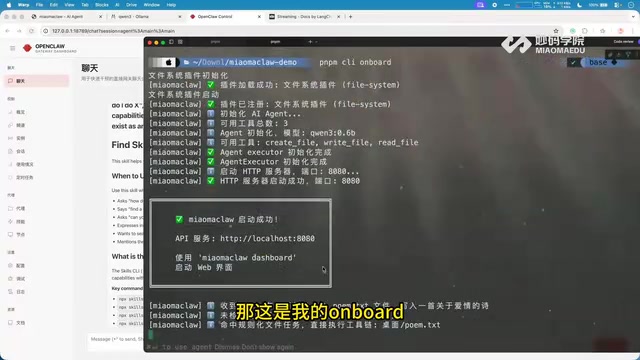
你可能没注意到插件化设计。讲师展示了file-system插件集——包含createFile、readFile、writeFile等工具,通过插件扫描器动态注册。他认为这与Webpack、Vite的插件机制同源,都是微内核思想的体现。Skills和MCP在他看来不过是插件化在不同抽象层级上的变体:MCP是工具与数据源的统一通信协议,Skills则是更高层次的能力单元封装,二者都服务于同一件事——让模型知道“有什么工具可用、怎么调用”。
从0到1实现的难点:安全与记忆
讲师用TypeScript完整实现了一个简化版OpenClaw,并指出真正企业级落地的门槛不在功能,而在几个容易被忽视的层面。安全层首当其冲:rm -rf /这类命令必须在沙箱中拦截。记忆层则需要向量存储与长程记忆持久化,否则智能体无法跨会话保持上下文。此外还有可观测性、多模态感知(视觉文档解析)等工程问题。
在模型选择上,讲师演示了用Ollama拉取千问3.5-Cloud模型(免费云端推理)驱动整个流程:让智能体写一首仿李白的诗并保存到桌面,再基于该文件生成分章节的教学课件。整个过程通过聊天指令触发文件创建、内容写入、目录组织等操作,验证了“模型决策→工具执行→结果校验”的闭环。
长程记忆(Long-term Memory) 与普通对话上下文的关键区别在于是否跨会话、是否可检索。上下文窗口内的历史会随会话结束而丢失,且受 token 上限约束;长程记忆则把重要信息抽取后写入外部存储,在需要时按相关性召回。常见实现是向量数据库(如 pgvector、Milvus、Qdrant):把文本经嵌入模型转为向量,检索时用近似最近邻(ANN)算法找出语义相近的片段,再拼回提示词。工程上还需处理记忆的写入策略(什么值得记)、去重与更新(同一事实变化后如何覆盖)、分层(短期工作记忆 vs 长期事实记忆)以及遗忘机制。这也是为什么讲师强调记忆层是企业级落地的门槛——它决定了智能体能否「越用越懂你」,而不只是单轮问答的工具调用器。
前端切入AI的技术路径选择
讲师给前端开发者的建议相当明确:先用TypeScript打通,再考虑Python。理由是LangChain和LangGraph都有TS版本,概念体系一致,前端已有的工程化经验(插件化、微内核、状态管理)可以直接迁移。等业务逻辑吃透后换语言只是语法层面的成本。
反观Java在AI应用开发中的位置,他认为较为尴尬:Spring AI、LangChain4j等框架更新滞后,很多公司里Java层逐渐退化为BFF中间层,底层调用Python脚本。对于前端而言,Node.js BFF + TS智能体引擎 + Next.js界面是一条成本可控的进阶路线。
配图说明:文中截图来自B站公开课演示画面,分别对应智能体架构讲解、CLI启动流程与项目代码结构。
相关推荐

WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。

Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。

提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。