前OpenAI研究员发现开源模型暗藏Blackwell签名

前OpenAI研究员在开源权重模型中发现Blackwell签名,引发对硬件耦合与透明度的担忧。
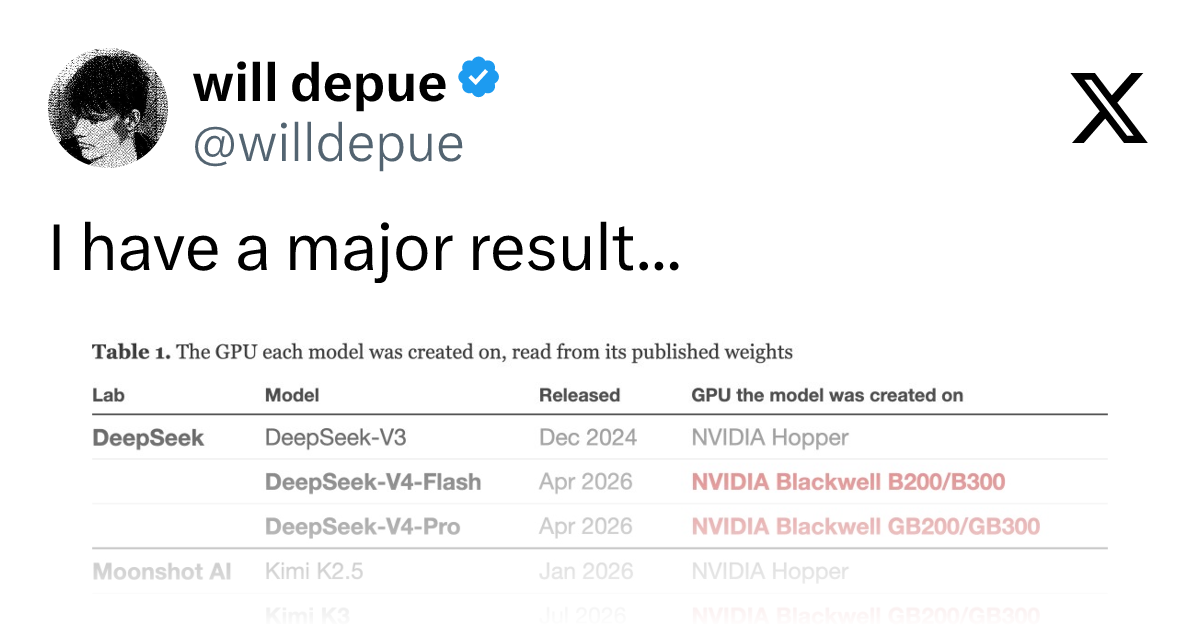
一位前OpenAI研究员在开源权重模型中发现与英伟达Blackwell架构相关的“签名”,事件在Hacker News上引发关注。目前细节有限,尚不能判断签名是刻意植入还是训练工具链留下的元数据或算子特征。文章分析了签名可能带来的两层疑问:模型是否针对特定硬件做了未公开优化或限制,以及是否影响模型在其他硬件上的可移植性。开源社区对隐性硬件绑定容忍度低,该发现可能推高模型审计成本。后续需关注签名是否可复现、模型发布方是否回应以及工具链层面能否给出解释。
一起不寻常的发现
一位前OpenAI研究员在开源权重模型中发现了所谓“Blackwell签名”。这个发现之所以值得关注,不仅因为它涉及英伟达当前一代GPU架构Blackwell,更因为它暗示开源模型与特定硬件之间可能存在比公开信息更深的联系。
据Hacker News上的讨论,这条消息由该研究员发布后迅速引发关注。虽然目前可获取的细节有限——原始帖子仅给出了要点和少量评论,但“Blackwell签名”这一表述本身已经足以让从业者警觉:开源模型里为什么会出现与硬件架构相关的标记?
什么是“签名”,为什么重要
在模型文件中出现硬件名称并不必然意味着后门或隐藏功能。更常见的情况是,签名可能来自训练基础设施的痕迹:模型在Blackwell架构的GPU集群上完成训练或微调,工具链在权重文件中留下了可识别的元数据、编译标记或算子特征。
但问题在于,开源权重模型通常被期望是“干净”的——用户可以自由检查、复现和部署。如果权重中携带了与特定硬件绑定的签名,至少带来两个层面的疑问:其一,模型是否针对特定硬件做了未公开的优化或限制;其二,这种签名是否会影响模型在其他硬件上的行为与可移植性。
从现有信息看,尚不能断定这是刻意植入还是工具链的自然产物。Hacker News上仅有的一条评论也未提供明确方向,这恰恰说明该发现仍处于早期讨论阶段。
开源权重模型指模型架构和训练后的参数(权重)以允许自由使用、修改和再分发的方式公开发布,典型例子包括 Llama 系列、Mistral 以及部分 Qwen 模型。与之相对的是仅提供 API 的闭源模型。开源权重的关键承诺是透明性:研究者可以下载权重、检查文件结构、在本地或私有云上复现推理,甚至继续微调。但“开源权重”并不等同于“开源训练数据”或“开源训练代码”,权重文件中往往包含大量由训练框架自动写入的元数据,普通用户很少逐项审查,这为硬件签名之类的痕迹提供了藏身空间。
Blackwell 是英伟达在 2024 年发布的 GPU 架构,接替 Hopper 架构,主打大模型训练与推理场景。不同 GPU 架构在指令集、张量核心特性和内存层次上存在差异,因此训练框架和算子库(如 CUDA、cuBLAS、TensorRT-LLM)通常会针对特定架构编译或优化算子。当模型在 Blackwell 集群上训练或微调时,工具链可能在权重文件中留下架构相关的编译标记、算子版本号或序列化元数据,这类痕迹即为“签名”的可能来源之一。
对开源生态的潜在影响
开源权重模型的核心价值在于透明与可复现。一旦“硬件签名”成为普遍现象,开源社区对模型的审计成本会上升:用户不仅需要检查模型行为,还需要理解权重文件中每一类元数据的来源。
另一个值得关注的维度是硬件厂商与模型开发者之间的关系。如果签名确实指向Blackwell,那么它可能反映出模型在训练阶段与特定GPU架构的深度耦合。这种耦合在商业闭源模型中很常见,但在开源模型中会被放大讨论,因为开源社区对“隐性绑定”的容忍度更低。
目前这一事件仍缺少可验证的技术细节,包括签名出现在哪些模型、以何种形式存在、是否可被移除。在更多信息披露之前,理性的态度是把它视为一个需要持续观察的信号,而不是立即下结论。
可移植性在机器学习语境下指同一个模型权重能否在不同硬件(如英伟达、AMD、苹果芯片或国产加速卡)上以相近的性能和精度运行。理想情况下,权重是硬件无关的数值张量,推理框架负责将其映射到目标硬件。但若权重中嵌入了针对特定架构的算子特征或编译产物,模型在其他硬件上可能触发回退路径、精度差异甚至加载失败。对于需要跨平台部署的团队,这种隐性耦合会增加适配成本,也是开源社区对硬件签名敏感的重要原因。
接下来该关注什么
第一,看是否有人复现该发现。开源模型的好处是可被独立验证,如果多位研究者能在不同模型中观察到类似签名,事件性质会发生变化。第二,看模型发布方是否回应。沉默或模糊回应都可能加剧社区疑虑。第三,看工具链层面是否有解释——如果签名来自训练框架的默认行为,那么问题就从“隐藏功能”转向“元数据规范”。
对使用开源模型的团队来说,短期内不必过度反应,但可以把权重文件的元数据检查纳入常规流程。这类检查成本不高,却能在类似事件中提供第一手判断依据。
相关推荐
《谢谢你的爱》英文版走红B站:经典情歌的跨文化演绎
B站热传的《谢谢你的爱》英文版《I'll give you all my love》,通过重新填词诠释“给予全部的爱”的主题。本文分析其歌词情感表达、跨文化改编策略以及与中文原版的情感逻辑差异,探讨经典华语歌曲英文改编的传播价值。
Claude Code vs Cursor vs GitHub Copilot:三大AI编程工具怎么选
用「放权程度」一个维度讲清 Claude Code、Cursor 与 GitHub Copilot 的区别:Copilot 嵌入现有编辑器做补全,Cursor 是以AI为核心的完整编辑器并支持多文件批量修改,Claude Code 在终端里端到端执行任务。附选择建议。
动态漫解说爆款背后:家庭财务与情感冲突的叙事拆解
从B站动态漫《CC-动态漫》的一集家庭财务冲突剧情出发,拆解动态漫如何用高密度对话和情绪钩子抓住观众,并分析AI辅助脚本生成在叙事连贯性上的短板与人工把关的价值。