强化学习环境本质之争:PDF也能当RL环境?

“每个RL环境都是PDF环境”的调侃揭示RL环境本质是状态-动作-奖励闭环而非物理仿真。
文章从Twitter上一句调侃“Every RL environment is just a PDF environment if you're brave enough”出发,探讨强化学习环境设计的边界问题。作者指出,传统RL环境依赖游戏模拟器或机器人仿真器,但PDF文档同样可以被建模为环境:状态是已读内容与查询上下文,动作是翻页或检索,奖励来自答案准确性。这揭示RL环境的核心不是物理仿真,而是状态-动作-奖励闭环的定义。文章进一步分析近两年“去模拟器化”趋势——用LLM生成任务、评估结果,将文档、网页等静态信息源包装为可交互环境,从而大幅降低构建成本,但也带来奖励噪声和状态稀疏的挑战。最后,作者建议团队重新审视静态数据资产能否封装为可训练环境。
一句调侃背后的RL环境设计哲学
最近,Twitter上流传着一句颇具玩味的调侃:“Every RL environment is just a PDF environment if you're brave enough.”(只要你够胆,每个强化学习环境都不过是PDF环境。)
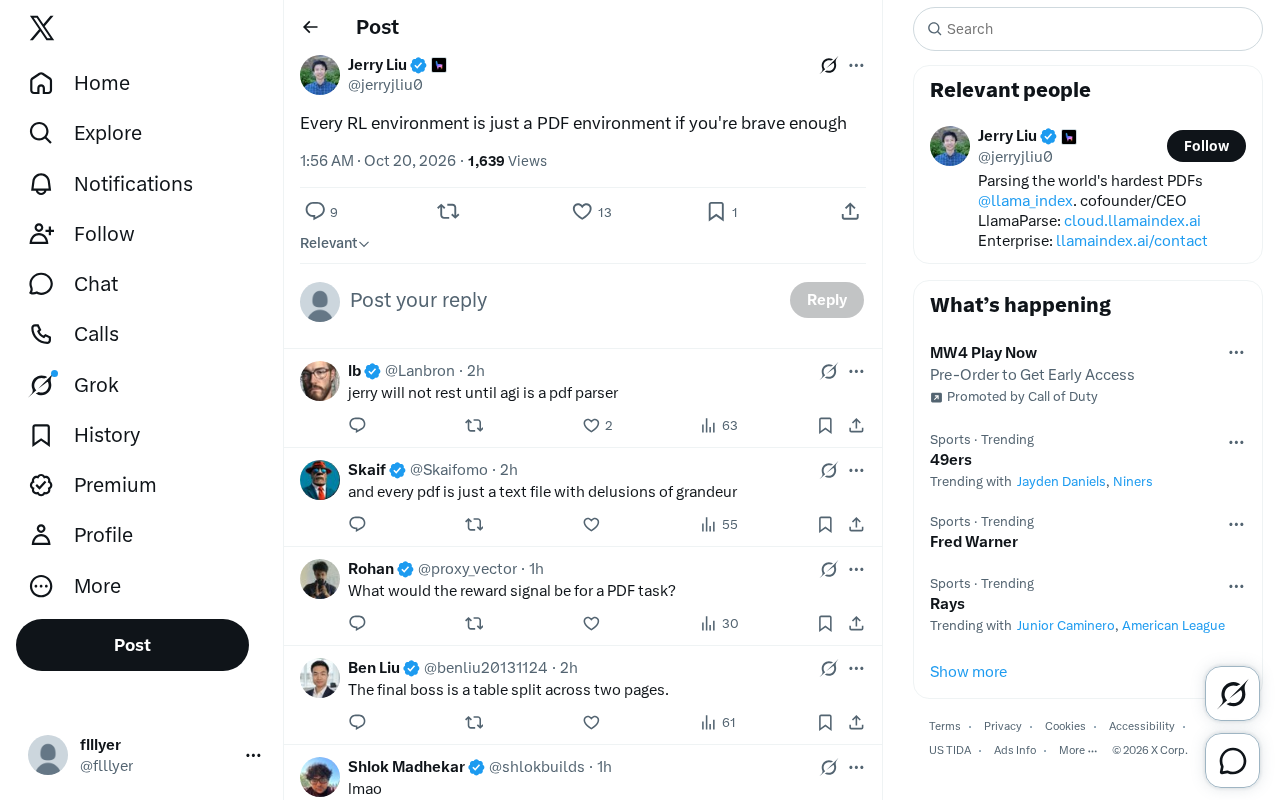
这句话乍看是个技术圈的玩笑,但它精准戳中了强化学习(RL)研究中的一个真实痛点:环境的设计与抽象边界到底在哪里?当我们把PDF文档也视为一种可交互的环境时,RL的适用边界就被重新定义了。
为什么“PDF环境”这个说法值得认真对待
在传统RL研究中,环境通常指游戏模拟器、机器人仿真器或交易市场回测系统。这些环境具备明确的状态转移、动作空间和奖励信号。而PDF文档看似静态,不具备这些特征——但换个角度,它完全可以被建模为环境。
想象一个文档问答智能体:状态是当前已读取的页面内容和查询上下文,动作是翻页、检索关键词或提取段落,奖励则来自答案的准确性。这样一来,PDF就不再是“数据”,而是“环境”。
这个思路并非文字游戏。它揭示了一个更深层的趋势:RL环境的核心不是物理仿真,而是状态-动作-奖励的闭环定义。只要你能定义这个闭环,任何信息源都可以成为环境。
在强化学习中,一个环境通常用马尔可夫决策过程(MDP)来形式化描述:状态空间 (\mathcal{S}) 表示所有可能的世界状态,动作空间 (\mathcal{A}) 表示智能体可执行的操作,转移函数 (P(s'|s,a)) 定义状态如何随动作演化,奖励函数 (R(s,a)) 给出即时反馈信号。PDF环境之所以成立,正是因为我们可以为文档问答任务定义这四元组:状态是已读页面与查询的组合,动作是翻页或检索,转移由文档结构决定(如翻页后进入下一页),奖励则来自答案正确性。即便转移是确定性的(翻页必然到下一页),它依然满足MDP框架,因此可以用RL算法训练。这解释了为什么“静态文档”并不妨碍它成为环境——关键在于闭环是否可定义,而非世界是否动态。
环境抽象层正在被重新思考
近两年,围绕RL环境的研究出现了明显的“去模拟器化”倾向。一方面,语言模型本身开始被用作环境的一部分——用LLM生成任务、评估结果甚至模拟用户反馈;另一方面,研究者开始把文档、网页、数据库等静态信息源包装成可交互环境。
这种转变带来两个直接后果。第一,环境的构建成本大幅下降。过去搭建一个仿真环境需要数周工程量,现在一个结构化的文档集合加上合理的动作接口,就可能形成一个可训练的环境。第二,评估的可靠性面临新挑战——PDF环境的状态空间本质上是离散且巨大的,奖励信号也往往依赖LLM判断,噪声更大。
“去模拟器化”背后有一个关键技术支撑:大语言模型(LLM)作为环境组件。传统仿真器需要手工编写物理规则或游戏逻辑,而LLM可以扮演三个角色:任务生成器(自动产出多样化的查询)、环境模拟器(根据动作返回合理的文本反馈)和奖励评判器(评估答案质量并给出分数)。这种范式被称为LLM-as-a-judge或LLM-in-the-loop,它让非结构化信息源(如PDF)也能提供可用的奖励信号。但代价是奖励的确定性和可复现性下降——同一个答案在不同提示或采样下可能得到不同评分,这给训练稳定性带来挑战,也是当前研究的热点问题。
勇敢者的游戏:边界与风险
“If you're brave enough”这半句并非纯粹的幽默。把PDF当作RL环境,意味着你要接受几个现实:
- 状态表示极其稀疏,智能体可能在大量无关文本中迷失;
- 奖励信号难以做到确定性,需要引入启发式或模型评判;
- 环境的重置和轨迹采样成本高于传统仿真器。
但反过来看,这也正是其价值所在——它迫使研究者直面真实信息环境的复杂性,而不是在干净的仿真器中刷分。
状态稀疏性是PDF环境最直接的工程难题。在传统仿真器中,状态向量通常低维且连续,智能体容易探索;而PDF环境的状态本质上是高维离散的文本片段组合,大部分状态对任务目标没有信息增益。这会导致探索效率极低,智能体容易陷入“翻页循环”或“无关段落”。常见的缓解手段包括:引入检索模块先缩小候选范围、使用课程学习从短文档逐步过渡到长文档、以及设计中间奖励(如每检索到相关段落给予小额奖励)。这些技巧本质上是在稀疏奖励空间中人为构造稠密信号,属于RL工程中的奖励塑形(reward shaping)范畴。
对RL工程实践的启示
这句话在Twitter上引发讨论,本质上反映的是社区对“环境即接口”这一理念的认同。对于做RL应用落地的团队来说,值得重新审视自己手中的数据资产:那些被当作静态语料的PDF、网页和知识库,是否可以被重新封装为环境,用于训练和评估智能体?
答案取决于你是否愿意接受不完美的奖励信号和稀疏的状态空间。但至少,这句调侃提供了一个有价值的思考起点:RL环境的本质,是交互协议,而非物理世界。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。