清华博士后亲述:AI算法工程师的自学路线与工程化思维

清华博士后王书浩指出AI落地关键在于工程能力而非数学理论,并给出自学路线。
文章介绍清华大学交叉信息研究院博士后王书浩主讲的AI算法工程师自学路线课程。针对“学完深度学习却做不出AI系统”的普遍痛点,王书浩结合自己在清华、百度、京东及病理AI创业公司的学术与产业经历,指出学术模型与产业模型存在巨大鸿沟:论文模型多为单中心小规模测试,而产业级模型要求多中心验证、接近100%的敏感度、快速推理、容灾与可扩展性。他由此提出AI的本质是计算机科学而非数学理论,编程能力是入门前提,自学应兼顾理论深度与工程能力,并说明了课程的适用人群与核心方法论。
为什么你学了深度学习却依然做不出AI系统?
在B站上,一门由清华大学交叉信息研究院博士后王书浩主讲的AI算法工程师自学路线课程引发了广泛关注。与市面上大量堆砌公式的教程不同,这门课程的核心观点直指一个普遍痛点:很多人学完了深度学习,却依然无法将AI真正落地。
王书浩在课程开篇就抛出了一个尖锐的观察:不少求职者只跑过MNIST这样的入门级实验,就自认为基础扎实,但一旦被问到更深入的模型问题或简单的工程化问题,便立刻暴露出短板。据他在课程中的分享,这种现象在AI招聘中相当普遍,折射出自学路径中“重理论、轻工程”的结构性缺陷。
主讲人背景:从清华实验室到产业一线
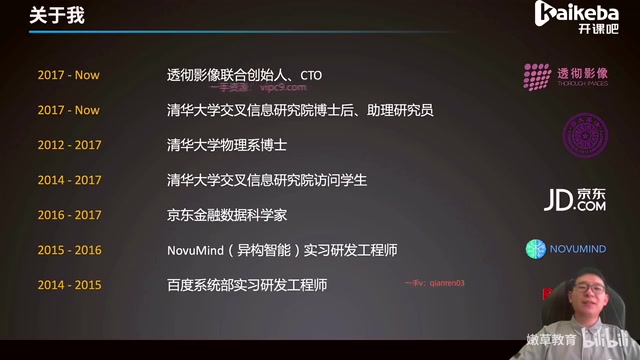
王书浩的履历本身就是一条“学术+产业”双螺旋的成长路径。他是清华大学物理系博士,读博期间第二年就达到毕业要求,后三年半的时间里先后在清华大学交叉信息研究院做访问学生、在百度系统部担任实习研发工程师,参与智能数据中心项目,用AI方法进行电力优化。2015年,他受百度科学家吴韧邀请加入硅谷AI解决方案公司Ego智能(中文名“一哥智能”),总部位于Santa Clara,紧邻英特尔、高通和Google。
回国后,他加入京东金融(现京东数科)担任数据科学家,首次将循环神经网络应用于欺诈检测领域,相关代码至今仍在京东运行,并被多家国内外电商公司借鉴。博士毕业后,他回到清华交叉信息研究院做博士后助理研究员,主攻医疗人工智能,并联合创立了病理AI公司“透彻影像”。
这段横跨学术与产业的经历,构成了课程最独特的价值:他教的不只是知识,更是一套被多个成功项目验证过的方法论。
学术模型与产业模型的鸿沟在哪里?
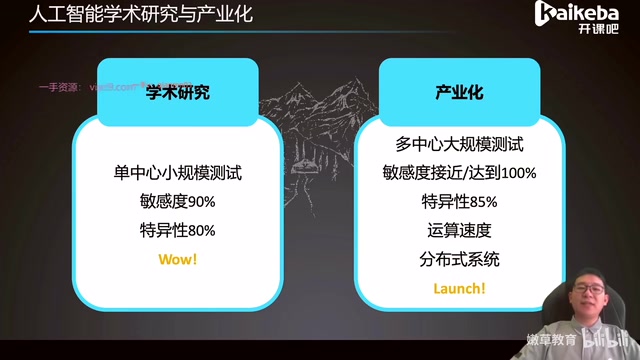
课程中最有洞见的部分,是对“论文模型”和“产业模型”的对比分析。王书浩指出,学术研究通常是单中心、小规模测试,敏感度可能只有90%、特异性不足80%,这样的模型发论文没问题,但用于临床实践非常危险——90%的敏感度意味着漏掉10%的阳性患者。
产业级模型的要求完全不同:需要多中心大规模测试,敏感度要接近甚至达到100%,特异性也要达到85%左右,既要避免漏诊,又要控制假阳性。除此之外,系统层面的要求同样苛刻:运算速度要足够快,否则在实时场景中毫无用途;系统要具备鲁棒性,某个节点挂掉后能自动恢复;还要可规模化,用户从一百万增长到两百万时,仅靠扩容服务器就能平稳承载。
这些要求指向一个结论:AI系统的基础不是数学理论,而是计算机科学。 王书浩在课程中反复强调,人工智能本质上是一个实践学科,是计算机科学的一部分。数学是工具,论文是参考,但真正的根基在于编程能力和工程思维。
敏感度与特异性是评估分类模型(尤其是医疗诊断模型)性能的两个核心指标。敏感度(Sensitivity)又称召回率,指实际阳性样本中被正确识别为阳性的比例,衡量模型“不漏诊”的能力;特异性(Specificity)指实际阴性样本中被正确识别为阴性的比例,衡量模型“不误诊”的能力。两者通常存在权衡关系:提高敏感度往往以降低特异性为代价。在临床场景中,漏诊(假阴性)的代价远高于误诊(假阳性),因此产业级模型会优先将敏感度推向接近100%,同时通过多中心大规模数据训练和阈值调优,尽量维持85%左右的特异性,从而在安全性与可用性之间取得平衡。
多中心测试指模型在来自不同医院、不同设备、不同人群分布的数据集上进行验证,而非仅在单一机构的小规模数据上评估。单中心测试容易因数据分布单一而高估模型泛化能力,多中心测试则能暴露模型在真实世界数据异质性下的性能衰减,是医疗AI从论文走向临床的必经环节。
自学AI的正确路径:理论深度与工程能力并重
基于上述判断,课程给出了自学者需要关注的两个维度。
理论层面:不止于“知道结构”
学习一个网络,不能停留在知道它长什么样的浅层。需要理解它的具体结构、参数数量如何计算、代码如何实现,甚至能够自己构造新的网络结构。这要求对网络本身有深入理解,同时具备相应的代码水平。
实践层面:用工程眼光看待AI
不要把AI当作数学理论来学。王书浩建议学习者走出“跑通一个demo就等于学会”的误区,去理解一个完整AI系统所需的全部知识:推理速度优化、分布式架构、容灾设计、可扩展性等。这些内容在传统课程中往往被忽略,却是产业落地的关键。
他还特别肯定了“先打好编程基础,再学人工智能”的路径。相比直接啃深度学习框架,具备扎实程序设计能力的学习者在理解模型实现、调试工程问题时优势明显。这也解释了为什么计算机专业背景的人在AI工程化岗位上往往后劲更足。
容灾设计(Disaster Recovery)与可扩展性(Scalability)是AI系统从实验室走向生产环境的两项关键工程能力。容灾设计指系统在部分节点、服务或数据中心发生故障时,仍能通过冗余部署、故障转移、自动恢复等机制维持服务可用性,避免单点故障导致整体瘫痪。对于实时推理系统而言,一次宕机可能意味着业务中断和用户流失。可扩展性则指系统在用户量或请求量增长时,能够通过水平扩容(增加服务器节点)而非重构架构来平稳承载负载。这两项能力与推理速度优化、分布式架构共同构成了产业级AI系统的工程底座,也是传统深度学习课程几乎不会涉及的内容。
这门课适合谁?
从课程定位来看,它适合三类人:一是零基础但希望系统入门AI的转行者,课程强调的编程先行理念能帮他们避开“空中楼阁”式的学习;二是已经学过深度学习但缺乏工程经验的学生,课程中关于产业模型要求的讨论能补齐认知短板;三是准备求职AI算法岗位的候选人,王书浩在招聘中遇到的典型问题,正是这门课试图解决的目标。
课程主讲人反复传递的一个态度是:AI学习不必有压力,但必须树立正确的方法论。从2014年至今的多个成功项目经验,被他提炼为可复用的做事方法,这或许是这门课区别于普通教程的最大差异点。
对于真正想成为AI算法工程师的人来说,比“学完某个模型”更重要的,是建立从理论到系统、从论文到产品的完整认知框架。这条路没有捷径,但方向对了,每一步都算数。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。