倾斜采样问题:乐观采样与后验采样实现对数遗憾

倾斜采样揭示从软最优分布学习采样与识别硬最优解在统计上本质不同,遗憾从√T降至log T。
文章介绍了在线学习与强化学习中的新问题——倾斜采样,其目标不再寻找单一最优动作,而是从未知奖励函数诱导的 Gibbs 软最优分布中采样多样化高质量输出。采样遗憾定义为学习器分布与 Gibbs 目标分布间温度归一化的累积 KL 散度,对应熵正则化奖励最大化的次优性差距。核心洞察是采样遗憾由置信宽度平方主导,在固定温度下仅产生对数级遗憾,与经典遗憾最小化的 √T 上界形成本质区别。研究者提出 UCS 和 TS² 两种算法,分别对应乐观采样与后验采样,并建立统一遗憾分解框架,首次给出贝叶斯采样遗憾分解。该工作对 RLHF 和生成模型微调具有直接实践启示。
从最优动作选择到软最优分布采样
传统在线学习与强化学习的核心目标,是识别单一的最优动作或策略。然而,现代学习系统的应用场景正在发生根本性转变:熵正则化强化学习、RLHF(基于人类反馈的强化学习)以及奖励导向的生成模型,其目标不再是找到一个“硬最优”解,而是从一个由未知奖励函数诱导的软最优分布中采样多样化的高质量输出。
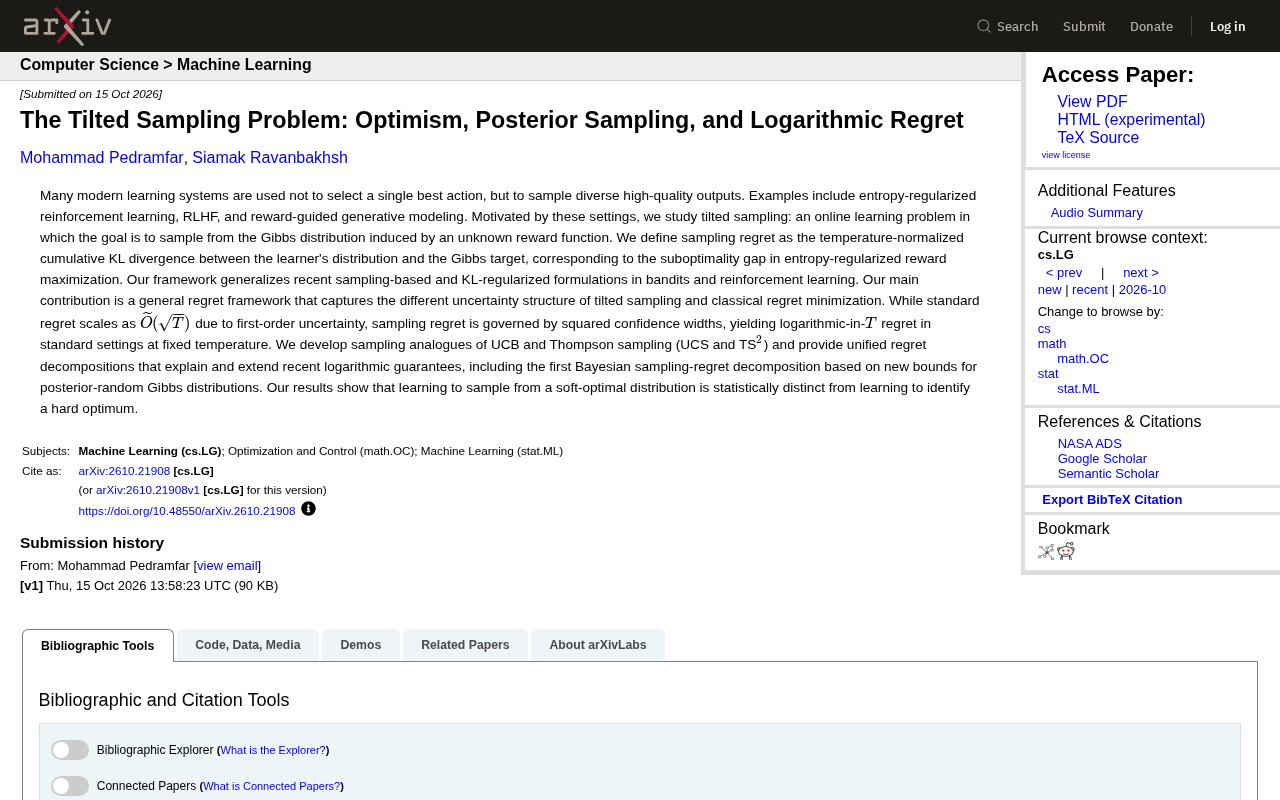
这一转变催生了一个全新的在线学习问题——倾斜采样(tilted sampling)。研究者将目标定义为从 Gibbs 分布中采样,其中奖励函数未知。采样遗憾被定义为学习器分布与 Gibbs 目标分布之间温度归一化的累积 KL 散度,这恰好对应熵正则化奖励最大化中的次优性差距。该框架统一并推广了近期在 bandit 和强化学习领域中出现的基于采样与 KL 正则化的多种设定。
Gibbs 分布(又称玻尔兹曼分布)是统计物理与机器学习中的核心概念,形式为 $\pi(a) \propto \exp(r(a)/\tau)$,其中 $r(a)$ 是动作 $a$ 的奖励,$\tau$ 是温度参数。温度越高,分布越平坦,探索性越强;温度趋近于零时,分布退化为在最优动作上的狄拉克分布,即“硬最优”解。因此,Gibbs 分布天然刻画了“以多大概率选择各动作”这一软性目标。在熵正则化强化学习中,最优策略恰好就是 Gibbs 分布形式,熵正则项的系数与温度互为倒数,这使得“最大化熵正则化奖励”与“匹配 Gibbs 分布”在数学上等价,也是倾斜采样框架得以统一多种设定的根本原因。
采样遗憾的结构性差异
这项研究的核心贡献在于揭示了一个关键洞察:采样遗憾的不确定性结构与经典遗憾最小化存在本质不同。
在标准遗憾最小化中,由于一阶不确定性的影响,遗憾上界通常表现为 $\widetilde{O}(\sqrt{T})$。然而在倾斜采样框架下,采样遗憾由置信宽度的平方主导,这在固定温度的标准设定下产生了对数级别的遗憾——即 $O(\log T)$ 或 $\widetilde{O}(\log T)$。
这一差异并非技术细节的微调,而是反映了问题本质的变化。当学习目标从“找到最优”转向“学会采样”时,学习者不需要精确消除所有不确定性,只需要以恰当的概率权重覆盖高奖励区域。这种“软性”目标允许更高效的探索策略,从而在理论上获得指数级的遗憾改进(从 $\sqrt{T}$ 到 $\log T$)。
温度归一化的累积 KL 散度是理解采样遗憾的关键。标准遗憾以奖励之差度量次优性,而采样遗憾度量的是学习器分布 $\hat{\pi}_t$ 与目标 Gibbs 分布 $\pi^$ 之间的差异,形式为 $\sum_t \tau \cdot \mathrm{KL}(\hat{\pi}_t | \pi^)$。之所以需要温度归一化,是因为 KL 散度的尺度随温度变化:温度越低,分布越尖锐,同样概率偏差带来的奖励损失越大。归一化后,该量恰好等于熵正则化奖励最大化中的次优性差距,即学习器在该时刻的期望正则化奖励与最优值之差。这一等价性使得采样遗憾既能用信息论工具分析,又能直接解释为决策质量的损失,是连接统计学习理论与强化学习实践的桥梁。
UCS 与 TS²:采样版本的乐观与后验策略
为刻画这一新问题,研究者发展了经典算法的采样对应版本:
- UCS(Upper Confidence Sampling):将 UCB 的乐观原则迁移到采样场景。它不追求识别最优动作,而是利用置信上界构造一个偏乐观的 Gibbs 采样分布。
- TS²(Thompson Sampling squared):这是 Thompson 采样的采样版变体。其名称中的“平方”正暗示了采样遗憾中置信宽度平方项的核心地位。
这两种算法都配有统一的遗憾分解框架,能够解释并扩展近期出现的对数遗憾保证。说个细节,研究者还首次给出了基于后验随机 Gibbs 分布新界的贝叶斯采样遗憾分解,为后验采样在倾斜问题中的行为提供了理论工具。
Upper Confidence Bound(UCB) 是经典 bandit 问题的核心算法,其思想是为每个动作的奖励估计构造置信上界,选择上界最大的动作,从而在利用与探索间取得平衡,对应 $\widetilde{O}(\sqrt{T})$ 的遗憾。UCS 将这一原则迁移到采样场景:不选择单个动作,而是以置信上界构造一个偏乐观的 Gibbs 分布并从中采样。Thompson Sampling(TS) 则采用贝叶斯视角,从奖励的后验分布中采样一个奖励函数,再据此选择动作。TS² 是其采样版变体,“平方”指向采样遗憾中置信宽度的平方项主导地位——这意味着算法只需让置信宽度以 $1/\sqrt{t}$ 的速度收缩,累积平方后即可获得对数级遗憾。两种算法分别代表频率派与贝叶斯派在倾斜采样下的自然延伸。
理论意义与实践启示
这项工作最重要的理论结论可以概括为一句话:从软最优分布中学习采样,与识别硬最优解,在统计上是截然不同的两个问题。
这一区分对实践有直接启示。在 RLHF 和生成模型微调中,追求“唯一最优输出”既不正确也不必要;算法设计应当直接针对分布匹配目标,利用采样遗憾的对数级收敛特性,构建更高效的训练流程。对于熵正则化强化学习,这意味着可以为温度参数和探索策略提供更紧的理论指导。
研究者建立的统一遗憾分解,也为未来工作提供了分析模板——任何涉及 KL 正则化或 Gibbs 采样的在线学习问题,都可能从这一框架中受益。该方向的研究正在推动我们从“优化单一目标”的范式,转向“学习采样分布”的新范式。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。