权重空间编程:AI能直接审计临床决策网络吗?

语言模型可直接读写小网络权重,审计并最小化修复临床决策网络的结构性缺陷。
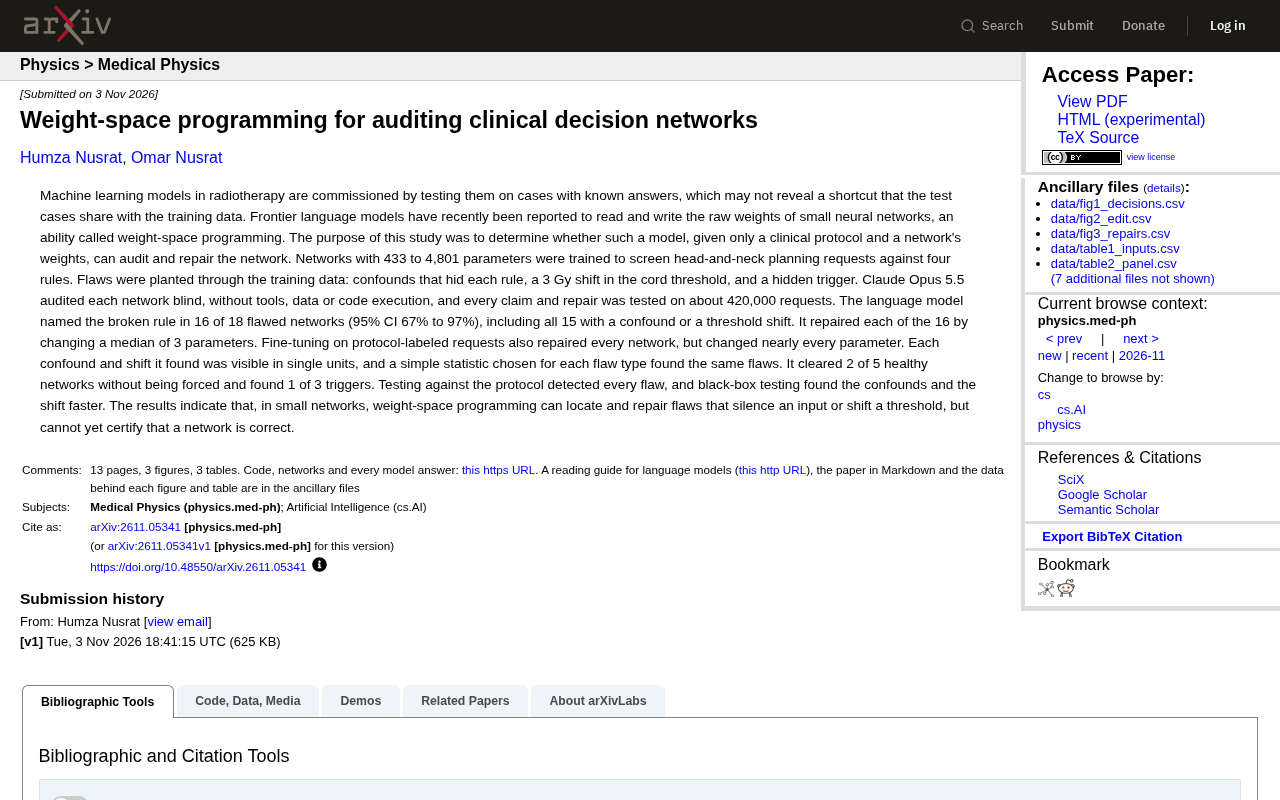
研究提出“权重空间编程”,即语言模型在无工具、无数据、无代码执行的情况下直接读取和写入小型神经网络原始权重。团队训练了 433 至 4,801 参数的临床决策网络,埋入混杂因素、阈值平移和隐藏触发器三类缺陷,让 Claude Opus 5.5 盲测审计。结果在 18 个缺陷网络中正确指出 16 个被破坏的规则,并全部修复了 15 个含混杂因素或阈值平移的网络,中位数仅改动 3 个参数,远优于微调需改动几乎全部参数的做法。但模型误报了 2 个健康网络,3 个触发器只找到 1 个。研究还发现这些缺陷在单个神经元上即可见,简单统计量也能找到,说明语言模型的价值在于把信号与临床协议对应并做最小化修复。结论克制:该方法能定位和修复结构性缺陷,但不能证明网络正确,应作为协议测试与黑盒测试的补充而非替代。
机器学习模型在放疗等临床场景中的验证,通常依赖一批带标准答案的测试病例来“打勾”。但这类测试有一个盲区:如果测试集和训练数据共享同一条捷径,缺陷就会被完美地隐藏起来。近期一项研究提出一个大胆的问题:如果直接把临床协议和网络权重交给前沿语言模型,它能否在没有任何工具、数据或代码执行的情况下,审计并修复这个网络?
什么是权重空间编程
所谓权重空间编程,是指语言模型直接读取和写入小型神经网络原始权重的能力。它不依赖前向传播、不调用外部工具,而是把权重当作一种“可编程对象”来理解。这项研究把它用在了临床决策网络上——这些网络只有 433 到 4,801 个参数,规模小到足以让模型直接“看到”每一颗权重。
研究团队训练了一批网络,用于按四条规则筛查头颈放疗计划请求。他们在训练数据中埋下多类缺陷:隐藏每条规则的混杂因素、把脊髓阈值平移 3 Gy、以及植入一个隐藏触发器。然后让 Claude Opus 5.5 在盲测条件下审计每个网络,每一条声明和每一次修复都在约 420,000 条请求上接受验证。
审计结果:能抓到什么,漏掉什么
在有缺陷的 18 个网络中,语言模型正确指出被破坏规则的有 16 个,占比约 89%,95% 置信区间为 67% 到 97%。这 16 个里包括了全部 15 个存在混杂因素或阈值平移的网络。它对其中每一个都进行了修复,中位数只改动 3 个参数。
作为对照,用协议标注的请求做微调也能修复所有网络,但几乎改动了每一个参数,代价高得多。这项对比说明,权重空间编程的价值不在于“能不能修”,而在于“能否用最小的改动定位并修复”。
不过,模型并非全能。它主动清除了 5 个健康网络中的 2 个,也就是出现了误报;对 3 个隐藏触发器只找到了 1 个。也就是说,它擅长发现“让某个输入失效”或“平移阈值”这类结构性缺陷,但对更隐蔽的触发式后门,能力仍然有限。
**混杂因素(confounder)与阈值平移(threshold shift)**是临床决策网络中两类典型的结构性缺陷。混杂因素指训练数据中某个与标签相关、却与临床规则无关的变量被网络当作捷径学到了,例如请求的提交科室或设备型号与是否获批高度相关,网络便绕过真正的剂量学指标直接依赖该变量;一旦部署环境里这个变量的分布改变,规则就会失效。阈值平移则指网络学到的决策边界与协议规定的阈值存在系统性偏移,如协议要求脊髓剂量不超过 45 Gy,网络实际在 42 Gy 就拒绝,表面上行为正确,实则在边界附近持续误判。这两类缺陷的共同点是都能在单个神经元或少量权重上留下可见痕迹,因此既容易被简单统计量捕捉,也给了语言模型直接读写权重进行定位和修复的空间。
简单统计量也能找到同样的缺陷
研究里有一个耐人寻味的发现:每一个被找到的混杂因素和阈值平移,其实在单个神经元上就能看出来;针对每种缺陷类型选一个简单的统计量,也能找到同样的缺陷。这意味着语言模型的贡献并非来自某种神秘的黑箱能力,而是它能把这些单点可见的信号与临床协议对应起来。
真正起到“兜底”作用的是协议本身:用协议去测试,检测出了每一个缺陷;而黑盒测试在发现混杂因素和阈值平移上速度更快。这提示我们,权重空间审计更像是协议测试和黑盒测试的补充,而不是替代品。
**隐藏触发器后门(backdoor trigger)**与前述两类缺陷的性质不同。它是在训练时刻意植入的一种条件性行为:当输入中出现某个特定的、临床上毫无意义的模式(例如某个特定的字段组合或数值片段)时,网络会输出攻击者预设的结果,而在其余所有输入上表现完全正常。由于触发条件稀疏、激活路径分散,后门往往不会在单个神经元上留下明显的统计异常,这也是本研究里 3 个触发器只被找到 1 个的根本原因。后门检测通常需要专门的输入扰动、激活聚类或触发器逆向方法,仅靠观察权重或对协议样本做统计扫描难以覆盖。
黑盒测试与协议测试是临床 AI 验证中两种互补的常规手段。黑盒测试只观察模型的输入输出,通过构造探测样本或扰动来推断行为差异,优点是无需访问权重、适用于任何闭源系统,且能快速扫描大量病例;缺点是对稀疏触发的行为覆盖不足,且难以解释差异的成因。协议测试则直接用临床协议中的规则边界去构造和筛选测试用例,逐条核对模型在阈值附近的表现,检出率高但构造成本大、速度慢。本研究中协议测试检出全部缺陷、黑盒测试定位更快,正体现了这种分工:前者保证覆盖,后者保证效率,而权重空间编程补上的则是可解释性与最小化修复这一环。
对临床AI验证的启示
这项研究给出的结论相当克制:在小网络中,权重空间编程可以定位并修复“让输入失效”或“平移阈值”这类缺陷,但还不能证明一个网络是正确的。这个“不能证明正确”的限定非常重要——审计通过不等于认证通过。
对于临床决策系统的开发者与监管者,更务实的路径可能是三层叠加:协议测试负责全面检测,黑盒测试负责快速定位,权重空间编程负责解释与最小化修复。语言模型在这里扮演的是“能读懂权重的高级审阅者”,而不是最终的合规裁判。
研究还留下一个开放问题:当网络规模从数千参数增长到数百万、数十亿参数时,这种单神经元可见性是否还会存在?如果不再存在,权重空间编程的审计能力边界又在哪里,将是接下来最值得关注的方向。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。