缺失协变量下的逻辑回归:无需假设分布的新方法

假设精简设定下,新随机逼近算法为缺失协变量逻辑回归提供理论最优的分布无关估计方案。
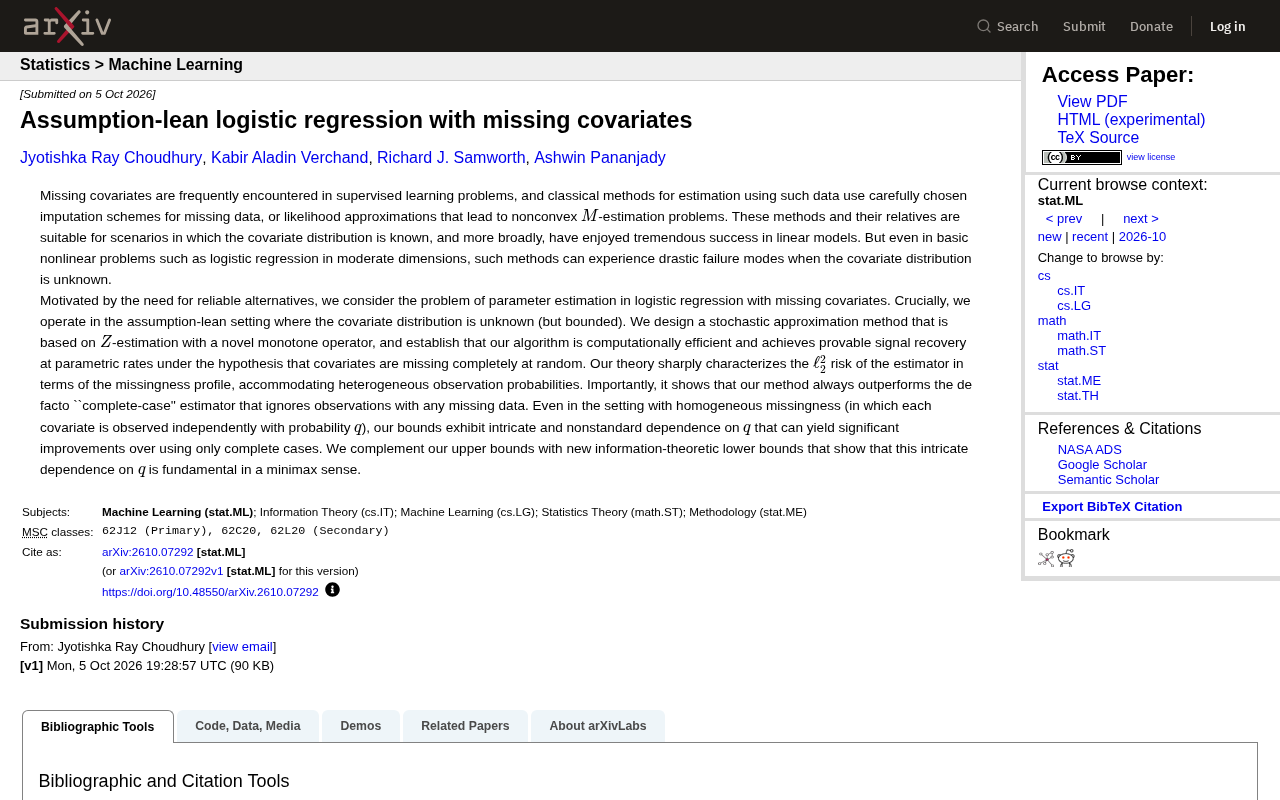
这篇论文针对协变量缺失下的逻辑回归问题,在不对协变量分布作任何假定(仅要求有界)的"假设精简"设定下提出了新解法。核心贡献是一种基于Z-估计和新颖单调算子的随机逼近算法,在完全随机缺失(MCAR)假设下,该算法计算高效且能以参数速率实现可证明的信号恢复。理论结果精确刻画了估计风险与缺失分布特征的关系,并证明新方法始终优于丢弃含缺失观测的"完整样本"估计器。更重要的是,作者同时建立了信息论下界,从极小极大意义上证明估计误差对观测概率的复杂依赖是本质性的,而非算法局限,从而形成理论闭环。
一个被长期忽视的统计难题
在监督学习中,协变量(特征)缺失是极为常见的现象——问卷里跳过的题目、传感器偶尔失灵、数据库中空缺的字段都会造成这种情况。传统的处理方式主要有两条路径:一是精心设计插补(imputation)方案来填补缺失值,二是采用基于似然的近似,但后者往往会引出非凸的 M-估计问题,优化难度陡增。
这些方法在线性模型中取得了巨大成功,前提是协变量的分布已知。然而这篇 arXiv 新论文(arXiv:2610.07292v1)指出了一个关键软肋:一旦协变量分布未知,即便是逻辑回归这样基础的非线性问题,在中等维度下传统方法也可能出现灾难性的失效模式(drastic failure modes)。
什么是「假设精简」设定
论文的核心创新在于它所采用的 assumption-lean(假设精简)设定。所谓假设精简,即不对协变量的分布形态做出任何具体假定,仅要求其有界(bounded)。这与经典方法形成鲜明对比——后者通常需要知道或假设协变量服从某种已知分布。
现实世界的数据往往不满足理想的分布假设,当这些假设被违反时,依赖它们的估计器会迅速崩溃。作者正是从「需要可靠替代方案」这一实际动机出发,重新审视了缺失协变量下逻辑回归的参数估计问题。摆脱对分布的强依赖,使得方法在更广泛、更贴近真实的场景中依然稳健。
基于 Z-估计的随机逼近算法
为解决这一问题,作者设计了一种随机逼近(stochastic approximation)方法,其基础是 Z-估计(Z-estimation),并引入了一个新颖的单调算子(monotone operator)。单调算子的引入是关键——它使得原本可能非凸的优化问题具备良好的数学结构,从而保证算法的计算高效性。
论文证明,在协变量完全随机缺失(missing completely at random, MCAR)的假设下,该算法不仅计算高效,还能以参数速率(parametric rates)实现可证明的信号恢复。换言之,它在理论上既快又准,这在处理缺失数据的非线性模型中并不常见。
对缺失概率异质性的刻画
该方法的理论结果精确刻画了估计器的 $\ell_2^2$ 风险与缺失分布特征(missingness profile)之间的关系,并且能够容纳异质的观测概率——即不同协变量被观测到的概率可以各不相同。这种灵活性让理论更贴近实际数据的复杂情况。
Z-估计(Z-estimation)是统计学中一类重要的估计框架,其核心思想是将参数估计转化为求解某个"估计方程"(estimating equation)的零点问题,即找到使某个向量值函数等于零的参数值。最大似然估计、矩估计等经典方法都可纳入这一框架。Z-估计的优势在于,它不要求目标函数全局凸,只需估计方程具备适当的单调性或强制性条件即可保证解的存在与唯一性。本文通过引入单调算子(即满足 $\langle F(x)-F(y),, x-y\rangle \geq 0$ 的算子),将缺失数据下的逻辑回归问题转化为一个结构良好的单调方程求解问题,从而规避了非凸优化的难题,并为随机逼近迭代算法(类似 Robbins-Monro 方案)的收敛性分析奠定了理论基础。
始终优于「完整样本」估计器
论文一个颇具说服力的结论是:该方法始终优于事实上的默认做法——「完整样本」(complete-case)估计器。后者简单粗暴地丢弃任何含有缺失值的观测,这在数据宝贵时显然是一种浪费。
即便在同质缺失的设定下(每个协变量以独立概率 $q$ 被观测到),作者给出的误差界对 $q$ 呈现出复杂而非标准的依赖关系。这种依赖意味着,相比仅使用完整样本,新方法可以带来显著的提升——充分利用那些被传统方法舍弃的部分观测信息。
信息论下界:复杂性是本质的
论文不止于给出上界。作者还提供了新的信息论下界(information-theoretic lower bounds),从极小极大(minimax)意义上证明了误差对 $q$ 的这种复杂依赖关系是根本性的,而非算法设计的人为产物。
上界与下界的配合,使得这项工作在理论上形成了闭环:它既展示了方法能达到的性能,也界定了任何方法在该问题上不可逾越的极限。对于统计学习理论研究者而言,这种「匹配上下界」的结果具有很高的参考价值。
极小极大(minimax)框架是统计估计理论中衡量方法最优性的标准范式。其基本思想是:针对某个参数类,先对所有可能的估计器取最坏情况风险的下确界,再与具体算法的上界进行比较。若某方法的上界与信息论下界在阶上匹配(up to constants),则称该方法是"极小极大最优"的,意味着在该问题类上不存在本质上更好的方法。本文建立的下界表明,观测概率 $q$ 对估计误差的复杂影响并非某种特定算法的缺陷,而是问题本身固有的统计难度——任何估计器,无论设计多精妙,都无法完全消除这种依赖。这一结果赋予了上界算法理论上的最优性地位,同时也为后续研究划定了不可突破的性能边界。
对实践与研究的意义
这项研究的价值在于,它为缺失协变量下的逻辑回归提供了一套不依赖分布假设、计算可行、理论有保证的方案。在医疗、金融、社会调查等缺失数据普遍存在且协变量分布难以准确建模的领域,这类假设精简的方法有望减少因错误假设而导致的估计偏差。
需要注意的是,论文的理论保证建立在「完全随机缺失」这一相对较强的假设之上。在实际应用中,缺失往往并非完全随机,而是与数据本身相关(如 MAR 或 MNAR)。如何将这套框架推广到更一般的缺失机制,可能是后续研究的重要方向。
缺失数据机制通常分为三类:完全随机缺失(MCAR,Missing Completely At Random)指数据的缺失与任何观测或未观测变量均无关;随机缺失(MAR,Missing At Random)指缺失概率仅取决于已观测到的变量;非随机缺失(MNAR,Missing Not At Random)指缺失概率还与未被观测到的变量本身相关,是三者中最难处理的情形。本文的理论保证建立在 MCAR 假设之上,这在现实中往往偏乐观——例如,收入调查中高收入者更倾向于不填写薪资,属于典型的 MNAR。将假设精简框架推广至 MAR 或 MNAR 场景,需要引入对缺失机制的额外建模或识别假设,是一个技术难度更高但实用价值更大的开放问题。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。