Qwen 2.1 输出归属明确:生成内容归你所有
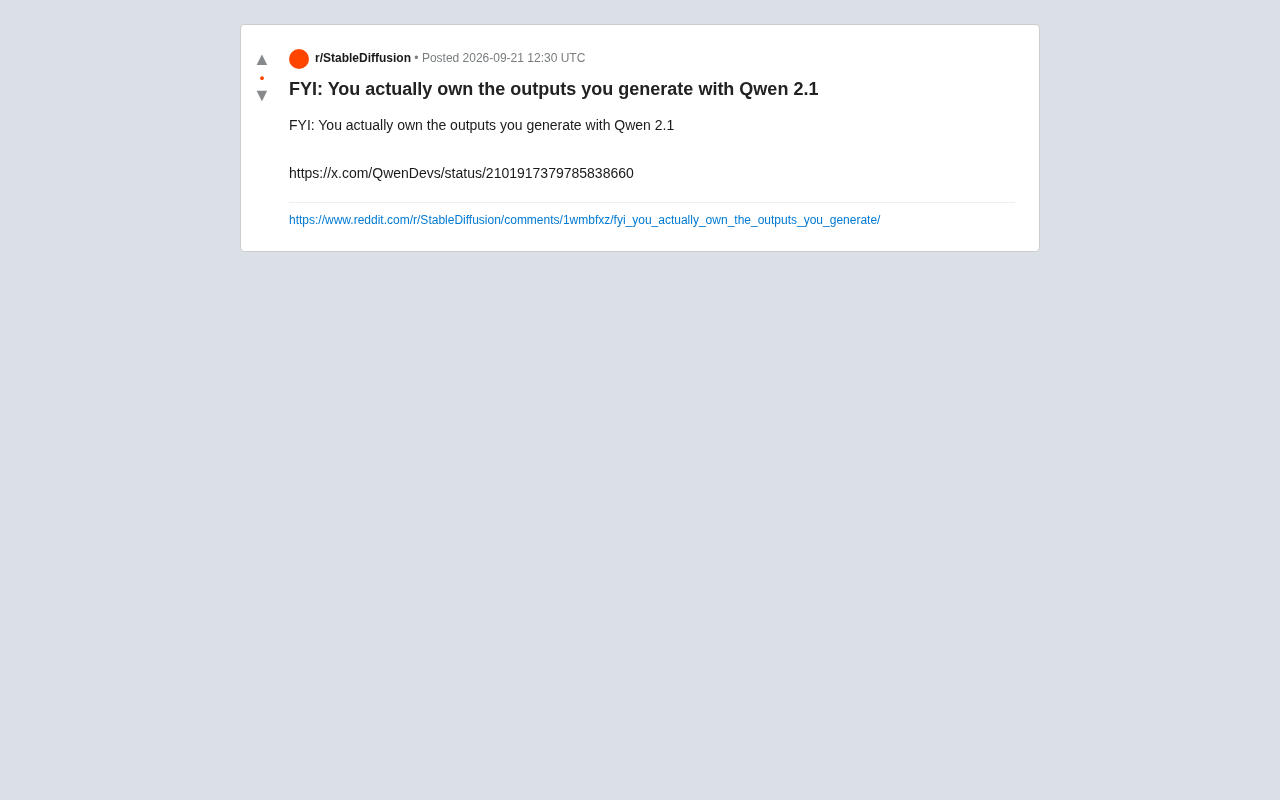
阿里Qwen团队官方确认Qwen 2.1生成内容归用户所有,降低商业合规门槛。
阿里通义千问(Qwen)团队近日通过官方渠道明确声明:使用Qwen 2.1生成的输出内容归用户所有。这一表态直接回应了开发者和商业用户长期关注的版权归属问题——明确的所有权意味着用户可以将AI生成的代码、文案等内容自由集成进商业产品,无需担忧事后被追溯权利,也降低了企业合规审查的复杂度。该消息在Reddit等技术社区引发讨论,反映出随着大模型进入生产环境,授权条款友好度已成为与模型性能同等重要的选型维度。值得注意的是,拥有输出所有权并不免除用户对第三方侵权的审查责任:若生成内容无意中复现了受版权保护的训练数据,相关法律风险仍由用户自行承担。
近日,阿里通义千问(Qwen)团队通过官方渠道明确了一个对开发者和商业用户至关重要的问题:使用 Qwen 2.1 生成的输出内容,归用户所有。这一表态迅速在 Reddit 等技术社区引发讨论,因为输出归属权直接关系到 AI 生成内容能否被合法、自由地用于商业场景。
为什么输出归属权如此重要
对于任何使用大模型的团队来说,"我生成的东西到底归谁"是一个绕不开的法律与商业问题。如果模型提供方对输出内容保留权利,那么用户在将 AI 生成的代码、文案、图像等用于产品或对外发布时,就可能面临版权归属不清、二次授权受限甚至潜在诉讼风险。
明确输出归用户所有,意味着开发者可以放心地把 Qwen 2.1 的生成结果集成进自己的应用、纳入商业产品,而不必担心事后被追溯权利。这一点对创业公司、独立开发者和企业级用户尤其关键——它降低了合规成本,也消除了将模型深度嵌入工作流的顾虑。
这一问题在法律层面的复杂性源于AI生成内容(AIGC)的版权地位至今仍存在争议。目前多数国家和地区的版权法要求作品须具备"人类创作性"才能获得保护,这导致纯AI生成的内容在许多司法管辖区处于版权真空地带——既无法由模型提供方主张权利,也不必然受到版权保护。然而,商业实践中真正重要的往往不是"能否确立版权",而是"谁有权使用这些内容以及以何种方式使用"。模型服务条款(Terms of Service)正是填补这一空白的关键文件:它以合同形式规定了生成内容的使用边界,独立于版权法之外运作。OpenAI、Anthropic、Google等主流模型提供商均在其服务条款中明确规定输出归用户所有,但同时附加了禁止将输出用于训练竞争性模型、不得主张对输出的版权等限制条款。Qwen此次表态的意义在于,为使用者提供了合同层面的确定性,消除了潜在的商业使用障碍。
Qwen 团队的官方表态
根据 Qwen 官方 X(原 Twitter)账号发布的信息,团队直接确认了用户对 Qwen 2.1 生成输出的所有权。这种主动澄清的做法,本质上是在与开发者社区建立信任。
在当前大模型竞争激烈的环境下,条款友好度已经成为模型选型的重要考量之一。相比一些对输出内容附加复杂使用限制的闭源服务,Qwen 明确"输出归你"的立场,无疑增加了它对开源与商业用户的吸引力。
这对使用者意味着什么
从实际使用角度看,这一声明带来几层直接影响:
- 商业化更自由:用 Qwen 2.1 生成的内容可以直接用于付费产品或对外服务,无需额外授权。
- 合规风险降低:明确的所有权减少了法律灰色地带,尤其利于企业审查流程。
- 降低集成门槛:开发者可以更放心地将模型作为底层能力嵌入自己的技术栈。
不过需要提醒的是,"拥有输出所有权"并不等同于"输出内容一定不侵犯第三方权利"。生成内容如果无意中复现了受版权保护的素材,用户仍需自行承担审查责任。所有权归属解决的是提供方与用户之间的关系,而非用户与外部第三方之间的潜在纠纷。
关于"输出不侵犯第三方权利"的额外说明值得展开。大语言模型在训练过程中处理了海量文本数据,存在生成内容与训练集中受版权保护材料高度相似的可能性,即所谓的"记忆化"(memorization)现象。研究表明,模型规模越大,对训练数据的记忆程度可能越高。在美国,已有多起针对AI公司的版权诉讼涉及此类问题,如Getty Images诉Stability AI案、多位作家诉OpenAI案等。这意味着,即便Qwen明确输出归用户所有,用户在将生成内容用于高风险场景(如出版发行、品牌物料)时,仍应考虑对输出进行相似性检测,或咨询法律顾问,以规避来自训练数据版权持有人的潜在索赔风险。
社区反应与背景
此消息在 Reddit 相关技术板块被转发讨论,反映出社区对模型使用条款的高度敏感。随着越来越多团队将大模型投入生产环境,条款细节——包括输出归属、数据留存、商用限制等——正成为与模型性能同等重要的评估维度。
Qwen 系列一直以开放策略著称,此次对输出所有权的明确表态,延续了其面向开发者友好的路线。对于正在评估国产及开源大模型的团队而言,这类清晰的授权信号,往往比单纯的跑分数据更能影响最终决策。
小结
这条看似简单的公告,触及的是 AI 落地过程中一个核心却常被忽视的环节:生成内容的权利归属。Qwen 2.1 明确将输出所有权交还用户,为其在商业与开发场景中的采用扫清了一层障碍。对使用者来说,在享受这份自由的同时,也应记得对生成内容做必要的合规审查,才能真正安心地将其推向市场。
相关推荐
Cloudflare开源决策模型Clef,亚马逊80亿芯片剥离出表
Cloudflare开源决策模型Clef刷新43项基准,亚马逊将80亿美元英伟达芯片剥离出表转向轻资产,华尔街启动600亿美元AI芯片融资,人形机器人半年出货暴增432%,一文速览今日AI行业要闻。
CSS开发者偏好实录:Adam Argyle谈最爱的颜色、单位与属性
CSS专家Adam Argyle在前端快问快答中分享最爱的颜色、格式、属性和单位,对比社区投票揭示OKLCH普及、display与rem称王、grid渐变常需查文档等前端生态信号。
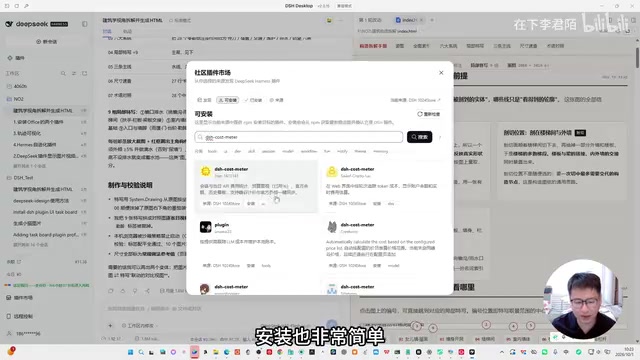
DeepSeek Harness全模态桌面端搭建指南:生图、视频、远程操控全打通
手把手教你把 DeepSeek Harness 打造成全模态桌面端:用 DSH Desktop 安装客户端,接入 Agnes 免费生图生视频、DeepSeek V4.1 Flash 视觉理解、AnySearch 联网搜索,并通过 Anywhere 实现手机远程操控电脑。