Qwen 3.8 27B本地大模型实测:小体积如何逼近顶级闭源模型
270亿参数的Qwen 3.8可在家用显卡本地运行,性能逼近顶级付费模型,但过度思考导致速度极慢。
Qwen 3.8(27B参数)是一款仅17GB的开源量化模型,可在RTX 3060 Ti或MacBook等普通硬件上本地运行,却在SWE Bench Pro等编程基准中逼近此前只能付费使用的顶级云端模型。社区测评与创作者实测共同印证:该模型输出质量令人惊艳,但默认开启最高推理档位导致严重的「过度思考」,token消耗约为同类模型的2倍以上,速度极慢。在发票生成和待办应用两项实测中,Qwen质量优于同级Gemma 4,但仍不及GPT 5.6/Codex。其核心价值不在于全面超越顶级模型,而在于强大的开源权重可永久本地拥有,标志着「百亿参数级本地AI」时代真正到来。
一个270亿参数的模型,能在你自己的家用电脑上运行,却在部分基准测试中挑战几个月前还需要付费才能使用的顶级模型。这就是Qwen 3.8(27B参数版本)带来的冲击。本文基于一位YouTube创作者的深度实测,结合Hacker News和X平台上的社区反馈,来看看这款开源模型究竟意味着什么。
为什么说这是一个里程碑
讨论的焦点并不是Qwen 3.8是否真的比Opus 4.6 Max更强,而是「我们居然可以严肃讨论这个问题」这件事本身。在过去,尝试运行这个体积的模型往往令人失望——它们几乎什么都做不好。而如今,一个仅17GB大小的量化模型,可以在NVIDIA RTX 3060 Ti(8GB显存)这样的普通配置,或是MacBook、DGX Spark类设备上顺畅运行。
创作者在Ollama页面上展示了该模型的多种量化版本,强调其核心价值不在于绝对性能,而在于「这样的性能能在如此小的体积上实现」。在SWE Bench Pro等智能体编程基准中,Qwen 3.8据称在部分项目上超越了Opus 4.6 Max;在Hacker News上广受讨论的Artificial Analysis基准里,它也逼近甚至超过了一些体积大得多的模型,如GLM 5.2 Max、Kimi K3和GPT 5.6。
当然,基准测试可以被「刷分」,并非评判模型的最佳依据。因此创作者更倾向于亲自测试,并倾听社区的真实反馈。
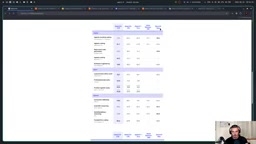
「量化」(Quantization)是让大模型能在消费级硬件上运行的关键技术。原始模型的每个参数通常以32位或16位浮点数存储,而量化通过将精度压缩到8位、4位甚至更低来大幅缩减模型体积和内存占用,代价是轻微的精度损失。Qwen 3.8的270亿参数在全精度下需要约54GB存储,而经过4-bit量化后压缩到约17GB,使其得以载入8GB显存的消费级显卡。Ollama、llama.cpp和LM Studio是目前最常用的本地运行框架,它们负责处理量化模型的加载、调度和推理,并提供兼容OpenAI接口的API,让用户可以用与调用云端模型相同的方式使用本地模型。GGUF是llama.cpp生态主流的量化模型格式,不同的量化精度(如Q4_K_M、Q8_0)对应不同的体积与质量权衡。
社区共识:输出惊艳,但过度思考
在Hacker News上,多位用户的评价呈现出高度一致的结论:模型的输出质量令人印象深刻,但它的「过度思考」问题严重。
一位拥有私有基准测试的用户表示,这是仅有的第二个能够正确推理出其测试题的本地模型——但它花费了比Gemma 4多五倍的token,耗时12分30秒才完成。这与创作者本人的体验高度吻合:模型确实能把事情做完,考虑到其体积这非常惊人,但速度极慢,尤其在硬件较旧的情况下,可能要等上一小时才能拿到结果。
知名开发者Simon Willison也撰文指出,Qwen 3.8 27B「非常出色,但默认设置下会疯狂地过度思考」。该模型默认将推理档位设为极高(extra high reasoning),他认为以这种方式在消费级硬件上运行并不明智。有趣的是,如果削减思考过程,输出质量反而会下降。
Token消耗数据也印证了这一点:据社区帖子,其token用量约为GPT Luna Max的2.3倍、Kimi K3的近2倍。同时也有用户提供了可替换的聊天模板(chat template),据称能缓解官方模板带来的部分问题——不过需要使用llama.cpp、LM Studio或vLLM等软件才能替换,Ollama暂不支持。
「过度思考」(overthinking)是推理型大模型的一个典型问题,根源在于这类模型在训练时被鼓励通过延长「思维链」(Chain-of-Thought)来提升准确率。Qwen 3.8属于混合推理架构,可以在「思考模式」(thinking mode)和「非思考模式」之间切换——前者类似DeepSeek-R1,会在输出答案前生成大量内部推理步骤,消耗数倍乃至数十倍的token;后者则跳过推理直接回答,速度更快但准确率下降。问题在于,该模型默认将推理档位设置为最高,导致即便是简单任务也会触发冗长的内部独白。token消耗直接决定推理速度,在本地硬件上,这意味着等待时间可能从分钟级拉长到小时级。如何在推理深度和响应速度之间找到平衡点,是使用此类模型时最需要人工调优的参数。
实测一:发票自动化工具(高难度)
创作者设计了一个刻意提高难度的任务:要求模型分析真实发票PDF样本,从中推导出模板代码(甚至包括提取logo),再用Flask构建一个能录入信息并生成同款PDF发票的应用,并指定使用UV作为包管理器。
这类任务对任何模型都不轻松,连Claude Code和Codex都经历了大量试错才完成。对比结果如下:
- Claude Code:作为号称的顶级模型,结果存在空行等瑕疵,设计尚可但不够惊艳。
- Codex(GPT 5.6,极高推理):几乎完美,界面美观,被评为最优结果。
- GLM 5.2:耗时较长,能用但格式与样本不一致,logo略有裁切;有趣的是仍优于Claude的输出。
- Qwen 3.8 27B(本地,高推理):文字未能整齐填入方框,存在格式问题,但作为一个从零开始、需分析PDF并提取素材的270亿参数模型,创作者认为这一表现「令人叹为观止」。
- Gemma 4(约26B,对手模型):速度最快、几乎瞬间完成,但完全忽略了指定格式、没有logo,还需要手动指示才修正错误。
结论很明确:Gemma更快,但Qwen在输出质量上明显更胜一筹。
UV是近年来在Python社区快速普及的新一代包管理器,由Rust编写,速度远超传统的pip和conda。在AI编程测试中指定使用UV,是对模型工具链知识时效性的一种隐性考察——模型需要知道如何用uv init初始化项目、uv add安装依赖,而非仅使用pip install。SWE Bench是AI编程能力评估的权威基准之一,要求模型在真实的GitHub开源仓库中解决实际issue,包括理解代码库、定位问题、编写补丁并通过原有测试套件,被认为比纯代码生成类基准更能反映模型在真实软件工程场景中的能力。SWE Bench Pro是其升级版,进一步提高了任务难度和评估严格程度。
实测二:待办事项日历应用(中等难度)
第二个任务相对简单:用Flask做一个带日历视图的极简待办应用,支持标题、描述、完成勾选和可选截止日期,并明确要求「不要过度思考,快速构建即可,不需要测试」。
讽刺的是,Qwen完全无视了「不要测试」的指令,仍进行了冒烟测试。不过这一测试实际上是必要的——过程中它先遇到了「no module named flask」的问题,随后又碰到500服务器错误,若不测试便会多次失败。
对比结果:
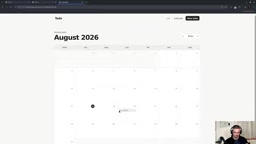
- Qwen(关闭推理):勉强能用,日历视图不美观。
- Qwen(高推理):耗时更长但质量更高,具备可用的日历视图,仍有小瑕疵。
- Codex(GPT 5.6):外观明显更好、专业干净,全面领先。
- Gemma 4:更快,但日历视图完全不显示待办事项,失败程度甚至超过Qwen。
- GLM 5.2:作为开源模型,结果同样不错。
创作者坦言,并不能说这个270亿参数的本地模型全面超越了其他模型或达到顶级水准。但关键在于:面对「它能否比肩顶级模型」这个问题,答案不再是「显然不能」——这本身就足够说明问题。
里程碑的意义与现实定位
创作者用几个「里程碑时刻」勾勒了大模型的发展脉络:ChatGPT的公众普及是第一个里程碑;Opus 4.5让人第一次能真正信任编程智能体是第二个;Kimi K3和GLM 5.2代表开源模型追赶顶级水平的时刻;而现在正在到来的,是「参数量在100亿左右、可以在本地实际运行」的强大开源模型。
他给出的最终判断相当克制:不会用Qwen 3.8取代Claude Code或Codex作为主力编程工具,甚至也不会取代日常偶尔使用的GLM 5.2,因为要真正实用还需更多打磨。
但兴奋点在于——这是当下的「底线水平」。所有此后发布的模型都必须比它更好,否则毫无意义。更重要的是,这是任何人都能下载到自己硬盘、运行在自己硬件上的智能:没有公司能关停服务、没有公司能把你拉黑,权重就是一堆数字,一旦拥有就永远属于你,而且无需数据中心即可运行。
对本地AI感兴趣的用户,这款模型值得一试——只要你能接受它慢,并愿意为削减过度思考做些调优。
相关推荐
从 ownCloud 迁移:自建 5 副本 3 地备份的家庭 NAS 实践
一位 Reddit 用户分享了从 WD MyCloud 到自建 ownCloud 的完整历程,展示三地五副本的 ZFS+Proxmox 备份架构,并深入探讨 ownCloud 客户端停止支持经典版后向 OCIS、Nextcloud、OpenCloud 迁移的抉择。
Agent Skills 是什么?从理解到定制的开发入门指南
Agent Skills 是智能体开发中的重要一环。本文解析 Skill 的概念、在 Claude Code 等 Agent 生态中的位置,以及从理解、定制到应用的三步学习路径,帮助零基础开发者快速入门。
Omarion SEC CLI:自愈式自主智能体如何解决AutoGPT顽疾
Omarion SEC CLI 是一款开源自主命令行智能体,通过长期记忆、执行指纹自愈、目标评估门和意图路由,解决 AutoGPT 类工具的错误循环、终端杂乱与会话失忆问题。本文解析其架构设计与三阶段演进。