Qwen 4 27B缺席引热议:模型迭代的期待与现实

Reddit帖子调侃Qwen 4 27B迟迟未发布,折射开源社区对中等规模模型的期待与无奈。
文章围绕Reddit上一篇题为《Where is QWEN 4 27b ?》的帖子展开,指出其极简内容却精准击中了开源模型社区对特定尺寸迭代节奏的敏感。27B被视为本地部署与推理质量之间的“甜点区”,是开发者做微调、私有化部署和轻量应用时优先评估的区间,因此社区对该型号缺席的讨论迅速发酵。文章进一步分析,模型发布受训练成本、数据策略、产品定位等多重因素影响,社区流传的尺寸与时间点多为推测而非官方承诺。作者建议开发者把注意力放在现有模型的实际表现上,持续跟踪官方渠道,避免将项目节奏绑定在未发布型号上。
Reddit社区近日出现一篇题为《Where is QWEN 4 27b ?》的帖子,发帖者用一句调侃道出了不少开发者的心声:“A wise man once told me 'models will break your heart'. I just didn't think he meant these types of models lol.”(一位智者曾告诉我“模型会让你心碎”,我没想到他指的是这种模型)。这句玩笑背后,是对Qwen系列下一代中等规模模型迟迟未现身的集体期待与轻微失落。
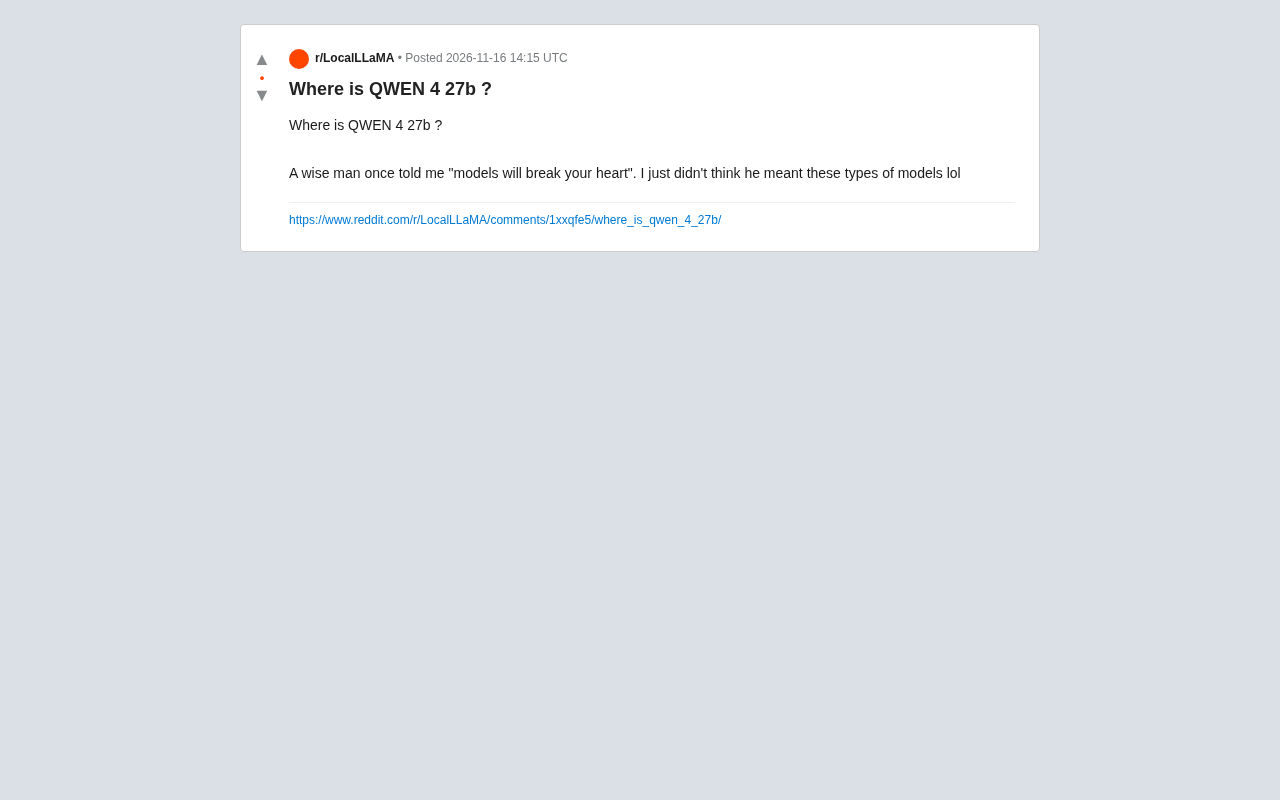
一条帖子折射的社区情绪
帖子内容极简,没有参数对比,也没有性能猜测,却精准戳中了一个普遍现象:开源模型社区对特定尺寸模型的迭代节奏异常敏感。27B这个量级在本地部署与效果之间往往被视为“甜点区”,既能满足一定推理质量,又不会对硬件提出过于苛刻的要求。当用户习惯了某个系列按部就班的更新后,一旦预期中的型号缺席,讨论便会自然发酵。
这种情绪并非孤例。在模型快速迭代的当下,社区对“下一代什么时候来”的关注,有时甚至超过了对现有模型能力的深入挖掘。发帖者的自嘲式表达,恰恰说明大家心里清楚:模型路线图的变数,从来不是线性可预测的。
为什么27B尺寸如此受关注
从工程实践角度看,中等规模模型一直是开源生态里的关键一环。它不像超大模型那样依赖多卡集群,也不像小模型那样在复杂任务上容易力不从心。对于需要在本地跑微调、做私有化部署或搭建轻量应用的开发者来说,这个区间的模型往往是最先被纳入评估清单的。
正因如此,当社区讨论“Qwen 4 27B在哪”时,背后其实是对一个可落地、可负担的升级选项的渴望。人们期待的不只是一个新版本号,而是一个能在现有硬件条件下带来可见提升的替代方案。
“甜点区”(Sweet Spot) 是本地部署社区常用的一个说法,指在模型参数量、推理质量与硬件门槛之间取得较优平衡的规模区间。按常见估算,FP16精度下每10亿参数约需2GB显存,27B模型全精度推理接近54GB,通常需要多卡或大显存GPU;但若采用4-bit量化,显存占用可降至约14-16GB,使单张消费级显卡(如24GB显存级别)即可运行。相比之下,70B级模型即便量化后仍对硬件要求较高,而7B-8B模型在复杂推理、长上下文任务上能力有限。因此20B-30B区间常被视为“能用单机跑、效果又够用”的折中选择,这也是27B型号格外受关注的技术原因。
模型路线图的不确定性
发帖者那句“models will break your heart”之所以引发共鸣,是因为它点出了一个现实:模型发布节奏受训练成本、数据策略、产品定位等多重因素影响,外界的猜测很难准确命中。社区里流传的尺寸、时间点,往往只是基于过往规律的推测,而非官方承诺。
对开发者而言,更务实的做法是把注意力放在已有模型的实际表现上,同时保持对官方渠道的關注。期待本身没有错,但把项目节奏绑定在未发布的型号上,风险不小。
开源模型的发布节奏与路线图(Roadmap) 的可信度之间存在天然张力。多数厂商在正式发布前不会公开确认具体型号的参数量与时间表,社区流传的“下一代XX B”多为基于历史发布间隔、竞品动向和招聘/论文线索的推测。训练成本(千卡级集群的算力投入)、数据配比与清洗策略、以及产品线定位(如是否用MoE架构替代稠密模型)都会导致计划调整。因此,即便某个尺寸在上一代存在,也不保证下一代沿用同一规格,开发者以此做容量规划时需预留替代方案。
理性看待社区期待
这条帖子没有提供任何技术细节,它的价值在于呈现了一种真实的使用者心态:既有关注,也有无奈。对于关注Qwen系列的人来说,与其在论坛里反复追问,不如持续跟踪官方发布渠道,并在现有版本上做好技术储备。模型会来,但什么时候来、以什么形态来,只有时间能给出答案。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。