Qwen 4.5与Qwen 5路线图曝光:参数规模持续膨胀,27B尺寸能否保留成悬念

Qwen 4.5和Qwen 5将继续扩大参数规模,社区担忧27B等中小尺寸被边缘化。
Reddit社区一则帖子援引Qwen官方公告截图指出,通义千问未来Qwen 4.5和Qwen 5将继续向更大参数规模推进。帖子作者对此心情复杂:好的一面是模型能力有望随规模提升,坏的一面是资源有限的开发者可能失去可用的中小尺寸模型。他特别希望Qwen保留27B档位或提供合理的中等规模MoE选项。文章分析了参数竞赛背后的逻辑——更大参数量通常带来更强能力,但训练和推理成本、部署门槛也随之上升。社区的核心诉求并非反对模型变大,而是希望产品线保持梯度,让不同资源条件的用户都有选择。Qwen需要在冲击能力上限与维持生态可用性之间取得平衡。
参数膨胀已成定局:Qwen 4.5与Qwen 5的“不归路”
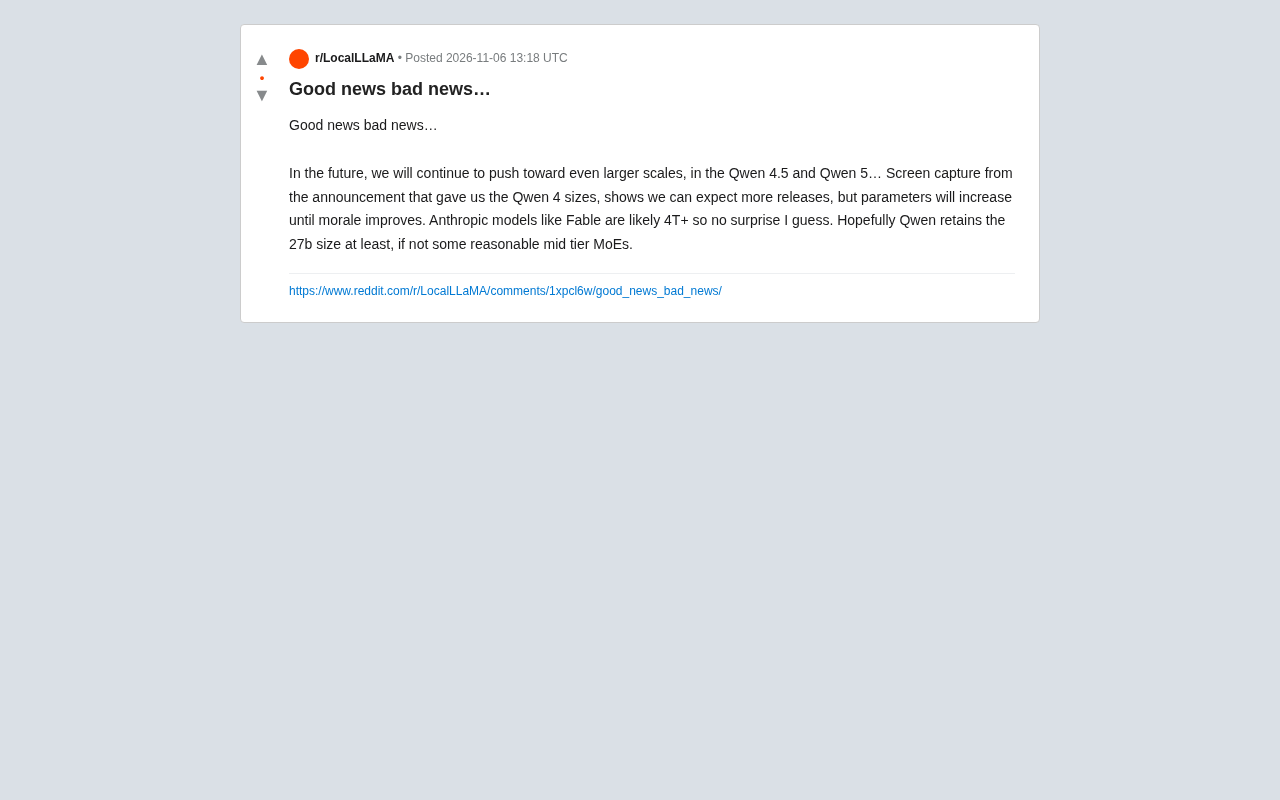
Reddit社区近日一则题为“Good news bad news…”的帖子引发了广泛讨论。帖子援引一张官方公告的截图指出,通义千问广告团队明确表示,未来将继续向更大规模推进,涉及Qwen 4.5和Qwen 5。截图中的信息显示,在公布Qwen 4系列尺寸的同时,官方给出了后续版本的发布预期,并带有几分调侃地写道:参数会一直增长,直到士气提升为止。
这则消息的“好”在于,Qwen系列仍在持续迭代,模型能力有望随规模提升而进一步增强;“坏”则在于,对于资源有限的开发者和个人用户而言,可用的中小尺寸模型可能越来越少。帖子作者坦言,Anthropic旗下的Fable等模型据称已达到4T以上参数规模,因此Qwen的扩张并不令人意外。但他仍然希望Qwen能至少保留27B这一档尺寸,或者提供一些合理的中等规模MoE(混合专家)模型。
为什么大模型都在“卷”参数?
从行业趋势看,参数规模的膨胀并非Qwen独有。帖子中提到的Anthropic模型据称达到4T+,虽然这一数字尚未得到官方确认,但头部厂商纷纷推进万亿级乃至更大规模模型已是公开的秘密。背后的逻辑并不复杂:更大的参数量通常意味着更强的知识容量和推理潜力,在基准测试和复杂任务中更容易取得优势。
然而,这条路径的代价同样明显。训练成本、推理成本、能耗以及部署门槛都会随参数规模上升。对于云厂商和资金充裕的AI实验室而言,这是可以承受的投入;但对于依赖本地部署或有限算力的开发者来说,超大模型的可及性很低。正因如此,帖子作者对27B尺寸的去留格外关注——这一档位在性能与资源消耗之间取得了较好的平衡,是许多实际应用场景的“甜点”尺寸。
MoE(混合专家)架构是理解当前模型规模讨论的关键背景。传统密集模型在每次推理时都会激活全部参数,而MoE模型将参数划分为多个“专家”子网络,并通过门控机制在每次前向计算中只激活其中少数几个专家。这意味着模型的总参数量可以非常大,但单次推理的实际计算量(即激活参数量)却相对可控。例如,一个总参数达到数百B的MoE模型,单次推理可能只激活20B-30B的参数,从而在保持较高能力的同时显著降低推理成本。这正是社区呼吁“合理的中等规模MoE”的原因:它能在有限算力下提供接近大模型的表现,是资源受限场景的重要折中方案。
27B与中等MoE:社区真正在意的是什么
帖子中反复出现的两个关键词是“27b size”和“reasonable mid tier MoEs”。这反映出社区用户的核心诉求:他们并不反对模型变大,但希望产品线保持梯度,让不同资源条件的用户都有选择。
27B级别的密集模型在单卡或少量GPU上即可运行,适合中小团队进行微调和部署。而中等规模的MoE模型则通过稀疏激活在推理时只调用部分参数,能在控制计算量的同时保留较大的总参数量,被许多人视为兼顾性能与效率的方案。如果Qwen 4.5和Qwen 5只向超大参数方向演进,而砍掉这些中间档位,社区用户的迁移成本会显著上升。
27B级别的密集模型之所以成为社区关注的“甜点尺寸”,与其硬件适配性密切相关。以FP16精度计算,27B模型约需54GB显存,经过4-bit量化后可压缩至约14-16GB,恰好能在单张24GB消费级显卡(如RTX 3090/4090)或少量专业卡上运行。这一尺寸在微调、本地推理和中小规模部署中具有较高的性价比,既不像7B模型那样能力受限,也不像70B以上模型那样需要多卡并行。对于开源权重模型而言,保留这一档位意味着维持了一个活跃的开发者生态,使研究和应用创新不必完全依赖云端API。
规模竞赛下的隐忧与期待
从公告截图的表述来看,官方对参数增长的态度带着一丝自嘲意味,但方向是明确的。对于Qwen这样的开源权重模型系列而言,大规模版本和中小规模版本其实可以并行存在——前者用于冲击能力上限,后者用于维持生态活跃度。
帖子的讨论也折射出开源模型社区的一种普遍心态:既期待更强模型带来的能力跃升,又担心自己常用的尺寸被边缘化。Qwen 4.5和Qwen 5最终会推出哪些尺寸、27B档位是否保留、中等MoE是否会成为新的主力,目前仍是未知数。但可以确定的是,参数规模的竞赛不会很快停下,而如何在“更大”与“可用”之间取得平衡,将是Qwen团队需要认真回答的问题。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。