Qwen 4 Max实测:中国前沿模型挑战Opus 5.5
Qwen 4 Max裸环境五小时造出可玩Minecraft,性能比肩一线且成本极具优势。
YouTube科技频道对Qwen 4 Max进行深度实测,在无技能、无扩展、无MCP服务器的裸环境下,仅凭单一提示词让其独立构建Minecraft风格游戏,耗时约五小时。基准测试中该模型多数项目超越Kimi K3,部分智能体任务可与Opus 5.5、GPT 6.1 Sol比肩。官方API定价为每百万输入token 1.50美元、输出4.50美元,第三方平台折扣可达86%,实测缓存命中率高达99.8%,实际成本远低于标价。生成游戏具备生存、采矿、冶炼、合成等完整循环,视觉氛围获好评,但存在方块纹理侧向显示、水中无法脱困等系统性缺陷,综合表现与Carbon同档,更接近Gemini水准。
在AI模型竞争白热化的当下,一款来自中国的前沿模型正引发海外开发者的关注。YouTube科技频道对Qwen 4 Max进行了一次深度实测,通过让模型在没有任何技能、扩展或MCP服务器辅助的情况下独立构建Minecraft风格游戏,检验其真实编码与推理能力。
基准测试定位:跻身第一梯队
根据视频作者的评测数据,Qwen 4 Max在多数基准测试中得分超过Kimi K3,同时对前代Qwen 3.8形成明显压制。在部分测试项中——尤其是智能体综合考试类任务——它甚至能与Opus 5.5和GPT 6.1 Sol比肩。作者也坦言,由于同期还有更新的模型变体存在,这种跨代比较需要谨慎看待,但整体表现依然令人印象深刻。
这一结果释放出一个明确信号:中国模型与国际顶尖模型之间的差距正在快速收窄。Qwen 4 Max不是一款"追赶型"产品,而是具备前沿竞争力的选手。
智能体综合考试类任务(agentic benchmark)指的是评估模型在需要多步骤规划、工具调用与环境交互的任务中表现的测试集合,典型如GAIA、SWE-bench、AgentBench等。与单轮问答不同,这类基准要求模型自主拆解目标、调用外部工具、根据中间反馈调整策略,因而更接近真实开发场景中的自主编码能力。视频中Qwen 4 Max在该类任务上与Opus、GPT系列同档,说明其长链路推理与自我纠错能力已达前沿水平,这也是后文五小时裸环境构建游戏的测试逻辑基础。
API定价:性价比成为核心优势
Qwen 4 Max的官方API价格约为每百万输入token 1.50美元、每百万输出token 4.50美元。对于一款前沿级别的模型而言,这个价位在同类产品中具备显著竞争力——视频作者将其与Fable 5.2、Opus 5.5和GPT 6.2 Sol进行了直接对比。
更值得关注的是第三方聚合平台上的折扣空间。视频中提到的Quartzrouter将价格压至每百万输入token 0.62美元、输出token 0.67美元,相当于约86%的折扣幅度。对于高频调用场景,这种成本结构意味着数量级更低的推理开销。
MCP(Model Context Protocol) 是由Anthropic提出并开源的标准化协议,用于让模型以统一方式连接外部工具、数据源与技能服务。加载MCP服务器后,模型可调用文件系统、数据库、浏览器等外部能力,相当于为其配备"外挂工具箱"。评测中刻意不加载任何MCP服务器与扩展,目的是排除工具辅助带来的性能加成,纯粹考察模型自身的编码、规划与上下文管理能力——这也是"裸环境"测试的含义所在。
实战评测:五小时构建可玩游戏
评测方式颇为硬核:仅提供一个统一的提示词,不加载任何技能、扩展或MCP服务器,让模型在纯裸环境中完成任务。Qwen 4 Max耗时约五小时完成,是本次横向对比中耗时第二长的模型,仅次于Fable。
生成结果包含生存世界、生物群系、采矿、冶炼、合成等完整循环。具体表现可圈可点:
- 基础机制:冲刺、蹲伏、坠落伤害、火把照明、熔炼系统均正常工作
- 视觉表现:黄昏渐变为紫色的天空、星空与云层渲染获得作者高度评价
- 地形生成:整体地形质量优秀,水中的游泳动画流畅度可媲美Carbon
问题同样存在。所有方块纹理呈侧向显示——合成台、熔炉、铁镐无一例外;沙子在创造模式下不会坠落;角色在水中无法自行脱困,而在前沿模型中类似缺陷仅见于GPT 6.2 Astra。游戏内没有剑类武器,战斗系统相对简化。
缓存命中(cache hit) 指请求的上下文前缀与之前调用完全一致时,服务端直接复用已计算的KV缓存,仅对新增token做前向计算。主流厂商通常对缓存读取token收取远低于标准输入的价格(常见为10%甚至更低)。99.8%的缓存读取占比意味着在多轮长对话或长链路编码任务中,绝大部分上下文都被低价复用,实际账单可能只有标价的零头。这也解释了为何标价看似普通的模型,在高频、长上下文场景下会展现出数量级的成本优势。
横向对比:与Carbon并驾齐驱
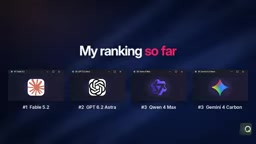
在作者的模型排名中,Qwen 4 Max与Carbon处于同一档位,部分维度甚至略优于Carbon。它在视觉氛围营造上接近Fable 5.2,但纹理方向的系统性问题拖累了整体完成度。作者给出的判断是:Qwen 4 Max的综合表现"更接近Gemini而非Fable",属于扎实可用但仍有改进空间的水准。
值得注意的还有极端的缓存命中率——实测中缓存读取占比高达99.8%,意味着绝大部分token消耗走的是低价缓存通道,进一步压低了实际使用成本。
纹理坐标(UV mapping)与方块朝向 是体素游戏渲染的基础工程问题。每个方块面需要正确绑定纹理坐标并按法线方向选择贴图,若模型在生成代码时统一套用同一朝向的纹理映射,就会出现"所有方块纹理侧向显示"的系统性错误。这类缺陷不影响逻辑可玩性,却极大破坏视觉完成度,且往往需要在渲染管线层面统一修复,而非逐个方块打补丁——它反映的是模型对三维空间坐标变换的理解深度,也是当前前沿模型在图形编程任务中的典型短板。
对开发者的启示
Qwen 4 Max的实测结果揭示了一个趋势:前沿模型的能力边界正在从"能否完成"转向"完成得多精细"。五小时生成的可玩游戏在核心玩法上已具备可玩性,剩下的差距集中在纹理坐标、物理规则等工程细节层面。
对于需要长链路自主编码的场景,这款模型在成本与能力的平衡上提供了一个有吸引力的选项——尤其在缓存命中率极高的实际调用模式下,单位任务的综合开销可能远低于标价所示。而对于追求极致视觉完成度的项目,纹理方向这类系统性缺陷仍需要人工介入或后续版本修复。
相关推荐
Qwen 4 Max对决Gemini 4 Hydrogen:实测游戏开发谁更强
实测对比Qwen 4 Max Preview、Gemini 4 Hydrogen与Gemini 4 Argon的游戏开发生成能力:从Minecraft克隆、3D射击到SVG交互动画,跑分最高的模型未必最好用,揭示AI编程模型选型的实战盲区。
Qwen 4 Max发布:低价混合跑分,谷歌Gemini新模型曝光
Qwen 4 Max 正式上线:2.4 万亿参数 MoE 架构、100 万 token 上下文,API 价格大幅下调但终端任务跑分落后 Opus。同时谷歌 Gemini 4 的 Oxygen、Krypton 模型曝光,GPT-6.2 Sol 疑似灰度,Anthropic 研究员预测超人类 AI 约 1.3 年后到来。
GPT-6.2 Astra发布:重建巴黎、百万级游戏生成与NVIDIA机器人革命
一周AI速览:OpenAI发布GPT-6.2 Astra与Sol,Google测试Gemini 4 Oxygen和Neon,阿里Qwen4Max与腾讯HY4 Flash以低价生成完整游戏,NVIDIA Groot 2让机器人看演示即学,加州起诉OpenAI。