Qwen 4 Max预览版实测:百万上下文与基准争议

Qwen 4 Max Preview 成本极低、原生生态内生成密度高,但基准与 3D 导航暴露短板。
阿里巴巴发布 Qwen 4 Max Preview,支持 100 万 token 上下文、最高 39.3 万输出 token,token 套餐下输入成本约 2-3 美元,并兼容 OpenAI 与 Anthropic API 格式。由于官方未发布指标表,社区实测成为主要参考:GameFeel RE 基准得分 10.3,落后于 Qwen 3.8 系列甚至未发布变体;ARI Bench 准确率 23%,远逊前沿模型。但在原生生态内,它以 83,173 token 单次完成复杂程序化生成,30 分钟任务对比竞品 70 分钟、6.30 美元,成本优势显著。外部框架下则出现响应迟缓、参数遵循失败和逻辑幻觉,3D 车辆导航 125 分钟仍未收敛。社区投票中 56% 用户认为其能力与 Claude Opus 4.8 相当。
阿里巴巴近期发布了 Qwen 4 Max Preview,带来 100 万 token 上下文窗口、开启推理后最高 39.3 万输出 token 的支持,以及高达 80% 的促销折扣——在 token 套餐模式下,输入成本被压到约 2-3 美元。官方文档承诺在智能体工作流和编程能力上有大幅跃升,但首批独立图形渲染测试和技术基准却揭示出不同工具之间的巨大差距。
发布渠道与计费模式
Qwen 4 Max Preview 直接上线 QwenWork、Coder、QwenApp 和 QwenStudio,同时通过 AI Hub Mix 等聚合平台覆盖文本、图像和视频模态,API 兼容 OpenAI 与 Anthropic 两种格式。开发者 XODUD 确认,预览版仅运行在 token 套餐模式下,11 月 25 日之前没有按量付费选项,而且 Qwen 团队并未发布官方指标表。
正是官方数字的缺失,让社区测试成为主要参考。据 YouTube 频道汇总的多方实测,该模型在不同环境下的表现差异显著,这一点值得潜在用户特别留意。
Token 套餐模式指的是平台按固定月费提供一定额度的 token 用量,超出部分另行计费或降速,与传统的按量付费(pay-as-you-go)相对应。对开发者而言,套餐模式下的“输入成本 2-3 美元”通常是按套餐价格折算出的每百万 token 等效单价,而非直接标价,因此实际支出会随调用密度和套餐档位浮动。
API 兼容 OpenAI 与 Anthropic 两种格式意味着开发者可以沿用现有的 SDK、工具链和提示词结构,无需重写接入层即可切换模型。这降低了迁移成本,但也可能掩盖模型在原生环境外的行为差异,后文提到的外部框架兼容性问题正与此相关。
基准测试的争议:GameFeel RE 与 ARI Bench
第一个实证冲击来自 Bebu 分享的 GameFeel RE 基准,该基准覆盖超过 8,000 个编程与游戏设计任务。Qwen 4 Max Preview 得分 10.3,落后于 Qwen 3.8 Max 的 12.1 和 Qwen 3.8 Flash Next 的 13.0。
同一张技术图表上,未发布变体的分数反而更高:开源权重模型 Qwen 427B Early(代号 QDuck)拿到 14.9,超过 Sonnet 5.5 Extra High 的 14.3;Qwen 4 Flash Early(代号 QHawk)则达到 19.9,轻松越过 Claude Opus 5.5 Medium 的 15.3。创作者 Follistatin 确认了 GameFeel RE 上的低分,并指出一个悖论:该模型在所有评估系统中成本结构第二低,指数却如此疲弱。
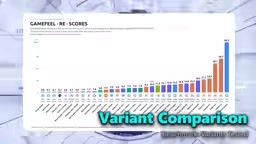
在面向递归 AI 自我改进的参考基准 ARI Bench 上,Qwen 4 Max Preview 在 Extra High 模式下据该基准官方账号数据达到 23% 准确率,仍远落后于 GPT-6 Astra 和 Opus 5.5 等前沿模型。
开源权重模型(open-weight)指模型参数可公开下载、允许本地部署和微调的发布形式,区别于仅提供 API 访问的闭源模型。文中提到的 Qwen 427B Early、Qwen 4 Flash Early 属于尚未正式发布的早期变体,其分数出现在同一张技术图表上,说明这些数据可能来自内部或预发布测试,与正式版 Preview 并非同一评测口径。
ARI Bench 是面向递归 AI 自我改进(recursive self-improvement)的参考基准,考察模型在迭代改进自身输出或代码时的准确率。这类基准的分数对提示策略和推理模式高度敏感,23% 的准确率需结合 Extra High 推理档位来解读,不宜直接与通用能力基准横向比较。
单次生成能力:高密度推理与成本优势
在实际单批次程序化生成测试中,创作者 AJ 要求模型仅用代码构建一片处于秋日巅峰的枫树与桦树林,包含树木、持续动画和交互控制,不使用外部工具、测试框架或第三方库。Qwen 4 Max Preview 完整执行了请求,在一次高密度推理调用中消耗 83,173 个 token,交付可用的场景控制和原生代码合成音频。这一 token 用量甚至低于 DeepSeek广告 v4.1 Flash 10.17 在同一任务上的消耗。
在另一项模拟海岛灯塔环境的程序化测试中,Qwen 4 Max 单次生成了 3D 网格、光照循环和交互控制面板。
成本对比同样鲜明。开发者 JAZII 用相同的高复杂度最大推理提示词对比 Qwen 4 Max Preview 与 Minimax M3.1 Flash:Qwen 4 在 30 分钟内完成处理,在 Coda 促销层级下成本可忽略不计;Minimax M3.1 Flash 则需要 70 分钟,并为同一任务计费 6.30 美元。
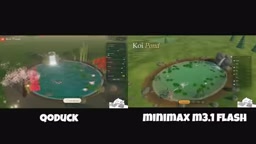
但 JAZII 通过 cloud code 在模型原生环境之外测试时,遇到了响应迟缓、参数遵循失败和逻辑幻觉等问题,指向外部测试框架的兼容性问题。
程序化生成(procedural generation)指通过代码规则而非手工建模来动态构建场景、地形或动画内容,常见于游戏开发。在语言模型语境下,它考验的是模型能否一次性写出结构正确、可直接运行的代码,而非仅生成描述性文本。
单次高密度推理调用指模型在开启推理模式后,于一次请求内完成大量内部思考并输出完整结果,83,173 个 token 的消耗同时包含推理过程与最终交付内容。这一指标反映的是“一次成型”的能力密度,与分多轮对话逐步搭建的工作流不同,成本对比时需注意口径一致。
执行环境敏感性:原生应用与外部框架的落差
Bavi 在 Coder 内运行的 Rooster Run 挑战进一步拆解了这种环境敏感性。在阿里巴巴自家应用内,Qwen 4 Max Preview 用 11 分钟完成交互式生成,而 DeepSeek v4.1.10.17 编译同一结构耗时 34 分钟。
在纯 HTML 游戏开发中,Mark Santos 要求模型直接在浏览器中构建经典 Crossy Road 可下载文件。Qwen 4 Max Preview 和 Claude Opus 5.5 Medium 都生成了可玩版本,具备完整穿越机制和有效碰撞,后者在物理响应性和打磨度上以微弱优势胜出。
矢量动画方面,视觉复杂度分化了结果。用户 Shiax 使用 Coder 生成骑自行车的鹈鹕 2D SVG 动画,注意到元素恢复和指令遵循相比实验性 Kodak 模型有明显提升,但美学上没有重大飞跃。创作者 LeoBuildingWithAI 用同一提示词观察到矢量几何的渐进式进步。官方 Coder Profile 同时报告,在 Qwen 4 Max 发布前悄然运行四天的 Kodak 测试构建,在一个 HTML 文件中生成了 68 个可导航房间的体素白屋和漂浮宫殿。
叙事与 3D 任务:连贯性有余,视觉打磨不足
在叙事模拟方面,Leo 对比 Qwen 4 Max Preview 与 Claude Fable 5.2 制作后末日废墟中的机器人戏剧动画。Qwen 4 需要 2 到 3 小时来梳理故事弧线并渲染可用场景,叙事连贯性得以保持,但与 Fable 5.2 相比视觉打磨差距明显。
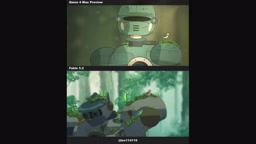
在纯美学 SVG 任务中,例如机械玻璃孔雀开屏动画,Leo 注意到平滑的插值数学和透明度处理;在十二生肖静态渲染图上,Qwen 4 Max 超过 DeepSeek V4.1 Flash,视觉保真度仅次于 GPT-6 Astra。Leo 在 24 小时测试后发起的开发者投票中,56% 的用户认为预览版整体能力与 Claude Opus 4.8 相当,26% 认为对标 Opus 5,13% 认为等同 Sonnet 5。
3D 处理经由 DeepSeek 测试框架时,用户 Shiaks 报告在生成雨夜便利店场景时质量下降,Qwen 4 Max 的光照偏平、纹理弱于此前的 Kodak 预览测试。Leo 在生成漂浮体素宝塔时确认了这种 3D 迟缓:整整一小时的渲染仅换来接近 DeepSeek V4.1 Flash 的几何密度。
参数化资产与空间计算:亮点与短板并存
在游戏引擎参数化资产领域,创作者 Wass3 报告称,Coder 内一条提示词生成了复杂的工业 3D 模型,每个组件单独命名,网格干净解耦,具有真实世界比例单位和干净拓扑,可直接导入 Blender 而无需手动清理。
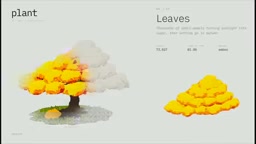
Qwen AI 粉丝记录的体积植被分析中,模型将一棵果园树分割为 92,582 个体素,分离并量化出占总量的 81.3% 的叶体积,展示了对有机结构的锐利空间计算能力。
但物理控制动力学暴露了 3D 车辆导航的严重局限。开发者 Lu Yao 记录了语言模型在 3D 驾驶环境中操控车辆的系列测试:腾讯混元用 56 分钟完成赛道并冲线,DeepSeek V4.1 用 82 分钟完赛,而 Qwen 4 Max Preview 需要 125 分钟连续执行,在空间轨迹计算上反复失败——车辆被冲下悬崖、一遍遍重启,始终未能收敛到赛道上。
财务侧,创作者 IAM 以 GPT 6.1 Sol Ultra 为参照测试,发现生成一个完整照片级真实场景大约耗时一小时,仅消耗其 5 美元月度 token 套餐的 1.5%。平台层面,Leighton Gott 指出 Qwen 4 Max 集成已在 ClaudeCode、Codex、Cursor 和 OpenCode 上运行,基础月订阅在 60% 左右。
技术社区讨论中,MD Ismail Sojal 提出,计划以开源权重发布的稠密 270 亿参数变体,在高端本地硬件上可能比当前的 Max Preview 提供更强的实际效率,尤其考虑到阿里巴巴已开始推广的、大量依赖推理驱动的自我改进。
Qwen 4 Max Preview 的画像因此相当分裂:在原生生态内,它以极低成本和可观的单次生成密度完成复杂任务;而在外部框架和 3D 物理导航等场景下,环境敏感性和空间推理短板则清晰可见。对开发者而言,选择它还是等待开源稠密版本,取决于工作负载究竟落在它擅长的区间,还是踩中它的软肋。
体素(voxel)是三维空间中的体积像素,常用于体素建模和游戏中的可破坏地形。文中“92,582 个体素”与“叶体积占 81.3%”体现的是模型对有机结构进行空间分割和量化统计的能力,属于空间计算范畴,与生成网格模型是两类不同任务。
参数化资产指带有命名组件、真实世界比例单位和干净拓扑的 3D 模型,可直接导入 Blender 等工具而无需手动清理。拓扑干净意味着网格面数合理、边流顺畅,是资产能否直接用于生产管线的重要判据,也是衡量模型输出工程可用性的关键标准。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。