Qwen 4 Max预览版实测:性能追平Opus,但有两周寿命和订阅限制

Qwen 4 Max Preview 性能追平 Opus 5.5,但订阅限制与两周寿命使其难以实用。
文章记录了一位创作者对阿里 Qwen 4 Max Preview 的四项实测对比。该预览版支持多模态与 100 万 token 上下文,但发布无跑分、无模型卡,且仅支持订阅套餐、禁止自动化脚本,预览期约两周后退役。测试中,Qwen 在真实外包工单的 12 项隐藏校验中与 Claude Opus 5.5 同为满分,鬼屋游戏和鹈鹕骑车动画也未翻车,成本远低于对手;但在需要打开项目文件夹的找虫测试中因聊天界面限制无法进行,且多次运行长时间无响应。结论是模型本身能打,但接入方式混乱、寿命过短,只适合预览期做前端副模型,正式版才值得关注。
阿里通义千问家族的下一代旗舰模型 Qwen 4 Max Preview 已经开放预览,官方称其为面向编码、办公、前端设计和复杂智能体任务的多模态旗舰。一位 YouTube 创作者用四项实测把它和 Claude Opus 5.5 放在一起对比,结论很有意思:模型本身能打,但你可能根本用不上它。
一个没有数字的旗舰发布
阿里对 Qwen 4 的发布方式相当克制。官方文档把 Qwen 4 Max Preview 描述为下一代旗舰多模态模型,支持文本、图像和视频输入,上下文窗口达到 100 万 token,思考模式默认开启,并提供低、中、超高(extra high)三档推理强度——注意没有单独的"高"档,这一点在后面对比时会成为变量。
但发布帖只有三句承诺:更深的知识、更丰富的世界理解、更强的编码与智能体能力。全文超过百万浏览,却没有一个跑分数字、没有模型卡、没有参数规模,也没有开放权重。换句话说,想本地部署这条路直接堵死。
更少见的是它的保质期。官方文档写明预览版运行到 11 月 25 日,之后模型即退役,前后大约两周,且没有说明替代方案或正式版 Qwen 4 Max 的上线时间。
上下文窗口(context window) 指模型单次推理能容纳的 token 总量,包含输入提示与已生成内容。100 万 token 大致相当于数十万汉字或上千页技术文档,意味着模型理论上可一次性读完大型代码库或长视频字幕再做回答。但窗口大小不等于有效利用:模型在超长上下文中的检索与推理精度通常随距离衰减(即“中间遗忘”现象),且更多输入 token 会显著抬高延迟与费用。因此 100 万 token 更适合作为“能塞进去”的能力上限,而非默认工作方式;实际使用时仍需分块、检索或摘要来保证稳定性。
购买渠道:没有按量付费,只有订阅
Qwen 4 Max Preview 的接入方式被多位测试者称为"一团乱麻"。官方明确表示不支持按量付费 API,只能走 token 套餐订阅:Lite、Essential、Standard、Pro 四档,新用户可低价试用 Lite。预览期间消耗以远低于正常费率计算。
但细则是关键:该套餐仅限在 Claude Code、Cursor、Qwen Code 等工具内交互式使用,明确禁止用于自动化脚本或批处理任务,违规可能导致密钥被封禁。个人套餐开通后暂不支持取消,额度用完只能等下个月。
创作者实际购买了 Qwen 应用 19 美元/月的 Plus 套餐,发现 Qwen Code 终端里只提供上一代的 Qwen 3.8 Max 和 Flash——这直接决定了测试方式:Qwen 4 只能在应用聊天界面里跑,没有终端、不能执行和验证自己写的代码。
按量付费 API 与 token 套餐订阅是两种不同的计费范式。按量付费按实际输入/输出 token 计费,适合自动化流水线、批处理和弹性负载,成本随用量线性浮动;套餐订阅则是预付固定额度,超出后限流或停用,通常绑定交互式产品界面。套餐常附带使用条款限制(如禁止脚本调用),因为其定价假设是低频、人工触发。对开发者而言,这意味着即使模型能力足够,若缺少按量付费通道,就无法把模型嵌入 CI、定时任务或多用户服务,只能作为“副驾驶”式辅助工具使用。
第三方评分缺席,只能参考上一代
在 Artificial Analysis 榜单上,Qwen 4 查无此模型,也就没有独立评分。可参考的是上一代 Qwen 3.8 Max 在智能指数上得 34 分,而 Opus 5.5 在高推理档为 52 分、Max 档为 59 分。差距明显。
价格方面,Qwen 3.8 Max 的输出 token 价格约为 Opus 的三分之一。但创作者提醒,跑完一项基准任务的成本两者几乎持平——便宜 token 不等于便宜任务。由于 Qwen 4 尚未公布价格,测试中所有成本均以 Qwen 3.8 Max 费率为替身估算,且不计入隐藏思考消耗,真实成本只会更高。
Artificial Analysis 智能指数是第三方评测机构对主流模型做的综合基准聚合,通常混合知识问答、推理、编码、数学等多项测试并折算为单一分数,便于横向比较。它不等同于官方跑分,也非针对具体任务的绝对能力指标;分数受推理档位、提示方式与评测版本影响,同一模型在不同档位可能相差数分。指数的主要价值是提供相对排序与代际差距的粗略量级,而非预测某一工单能否通过。文章引用上一代 Qwen 3.8 Max 的 34 分与 Opus 的 52/59 分,只能说明历史代际差距,不能直接外推到未上榜的 Qwen 4。
首日作品与那个翻车的鹈鹕
上线首日社区作品看起来很热闹:故事写作应用、3D 下坡狐狸游戏、汽车展厅、餐厅网站。但翻一翻会发现,不少帖子结尾句式雷同,都附带"限时折扣"的推广语。创作者无法证实是否付费推广,但指出部分演示甚至不是这个模型——发布前 Coder 曾以代号运行早期测试版本数天。
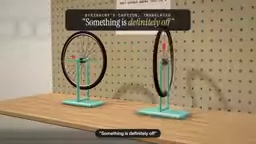
X 上传播最广的一次测试(查看时约 19.5 万浏览)是失败案例:3D 鹈鹕骑自行车,轮子像硬币一样乱转。原作者没有公开提示词,评论区索要也未获回应。这成为创作者第三项测试的起点。
四项实测:聊天窗对终端,怎么比
这次测试的方法学不得不妥协。往常每个模型都作为编码智能体在独立文件夹里运行、执行、自纠错,Opus 5.5 就是这样在 Claude Code 高推理档跑的。Qwen 则在应用聊天界面里、思考模式、开启联网搜索(Opus 关闭)的条件下作答,一次成稿、无法运行验证,构建时间并非同口径对比。
测试一:第一人称鬼屋恐怖游戏
Opus 耗时 36 分钟,中途因 15 分钟未保存被框架重启一次,最终产出月光走廊、吊灯、手电筒光锥、理智条和幽灵,提示语设计到位,API 等价成本约 4.72 美元。
Qwen 用了 22 分钟,开场即有标题界面,几秒内就能看到走廊尽头的幽灵、落地钟、楼梯和吊灯,零报错。更意外的是它写完整个文件后自我检查,声称发现结构性错误,随后在同一回答里重写了完整游戏,约 99 KB,测试采用修正版。估算成本仅几十美分级别——但这是第二次尝试,第一次用应用的网页开发模式跑了 27 分钟,只回了"测试已结束",没有文件。
测试二:真实外包工单(含 12 项隐藏测试)
一封来自单人设计工作室的混乱邮件:起初要求每张发票含税,最后一封又说会计确认设计工作免税、只有印刷行计税;逾期费比例含糊,月付还是一次性不明。模型要建应用并回邮件,随后由 12 项未见过的隐藏测试校验发票号、到期日、提醒、分批付款、四舍五入和税务逻辑。
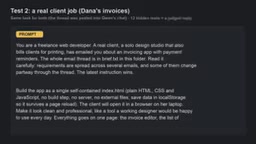
结果:Opus 12/12,Qwen 12/12。两者都捕捉到税则变更,都以同样聪明的方式处理逾期费——不臆测,回信请客户确认。回信由两个不参与对决的裁判模型按隐藏评分表打分,双方均获满分。差距只在时钟和成本:Opus 约 8 分钟、2.40 美元;Qwen 首次尝试即完成,耗时约 30 分钟,成本约十几美分级别。
这是最能说明问题的测试——在真正付钱的工作上,预览版完全跟上了。
测试三:鹈鹕骑自行车
自拟提示词:日落海岸公路,3D 鹈鹕骑车,含跟随、侧面、正面、俯视四个机位。Qwen 第一次跑了 18 分钟只回"请求已结束",第二次约 24 分钟完成交付。成片有灯塔、海面落日、车灯光束和控制面板,侧视图里鹈鹕踩在踏板上,车体结构正常,病毒片段里那种"轮子像硬币翻转"的画面在所有帧中都没出现。Opus 用 22 分钟、约 5.40 美元,多了车篮、海鸥和礁石,一键切换四个视角。
创作者判断:那段爆款大概率是单次坏运气,或者是一个永远不会公开的提示词。
测试四:极端找虫——没有成绩
约 3000 行、42 个文件的开票后端,植入 16 个真实 bug(多数跨文件才显现,包括并发双扣款、税额取整错误、越权读取他家发票的安全漏洞),外加 11 个伪装成 bug 的诱饵,模型不被告知 bug 总数,隐藏测试判分,改坏功能要扣分。
Opus 8 分多钟完成、2.24 美元,修复 15/16,零回归,甚至修好了上次基准中漏掉的缓存竞态问题。
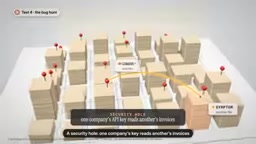
Qwen 没有成绩。聊天应用无法打开项目文件夹,只能把整份代码(约 12.8 万字符)贴进去,两次发送都卡在人机验证滑块前,请求从未启动。这不是 Qwen 输了,而是这个应用根本不接受完整代码库。
编码智能体(coding agent)与聊天界面的本质差异在于执行闭环。智能体可读写项目文件、运行测试、读取报错并迭代修正,因而能处理跨文件、需验证的任务(如找虫、重构、并发修复);聊天界面只能接收粘贴的文本并一次性输出代码,无法打开目录、运行程序或确认修复是否引入回归。文章中的找虫测试之所以无法进行,正是因为约 3000 行、42 个文件的项目超出“粘贴进对话框”的可行范围,且人机验证拦截了超长输入。这说明模型能力与产品形态是两件事:同一模型封装在不同接入方式下,可完成任务的上限会相差一个量级。
谁该用它,谁该再等等
四项测试里,唯一有标准答案的工单测试,Qwen 4 Max Preview 与 Opus 5.5 打平;鬼屋更吓人,鹈鹕也没翻车。但整个故事的关键词是"接入":不能按 token 购买,可购套餐禁止自动化,付费套餐里 Qwen Code 不提供该模型,只能在无终端的聊天应用里跑,三次运行在 18 到 45 分钟后无响应,且两周后这个具体模型就退役。
创作者的结论很务实:如果你已在 Coder 或 token 套餐内,想要一个打折的前端副模型,趁预览期试试可以,但别把任何需要"下个月还活着"的东西建在上面;他自己的转售业务需要定时脚本取数,恰好被套餐禁止,所以日常仍用 Claude Code 里的 Opus 5.5。
真正值得关注的是正式版:如果完整 Qwen 4 Max 配上正规 API 和明确价格,并保持这个水准,头部厂商确实要紧张一下。
你会把项目建在一个只有两周寿命的模型上,还是等正式版?
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。