Qwen3 27B + DeepSeek Harness:本地AI告别前沿大模型
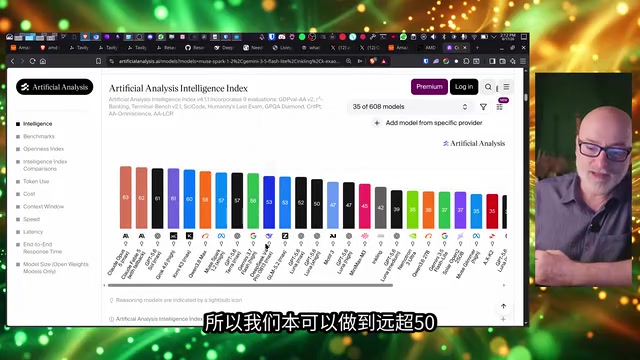
新版Qwen3 27B实测进步约30%,但搭配DeepSeek Harness工具框架让本地模型首次真正替代云端前沿大模型。
一位长期使用本地大模型的测评者在上手新版Qwen3 27B后给出了复杂评价:官方基准数据显示软件工程任务从49.3跃升至79,但实测同量化精度下仅有约30%提升,未能达到预期的质变层次。真正的惊喜来自DeepSeek同期发布的工具框架Harness——它通过智能上下文压缩与任务追踪,让本地模型的有效工作长度大幅延伸,支持累计3800万token的稳定长会话。作者用这套组合构建了能自主控制浏览器的本地智能体,并在24小时高强度使用中从未需要切换到云端前沿模型。他将此称为继OpenCode之后又一个"DeepSeek时刻",认为工具框架的突破比模型本身的进步更具实质意义。Harness采用MIT许可证,可自由商用,对追求数据主权的开发者而言是一次实质性推进。
当新一代 Qwen3 27B 模型发布时,不少本地 AI 爱好者满怀期待。一位长期使用上一代 Qwen3 27B 作为日常主力、甚至专门购置搭载 5090 显卡新机器的 UP 主,在上手测试后却给出了一个复杂的评价:模型本身的进步没有想象中惊艳,但它与 DeepSeek 新推出的工具框架 Harness 组合,却让他彻底摆脱了对云端前沿大模型的依赖。
这篇文章基于该 UP 主的实测分享,拆解这次升级的真实收益、工具框架带来的「DeepSeek广告 时刻」,以及运行本地大模型的硬件现实。
模型升级:进步明显,但没到「下一个层次」
从官方基准数据看,新版 Qwen3 27B 的提升相当可观。智能体解码从 13.3 跃升到 42.2,软件工程类任务从 49.3 提升到 79,前沿智能体任务更是从 10.6 翻倍到 20。这些数字让它一度被拿来与 Opus 4.6 这类顶级模型对比。
但 UP 主的亲身测试给出了更克制的结论。他用上一代 Q6 量化版本与新版 Q5 做漏洞查找对比,发现旧版 Q6 反而比新版 Q5 多找到一个 bug。为公平起见,他改用相同量化精度(新旧版本均为 Q6)重新对比,这才看到差异——大约 30% 的提升,明显但谈不上质变。
他的失望来自更高的预期。参照 Luna 等模型在加入推理能力后的跳跃(非推理 27 分,开启推理后一路攀升至 47 分,能力翻倍有余),他原本期待新 Qwen 叠加模型本身的进步与推理能力增强,能冲到 50 分以上,达到 DeepSeek 或 GLM 顶配的水准。但实际结果大约停留在 40 分左右。「可能是我期望太高了」,他如此自我调侃。
真正的惊喜:DeepSeek Harness 工具框架
模型没达到预期,但这次分享的核心好消息在工具层面。UP 主强调一个常被忽视的观点:智能不只关乎模型本身,还关乎围绕它构建的工具框架。
他此前长期使用 Hermes 搭配 OpenCode,但在 Hermes 推出订阅服务后对其产生动摇。恰在此时,DeepSeek 发布了名为 Harness 的全新工具框架,并打出「一切皆插件」的设计理念——这与他自己构建系统时「一切皆附加组件」的思路高度契合。他甚至没有手动安装,而是直接让 Hermes 帮他完成了 Harness 的安装与模型配置。
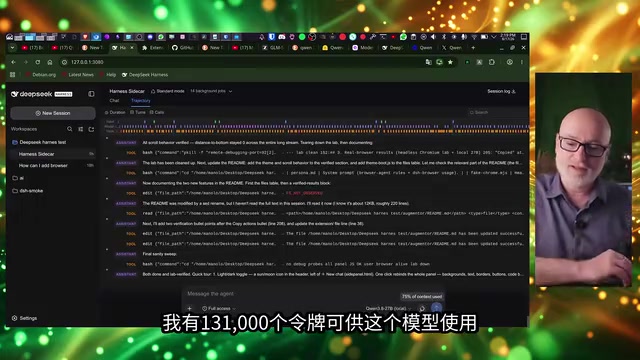
Harness 最让他惊叹的是上下文窗口的管理方式。框架会跟踪所有已完成的任务,从而对上下文窗口的占用更省。在他的 32GB 显存机器上,模型可用约 1.3 万 token,但这些 token「持续得更久、压缩更稳固」。他展示了一个已经运行很久、累计输入达 3800 万 token 仍稳定运行的会话。作为对比,Harness 目前仍是「开发者预览版」,偶尔会在压缩时机不当时崩溃,但只需一句「继续工作」即可恢复。
**上下文窗口(Context Window)**是大语言模型一次能"看到"的文本总量,直接决定了模型在长对话或复杂任务中的记忆边界。本地运行的小参数模型受限于显存,可用上下文往往远小于云端模型。Harness 的创新之处在于通过任务追踪与智能压缩,让有限的 token 配额"利用率"更高——已完成的子任务从活跃上下文中卸载,只保留关键摘要,从而让同等显存下的有效工作长度大幅延伸。这与传统"塞满上下文再截断"的粗暴方式有本质区别,更接近人类在长项目中维护"工作记忆"的方式。
实战:完全本地构建一个浏览器智能体
为验证这套组合的能力,UP 主用它构建了一个名为「增强器(Enhancer)」的代理,作为其 ResonantOS(公正操作系统)的插件。这个代理带有深度搜索工具,能够完全控制浏览器、自动点击并抓取信息。
他给代理下达的任务是:查看某个频道的视频、阅读评论并提出内容创意。代理自主检查了四五个视频、读取评论并给出了建议。他坦言这些创意本身价值有限(因为缺乏频道背景上下文),但重点在于整个流程能够跑通。
最关键的一点被反复强调:全程无需切换到更大的模型。过去用上一代 Qwen3 27B 时,大约 80% 的任务能完成,但遇到复杂难题时他不得不换成云端前沿模型。而在新版模型加 DeepSeek Harness 的组合下,过去 24 小时的高强度使用中,他「一次都没有」感到需要更强的模型。
他将此称为「又一个 DeepSeek 时刻」——但这次的突破不在模型,而在工具,且恰好由 DeepSeek 完成。更重要的是,Harness 采用 MIT 许可证,可自由修改、商用,这对本地 AI 和 AI 主权理念是一次实质推进。
**智能体(Agent)**在 AI 语境中指能够自主规划并执行多步骤任务的系统,区别于单次问答的"对话模型"。其核心在于工具调用能力——模型不仅能生成文字,还能触发外部操作(如浏览器点击、文件读写、代码执行),并根据操作结果调整下一步决策。浏览器智能体是其中门槛较高的一类,需要模型稳定地将自然语言指令映射为精确的 DOM 操作序列,且在页面结构变化时能自我修正。27B 参数量级的本地模型在此前普遍被认为不足以可靠驱动此类任务,这也是作者将这次成功运行视为"DeepSeek 时刻"的原因。
硬件现实:量化精度与显存带宽如何取舍
理解本地运行的局限同样重要。UP 主给出了较为细致的配置建议。
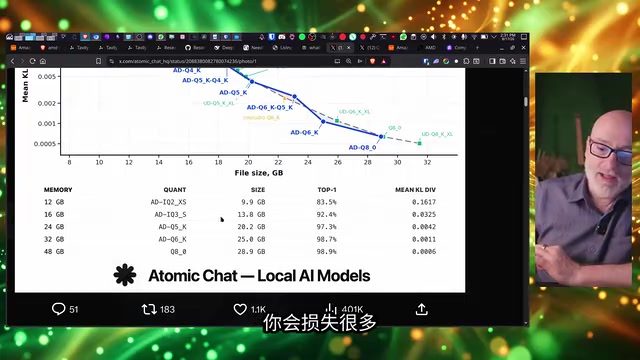
量化精度的权衡:Q6 相比 Q8 仅损失约 0.2% 性能,是值得的折中;Q5 相比最高版本损失约 1.4%–1.6%,总体可接受。但在漏洞挖掘这类精细任务上,Q6 比 Q5 能多发现一个漏洞。他的建议是——需要更大上下文窗口选 Q5,需要高级专项任务则升级到 Q6。
显存与带宽:模型能跑取决于显存容量,但运行速度取决于带宽。
- 官方称最低 12GB 显存可运行,理想为 48GB。他个人认同 48GB,因为能换来更大的上下文窗口。
- 32GB 档位:5090 带宽约 1792 GB/s,在其机器上跑出约 110 token/秒;AMD 同档约 640 GB/s,接近三分之一速度。
- 24GB 档位:3090 二手价格便宜且带宽约 1000 GB/s 性价比突出;AMD 对应卡价格低于 4090 且速度接近。
- 两张 24GB 卡可组成 48GB,他会选 Q6 配合更大上下文,而非 Q8(Q8 速度慢于 Q6)。
- DGX Spark 也能运行,约 20–30 token/秒即可用;华硕版 DGX Spark 带 128GB 内存,可用超大上下文或多实例运行。
量化(Quantization)是将模型权重从高精度浮点数(如 FP16/BF16)压缩为低比特整数表示的技术,以换取更小的显存占用和更快的推理速度。Q8 表示 8-bit 量化(接近原始精度),Q6、Q5 依次降低精度。关键区别在于:显存容量决定模型能否装载,而显存带宽(每秒可传输的数据量,单位 GB/s)决定推理速度——因为每生成一个 token,GPU 都需要从显存中读取全部权重。这解释了为何搭载更高带宽 HBM 显存的 5090(1792 GB/s)比同容量的 AMD 方案(约 640 GB/s)快近三倍,也说明为何量化后的 Q6 版本在速度上有时反而优于 Q8:体积更小意味着带宽消耗更低。
结语:本地 AI 的价值正在变化
总结这次体验,UP 主的态度清晰而克制:新模型没有带来他期待的那种飞跃,真正的质变或许要等到第四代;但 DeepSeek Harness 与 Qwen3 27B 的组合,让他看到了以往从未见过的东西。
他将这种感觉类比为当年 OpenCode(早期名为 Cloudbot)发布时的震撼——人人终于拥有了一个能操控电脑、自主完成任务的代理。如今 DeepSeek 用工具框架实现了类似的跃迁,把一个 27B 本地模型的能力边界大幅拓宽。
结论虽然还为时过早,但一个趋势已然显现:当工具框架足够强大,本地 AI 的实用价值正在以肉眼可见的速度提升。对追求数据主权与成本可控的开发者而言,这或许意味着「告别前沿大模型」不再只是口号。
相关推荐
永生经济学:当时间不再稀缺,价值将如何重构?
SFIA 深度探讨永生经济学:当时间不再稀缺,生物永生、数字意识上传、冷冻复活如何重写劳动、财富与价值规则?从专利强制许可到意识复制的劳动力崩塌,再到意义成为新稀缺品,一场关于永生社会的硬核思想实验。
Claude存储架构大变动:本地与云端的界限正在重划
Anthropic正在调整Claude的数据存储架构。10月6日起Pro/Max新会话将仅支持云端存储,Claude Code保留本地选项,企业版存储位置仍由管理员决定。本文梳理本地与云端的最新界限及对不同用户的影响。
共同主导AI安全训练营:法律与治理从业者的实践启示
一位AI安全训练营的共同主导者分享面向法律与治理从业者的培训经验,探讨跨学科教学的挑战、概念翻译的必要性,以及AI治理人才能力建设对行业的深远意义。