Qwen3-27B超过去年顶尖模型,小模型时代真的来了

271亿参数的千问3-27B在公开评测中拿下34分,超越一年前GPT-4o的23分,家用电脑即可运行。
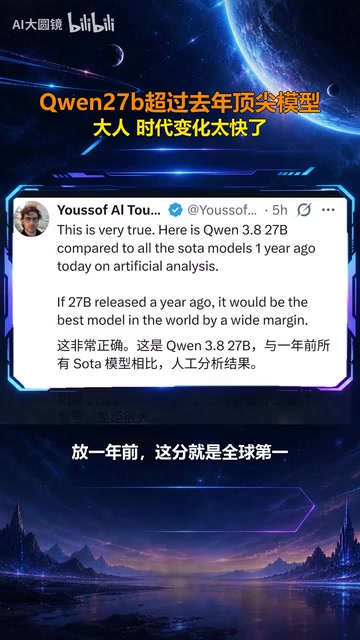
千问3-27B是一台游戏本就能本地运行的271亿参数小模型,在第三方评测机构AI摩卡的新版数学、代码与研究综合测试中拿到34分,超过一年前冠军GPT-4o的23分,高出近一半。虽然距当前顶尖的58分仍有24分差距,但34分放到一年前就是全球第一。该评测的可信度来自模型权重与评测流程完全公开,任何人都能复现验证。这件事的意义不在于分数本身,而在于部署范式的转变:曾经需要机房排队申请的顶级能力,如今正落到个人设备上,标志着小模型时代的加速到来。
一个271亿参数的小模型,把一年前的AI世界第一给超了。这个消息来自B站的一则视频分享,迅速在AI社区引发讨论。模型叫千问3-27B,2026年8月发布,一台游戏本就能带起来。更关键的是,第三方评测机构AI摩卡把它纳入数学、代码和研究能力的综合测试,新版考卷下,千问3-27B拿到了34分,而一年前的冠军GPT-4o只有23分。
34分 vs 23分:分数背后的含金量
从23分到34分,高出将近一半。这个对比之所以震撼,是因为两边代表着完全不同的部署范式。一边是藏在机房里的冠军,普通用户只能通过API调用;另一边是免费下载、家用显卡就能跑的挑战者。
评测机构AI摩卡放出了完整的模型文件和测试流程,用视频里的话说——“谁不服谁自己跑”。这种透明性让分数更有说服力。你可以下载模型、复现评测、亲眼验证,而不是只能相信某个榜单的排名。
不过要客观看待:34分离当前的顶尖水平还有距离。视频提到,现在真正的第一名分数是58分,千问3-27B差了24分。但关键在于,34分这个位置放在一年前,就是全球第一。一年时间,家用级模型追平了曾经的顶级闭源模型。
27B中的"B"是Billion(十亿)的缩写,指模型的参数量——这里的271亿个参数大约对应约54GB的fp16权重,经过4-bit量化后可压缩到约14GB,这正是它能装进一台游戏本的关键前提。参数规模决定了模型的容量上限,但并非唯一决定因素:训练数据质量、训练策略和架构设计同样重要。历史上GPT-3的参数量高达1750亿,而千问3-27B以约六分之一的规模达到相近甚至更强的能力,反映的是近两年训练效率的显著提升。参数量越小,推理时对显存和算力的需求就越低,这也是消费级硬件能够本地部署的根本原因。
为什么这个分数值得信?
一个第三方小机构发布的评测,凭什么让人信服?核心在于可验证性。模型权重完全公开,评测代码和研究方法也一并放出,任何人都可以在自己的硬件上复现结果。
这和传统榜单的运作方式形成了鲜明对比。过去我们只能看大机构发布的排名,模型细节不透明,评测标准不公开。而现在,开源模型加公开评测的组合,让“信任”不再依赖于机构背书,而是建立在可复现的技术事实之上。
当然,单一评测机构的结果仍需更多独立验证。不同评测集、不同任务权重,都可能影响最终排名。但方向是明确的:小模型的能力上限正在快速抬升。
模型权重指训练完成后保存下来的全部参数数值,是最核心的资产。权重公开意味着任何人都能下载完整模型,在自己的硬件上运行、微调或二次开发,而不必依赖厂商提供的API接口。与之相对,闭源模型只暴露一个远程调用入口,用户无法知晓其内部结构、训练数据或具体行为。开源权重但训练数据与过程不公开,属于"开放权重"而非彻底开源,这是目前业界常见的折中形态。开放权重的价值在于:它让第三方可以独立检验模型能力、审计潜在偏见,并在本地离线使用而无需上传敏感数据,因此成为小模型生态快速迭代的重要基础。
家用电脑跑出一年前的世界第一
这个事件最有冲击力的地方,不是分数本身,而是它意味着什么。一年前需要排队申请、机房部署才能用上的顶尖模型能力,现在一台游戏本就能本地运行。
对开发者来说,这意味着可以在本地做更多实验,不必担心API成本和数据隐私。对普通用户来说,高性能AI正在从云端走向个人设备。视频评论区不少人在刷“同意计划”,畅想明年家用电脑还能跑出什么水平。
从“北区机房排队”到“冠军住进你的书桌”,这个转变只用了一年。小模型时代的序幕,可能比我们预期的来得更早。
小模型大趋势
千问3-27B不是孤例。整个行业正在往更小、更高效、更开放的方向走。当27B级别的模型能在消费级硬件上达到一年前顶级闭源模型的水平,AI能力的普及速度就进入了一个新阶段。
接下来的看点很明确:这个趋势会持续多久?下一代家用级模型能追到多少分?以及,当高性能AI变得人人可得,应用层会爆发出什么新的可能性?
答案可能不用等太久。
背景补充
本地运行大模型通常需要借助量化技术,即把原本以16位浮点(fp16)存储的权重压缩为8位、4位甚至更低的整数表示,以大幅降低显存占用和计算量。4-bit量化一般能把模型体积压缩到原版的四分之一左右,性能损失在多数任务上较小。在此基础上,llama.cpp、Ollama、LM Studio等推理工具让普通用户无需编写代码即可在笔记本上加载模型。相比通过API调用云端模型,本地运行的优势包括:无按次计费、数据不出本机、可离线使用、响应延迟可控;代价则是受限于本地算力,长上下文和复杂推理任务的速度与效果可能不及机房部署的旗舰模型。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。