Qwen3.8-27B登陆Nebius:稠密模型如何服务智能体开发

阿里270亿参数稠密模型Qwen3.8-27B登陆Nebius平台,主打智能体构建与多步骤工作流场景。
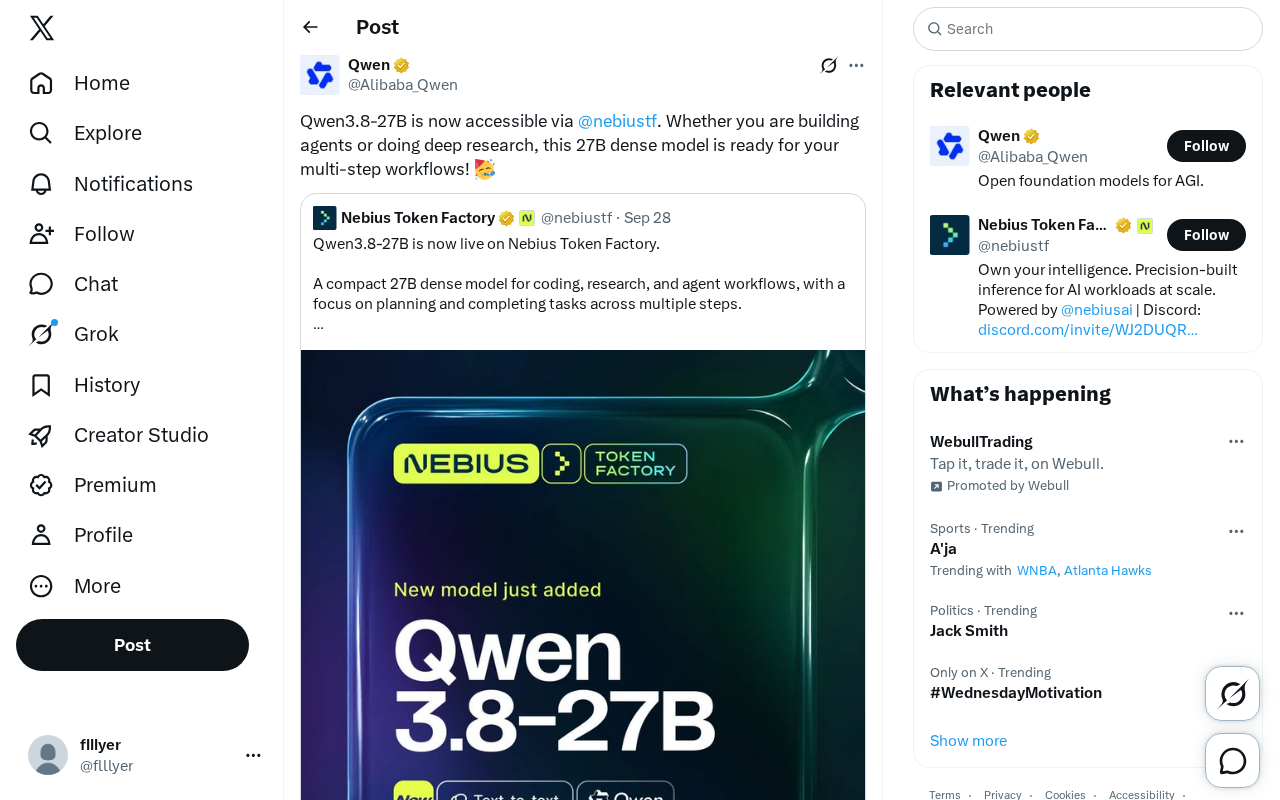
阿里通义千问系列新成员 Qwen3.8-27B 已通过云平台 Nebius 开放 API 访问。这是一款 270 亿参数的稠密(dense)模型,区别于当前主流的 MoE 稀疏架构,其全部参数在推理时均参与计算,提供更可预测的行为和更稳定的微调表现。官方将其定位于智能体构建与深度研究场景,尤其强调对多步骤工作流的支持——这一场景要求模型具备强逻辑一致性和上下文追踪能力,稠密架构的稳定性恰好契合这一需求。27B 的参数规模处于能力与部署成本的平衡区间,通过云平台托管进一步降低了使用门槛。目前官方尚未公布基准测试、上下文窗口及定价等关键参数,实际表现有待验证。
Qwen3.8-27B上线Nebius平台
阿里通义千问广告系列的新成员 Qwen3.8-27B 已经通过 Nebius 平台开放访问。根据官方发布的消息,这是一款 270 亿参数的稠密(dense)模型,被定位为面向智能体(agent)构建和深度研究场景的生产力工具,尤其强调对多步骤工作流的支持。
对于正在评估中大型开源模型的开发者来说,这一动态值得关注。27B 的参数规模处在一个相对微妙的区间——它比 7B、8B 这类轻量模型具备更强的推理与长链路任务能力,又不至于像 70B 以上的巨型模型那样对部署成本提出苛刻要求。这种定位让它成为在能力与成本之间寻求平衡的候选项。
稠密模型意味着什么
近来大量前沿模型转向 MoE(混合专家)架构,通过稀疏激活来降低推理开销。Qwen3.8-27B 选择继续走稠密路线,意味着模型的全部参数在每次推理时都会参与计算。
稠密架构的优势在于行为更可预测、微调更直接、在特定领域适配时通常更容易调教出稳定的表现。对于需要精细控制模型行为的智能体系统而言,这种可预测性往往比峰值性能更重要。代价则是推理时的计算量相对固定,无法像 MoE 那样通过稀疏激活节省算力。
官方将其明确推荐给「构建智能体」和「深度研究」两类用户,这两类场景都高度依赖模型在多轮交互中保持逻辑一致性和上下文追踪能力,稠密模型在这方面的稳定性正是其卖点。
MoE(Mixture of Experts,混合专家)架构的工作原理是将模型拆分为多个"专家"子网络,每次推理时只激活其中少数几个专家处理当前输入,其余参数处于休眠状态。这意味着一个名义上拥有数百亿参数的 MoE 模型,实际每次推理时激活的参数量可能只有总量的 1/4 甚至更少,从而大幅降低计算成本。典型案例包括 Mixtral 8x7B(实际激活约 13B 参数)和 DeepSeek广告-V3(总参数 671B,激活约 37B)。这种架构的代价是训练难度更高、负载均衡更复杂,且在某些精细调优场景下行为稳定性不如稠密模型。理解这一背景,有助于判断 Qwen3.8-27B 坚持稠密路线的技术取舍逻辑。
多步骤工作流的适配价值
发布信息中特别强调了对「multi-step workflows(多步骤工作流)」的就绪支持。这一表述指向当下 AI 应用开发的核心痛点:单次问答已经不能满足复杂需求,真正有价值的应用往往需要模型规划任务、调用工具、评估中间结果并动态调整策略。
在这类链式任务中,模型任何一步的失误都可能被后续步骤放大,最终导致整个流程崩溃。因此模型的推理稳定性、指令遵循度和对上下文的连贯理解,直接决定了智能体应用的可用性。Qwen3.8-27B 面向这一场景的定位,反映出模型厂商正从「更强的单点能力」转向「更可靠的流程执行」这一趋势。
通过Nebius访问的意义
借助 Nebius 这样的云平台提供访问,降低了开发者的使用门槛。用户无需自行准备 GPU 集群或处理复杂的部署运维,即可通过 API 直接调用模型进行原型验证和生产集成。
对于希望快速试水该模型能力的团队来说,这种即开即用的方式能显著缩短从想法到验证的周期。同时,云端托管也让不同规模的团队能够按需付费,无需前期投入大量基础设施成本。
Nebius 是一家源自俄罗斯互联网巨头 Yandex 的云计算公司,2023 年完成独立拆分后专注于 AI 基础设施服务,主要面向欧洲和国际开发者市场。其核心业务是提供 GPU 算力租用和主流开源模型的 API 托管,与 Together AI、Replicate 等平台定位类似,旨在为无力自建算力集群的团队提供生产级模型访问入口。对于 Qwen 系列模型而言,通过 Nebius 上线也意味着在中国大陆以外的国际开发者社区获得了一个正式的云端访问渠道,降低了国际用户在合规和网络访问层面的使用摩擦。
该关注还是观望
需要说明的是,目前公开的信息仍然有限,官方发布仅提供了模型的定位与可用性说明,尚未附带详细的基准测试成绩、上下文窗口长度、定价细节等关键参数。因此关于它在实际任务中相对同级模型的表现,还需要等待更完整的评测数据或亲自动手验证。
对于正在为智能体项目挑选基础模型的开发者,Qwen3.8-27B 提供了又一个值得纳入对比清单的选项。稠密架构 + 中大参数规模 + 多步骤工作流的明确定位,构成了一个清晰的产品画像。是否契合具体需求,最终仍取决于在真实工作流中的实测表现。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。