Qwen3.8-Flash-Next无审查版本地部署教程:8GB显卡跑大模型
基于千问衍生的本地「无审查」大模型Qwen3.8-Flash-Next部署教程,支持262K上下文与多模态,最低8GB显存可运行。
本文基于B站UP主「超哥」的演示,介绍了一款名为Qwen3.8-Flash-Next的本地大模型的部署流程与实测表现。该模型宣称无内容审查、支持262K超长上下文和多模态图片识别,采用Strata推理引擎配合MTP加速,最低约需8GB显存运行最小量化版本。在RTX 4080S(16GB显存)环境下实测推理速度约60 Token/s,能正确识别图片中的铅笔数量、修复贪吃蛇游戏Bug,但在复杂交互页面生成上存在局限。部署流程需手动下载推理引擎、模型文件,配置本地路径,并覆盖RT文件以启用MTP加速。文章同时提醒读者:模型命名与官方版本对应关系、量化精度损失及「无审查」内容风险均需理性评估,且所有数据来自单一演示来源,建议部署前独立求证。
这款模型为何值得关注
一位B站UP主「超哥」近期分享了一个本地部署教程,主角是基于千问系列衍生的 Qwen3.8-Flash-Next(视频中称其为「无审查版」)大模型。该模型最大的卖点有三个:无内容审查、超长上下文窗口(262K tokens),以及对硬件要求相对友好——官方描述最小仅需 8GB 显存即可运行最小量化版本。
据UP主介绍,这个模型上线后迅速积累了数万次下载量,提供了多个量化版本以适配不同显存配置。其核心技术亮点在于采用了 Strata 推理引擎配合 MTP(Multi-Token Prediction,多Token预测)加速,从而在消费级显卡上也能获得较快的推理速度。
需要说明的是,本文内容均来自单一来源(B站UP主演示),模型的实际能力与命名准确性有待更多独立测试验证。
**量化(Quantization)**是大模型本地部署的核心技术之一。原始模型的权重通常以32位或16位浮点数存储,而量化通过将这些权重压缩为更低精度的整数格式(如8位、4位甚至更低)来大幅减小模型体积和显存占用。IQ3_S是一种非均匀3位整数量化方案,相较于标准Q4量化精度损失更大,但换来了更小的体积与更低的显存需求。量化虽不可避免地带来一定精度损失,但现代量化算法(如GGUF格式所用的k-quant系列)已能在多数任务上保持与原始模型接近的表现。262K tokens的超长上下文则意味着模型单次对话可处理约20万汉字的文本,适合长文档分析、代码库问答等场景,代价是KV缓存会随上下文增长占用大量显存与内存。
**MTP(Multi-Token Prediction,多Token预测)**是一种推理加速技术,其核心思路是让模型在单次前向传播中同时预测多个后续Token,而非传统自回归方式每次只生成一个Token。这样可以显著提升推理吞吐量,尤其在消费级GPU上效果明显。MTP通常需要配套的"草稿头"模型文件(即教程中的RT文件)协同工作:主模型负责验证,草稿头负责快速生成候选序列,两者共同完成推测解码(Speculative Decoding)流程。这也解释了为何部署时需要单独下载并覆盖RT文件才能真正激活加速效果——缺少该步骤时模型仍可运行,但速度会明显低于宣传数值。
实测表现:速度与多模态能力
UP主的测试环境为 16GB 显存的 RTX 4080S 显卡、12核CPU、64GB 内存。在这套配置下,他运行了最大的量化模型(约83GB,IQ3_S量化),实测推理速度接近每秒 60 Token,部分场景下达到 63 Token/s。
模型支持多模态图片识别,这是本次测试的一个重点。UP主上传了一张包含铅笔的图片让模型计数,模型给出了「34只铅笔」的答案,并逐层说明了每层的数量,识别结果正确,此时速度为每秒 55 Token。
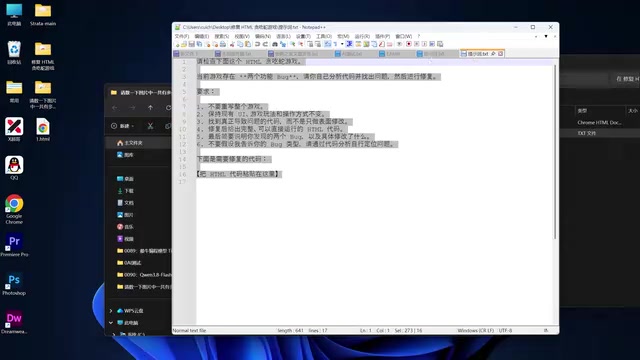
在代码能力测试中,UP主让模型修复一个贪吃蛇HTML游戏的两个Bug——「蛇不会撞墙死亡」和「蛇无法吃到食物」。模型成功修复了这两个问题,替换代码后游戏行为恢复正常。
不过在生成「霓虹骑车」交互页面的测试中,模型生成的HTML页面存在交互失效的问题——调节按钮没有响应。UP主推测这是因为提示词中未明确要求「动态效果」,不同模型对指令的理解存在差异,这个结果反映出模型对复杂交互需求的理解仍有局限。
本地部署完整流程
整个部署过程可以拆解为几个关键步骤,核心是下载推理引擎、模型文件,并正确配置路径。
第一步:下载 Strata 项目与模型
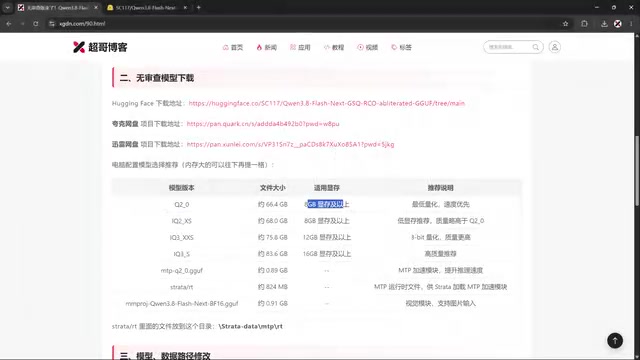
UP主提供了 HuggingFace、夸克网盘和迅雷网盘三种下载渠道,国内用户若遇到 HuggingFace 访问慢可选用网盘。需要下载的文件包括:Strata 推理引擎项目压缩包、主模型文件(分为IQ3_S等多个量化版本)、MTP 加速文件以及多模态识别文件。
关于量化版本的选择,UP主给出了对照表:最小版本约需 6-8GB 显存,而最大的 IQ3_S 版本约83GB,适合显存与内存都较充裕的用户。模型主文件分为两个部分(约26GB + 51GB)。
第二步:创建文件夹并修改路径
由于模型文件体积庞大,UP主建议将模型存放在空间充足的非系统盘(如D盘)。需要创建两个文件夹:一个存放模型文件(models),另一个用于存放模型运行时自动生成的临时文件(约7-8GB)。
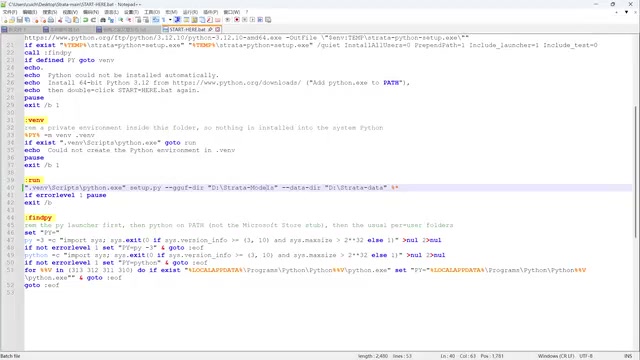
随后需要用文本编辑器打开启动脚本(start_here.bat),在约第40行位置修改配置,增加两段路径指定:一是指定本地模型目录(避免程序自动联网下载),二是指定运行时文件的存放路径。UP主特别强调文件夹命名应与教程保持一致,否则需要自行修改对应配置。
第三步:启动与参数配置
双击启动脚本后,程序会先识别电脑环境,然后进入交互式配置:
- 模型选择:根据下载的量化版本对应填写编号
- 上下文长度:默认选项为3
- KV缓存精度:建议选1(精度更高,开销增加不大)
- 多模态:若下载了多模态文件并需要图片识别,填 y
- 拒答控制:建议填 y 以减少模型拒答
第四步:覆盖RT文件启用MTP加速
首次运行后,程序会生成一个新的 .bat 启动文件。此时还需将下载的四个 RT 文件覆盖到自动生成的 MTP 目录中,才能真正启用 MTP 加速。
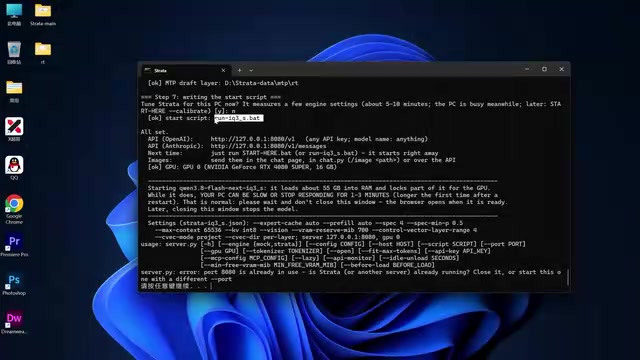
如果遇到端口冲突(UP主的8080端口被占用导致页面打不开),可在生成的启动文件中将端口号改为8085等未占用端口。配置完成后,使用程序生成的 .bat 文件启动,而非原始的 start_here.bat。
使用注意事项
模型运行期间,命令行终端窗口不能关闭——一旦关闭,对话界面和模型都会失效。若不慎关闭或重启电脑,需要重新运行启动文件才能再次使用。
UP主在最终连接测试中观察到初始Token速度约为每秒30,但他认为这可能受录屏影响或是回答内容过短所致,正常情况下速度在60-70 Token/s区间。
客观看待这类「无审查」模型
这类标榜「无审查」的本地部署模型近期在社区中传播较广,吸引力主要在于本地运行、无需API、数据不出本机。但也需要理性看待几点:模型的实际命名与官方版本的对应关系、量化带来的精度损失、以及「无审查」特性可能带来的内容风险。
从技术角度看,MTP加速与量化技术确实在推动大模型向消费级硬件下沉,让更多人能在个人电脑上体验长上下文与多模态能力,这一趋势值得肯定。但本教程来自单一演示来源,具体性能数据和模型来源建议读者在实际部署前进一步求证。
从模型溯源的角度看,「基于千问系列衍生」的表述需要谨慎对待。Qwen(通义千问广告)系列模型由阿里巴巴开源,其原始模型本身包含内容过滤机制。社区衍生的「无审查」版本通常通过继续微调(Fine-tuning)或直接修改模型权重的方式移除这些限制,但此类操作可能同时影响模型在其他维度的对齐能力。此外,模型命名中的「Flash」和「Next」后缀并非官方Qwen版本系列的标准命名,加之视频来自单一UP主演示,建议用户在部署前通过HuggingFace模型页面核实模型卡(Model Card)中的来源说明、训练数据和许可证信息,以评估实际可信度与合规性。
相关推荐
Lovable Pro Plus 管理面板营销分析:免费积分噱头与风险提示
针对 YouTube 上「Lovable Pro Plus 管理面板、无限免费积分、899 卢比终身访问」的营销素材进行拆解,分析其卖点、Lovable 官方积分机制及潜在的账号与资金风险,并给出理性选择 AI 建站工具的建议。

Dify从0到1实战:搭建20+AI应用的完整教程指南
Dify从0到1实战教程:涵盖Docker部署、MySQL配置、聊天助手、Agent智能体、Chatflow与Workflow工作流五大应用类型,以及大模型接入和应用发布,手把手带你搭建20+AI应用。

IrisGo:演示一次即可自动运行的AI工作流助手
IrisGo 是一款面向独立创业者的 AI 工作流自动化工具,凭借 Watch & Learn 功能实现"演示一次即可自动运行",提供每日简报、邮件分拣和待办跟踪,beta 期免费。本文解析其核心功能与适用场景。