Qwen3.8 Flash深度拆解:能力密度惊人但体感并不快

前几天,AI圈仿佛约好了一样密集发布新品:智谱推出了GLM 5.3 Flash,阿里也发布了千问 Qwen3.8 Flash。两家不约而同主打同一件事——极低成本,还能干活。本文就以 Qwen3.8 Flash 为样本做一次拆解,看看它到底值不值得你切换过去。
先说结论:别看它名字里带着「Flash」,真用起来,可能一点都不快。
Qwen3.8 Flash的两个版本:开放权重 vs 云端生产
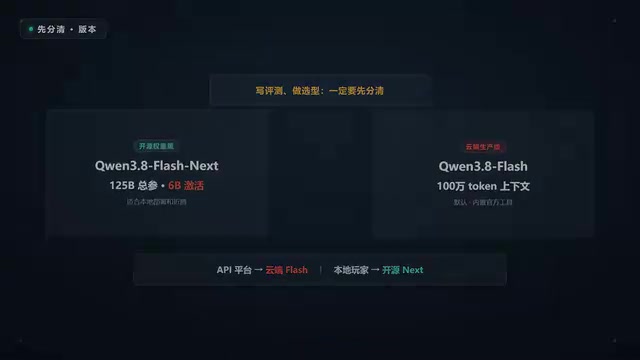
很多评测和选型文章会在这里踩坑:Qwen3.8 Flash 其实是两个不同的产品。
第一个叫 Qwen3.8 Flash Next,是开放权重版本,拥有 125B 总参数,但每个 Token 只激活 6B。它采用的是 MoE(Mixture of Experts,混合专家)架构——近两年大模型领域最重要的架构创新之一。MoE 的核心思想源自1991年 Jacobs 等人提出的混合专家系统,但直到2022年 Google 的 Switch Transformer 和后来的 Mixtral 8x7B 才真正在大语言模型领域大规模落地。其关键设计包含两部分:一是多个结构相同但参数独立的「专家」前馈网络(FFN),二是一个轻量级的门控路由网络(Gating Network),负责根据输入 Token 的语义特征动态选择 Top-K 个专家参与计算。传统的 Dense(稠密)模型在推理时会激活全部参数,而 MoE 模型将参数分散到多个「专家」子网络中,每次推理只由路由机制选择少量专家参与计算。因此它可以拥有 125B 的总参数量(代表模型的知识容量),但每个 Token 只激活 6B 参数(代表实际的计算开销)。
这种设计的深层意义在于:总参数量决定了模型能「记住」多少知识,而激活参数量决定了每次推理的计算成本。Qwen3.8 Flash Next 的 125B 总参 / 6B 激活,意味着激活比例仅约 4.8%,远低于 Mixtral 8x7B 的约 25% 和 DeepSeek广告 V3 的约 10%。这种极低激活比例带来的挑战是路由机制必须更加精准——如果频繁选错专家,模型能力会急剧下降。DeepSeek V3 率先验证了这条路线的可行性,而千问 3.8 Flash 则将激活比例压得更低,进一步挑战「能力密度」的极限。这个版本适合本地部署、折腾和二次开发,本地玩家看到的多半是它。
第二个才是云端生产版 Qwen3.8 Flash,默认提供 100 万 Token 上下文,还内置了官方工具链。100 万 Token 上下文在技术实现上并非简单的数字扩展——标准 Transformer 的自注意力机制复杂度为 O(n²),100 万 Token 意味着注意力矩阵的计算量是 128K 上下文的约 61 倍。为实现这一目标,业界常用的技术包括 RoPE 位置编码的外推(如 YaRN、NTK-Aware Scaling)、稀疏注意力机制(如 Sliding Window Attention 与 Full Attention 的混合)、以及 KV Cache 的量化压缩。但需要注意,「支持」100 万 Token 和「有效利用」100 万 Token 是两回事——多项研究(如 Lost in the Middle)表明,模型在超长上下文中对中间位置信息的检索能力往往显著下降。实际使用时,关键信息的放置位置和检索策略(如 RAG 与长上下文的搭配)仍需仔细设计。普通用户在 API 平台上调用的,通常是这个云端版。
写评测、做选型,一定要先分清这两者,否则很容易把本地版的表现张冠李戴到云端版上,得出错误结论。
跑分表现:赢的不是绝对分数,是能力密度
在综合智能指数 AA 上,几个模型的成绩如下:
- Qwen3.8 Flash Next:56 分
- Qwen3.8 Flash(云端):57 分
- GLM 5.3 Flash:处于同一梯队
- DeepSeek V4 Flash:52 分
这里提到的综合智能指数 AA(Artificial Analysis Intelligence Index),是由独立评测机构 Artificial Analysis 发布的模型综合能力评分体系。它汇总了 MMLU、GPQA、HumanEval、MATH 等多个主流基准测试的结果,按加权方式计算出 0-100 的综合分数,旨在提供跨模型的横向可比指标。由于单一基准容易被针对性优化,这类综合指数能在一定程度上减少「刷榜」带来的失真,但也存在权重设定主观、无法覆盖所有真实场景等局限。
单看绝对分数,千问并不是第一名。但关键要看激活量:它只需要激活 6B 参数,差不多是 GLM 的三分之一。
换句话说,它用更少的计算量,挤进了同一个能力梯队。这里赢的不是绝对分数,而是单位计算能做多少事,也就是「能力密度」。这才是 Flash 系列真正的竞争逻辑。
各家模型擅长的场景差异明显
阿里官方给出的跑分很有指向性:
- SWE-Bench Pro:62.5,领先 Claude Opus 4.6 约 9 分
- Cowork Bench(协作办公):73.9,把 DeepSeek 的 45.1 甩开一大截
- Job Bench(专业任务):55.7,超出 Opus 4.6 约 20 分
其中 SWE-Bench 是由普林斯顿大学团队推出的软件工程基准测试,要求模型在真实的 GitHub 仓库中定位并修复实际的 bug。其原始版本收集了 12 个流行 Python 仓库的 2294 个真实 Issue-PR 对,要求模型在完整代码库中定位问题文件、理解上下文依赖关系并生成正确的补丁。SWE-Bench Pro 是其进阶版本,任务难度更高,通常涉及跨文件修改、复杂依赖推理和边界条件处理,更贴近生产级别的代码修复场景,已成为衡量 AI 编程 Agent 实战能力的核心指标之一。值得注意的是,SWE-Bench 的评测方式是端到端的:模型不仅要生成代码补丁,还需要通过仓库原有的测试套件验证,这意味着它考察的不仅是代码生成能力,更是对工程上下文的理解能力。不过,SWE-Bench 也有局限:它以 Python 仓库为主,对前端、系统编程等领域的覆盖不足;同时,部分任务可能存在训练数据泄露的风险,因为这些开源仓库的代码和 Issue 讨论广泛存在于互联网上。与之并列的 Cowork Bench 和 Job Bench 则分别聚焦协作办公和专业任务场景,三者共同构成了评估 Agent 在不同垂直领域表现的多维坐标系。
从这份表格能看出明显的分工差异:GLM 强在写代码的 Agent,千问强在办公型的半功活 Agent,两者的侧重点完全不同。选型时,先想清楚自己的核心场景是编程还是办公协作。
真实项目实测:一半是海水,一半是火焰
跑分归跑分,真实项目更能说明问题。
有一位日本开发者用开放权重版本,在一个真实的开源仓库上跑完整开发闭环:读 issue、搜代码、改代码、跑构建、提交、起草 PR、再读 review 接着改。两个任务一共触发了 194 次工具调用,错误为 0。其中一个任务约 58 分钟就交付了,而用上一代模型跑到 6 个半小时还没提交。
这里的「工具调用」涉及现代 AI Agent 的核心工作模式。如今的 AI Agent 不再是简单的问答系统,而是能够自主规划任务、调用外部工具(如代码搜索、文件编辑、终端命令、API 请求等),并根据执行结果迭代调整策略的自动化系统。这一工作模式遵循 ReAct(Reasoning + Acting)范式,由 Yao 等人在 2022 年提出:模型先用自然语言思考下一步该做什么(Thought),然后生成一个工具调用指令(Action),接收工具返回结果(Observation),再基于结果继续推理。典型的 Agent 框架如 OpenAI 的 Function Calling、LangChain 的 Agent 模块,以及近期流行的 Claude Code、Cursor 等编程 Agent,都遵循这一循环模式。
ReAct 范式的可靠性高度依赖几个因素:模型的指令遵循能力(能否准确生成符合工具 API 格式的调用参数)、错误恢复能力(工具调用失败后能否调整策略)、以及上下文管理能力(在长对话中保持对任务目标的追踪)。194 次工具调用零错误之所以值得关注,是因为在实际 Agent 系统中,每一次工具调用都可能因参数格式错误、权限问题、超时等原因失败,而单次失败如果处理不当就可能导致整个任务链路中断。工具调用的成功率和编排效率直接决定了 Agent 的实用价值,而这与模型本身的生成速度是两个独立的维度。
不过要注意,这只是两个任务的样本,不能当作普适结论。
反过来看,也有中文用户拿它生成一个网页,质量给到 95 分,却整整等了 19 分 37 秒;生成一张 SVG 也等了 10 分钟,过程中还出现长时间无响应和执行失败。
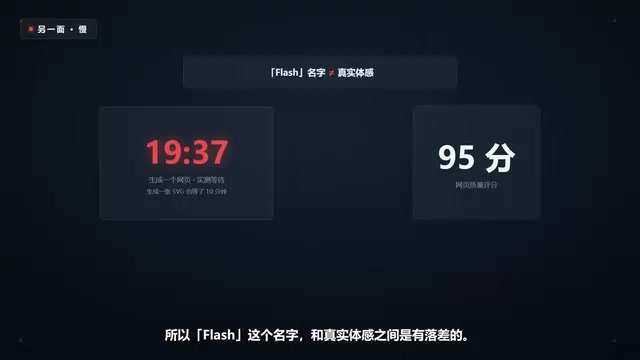
所以,「Flash」这个名字和真实体感之间,是存在明显落差的。这里需要区分三件不同的事:
- 能力:模型能不能完成任务
- 生成速度:单次响应有多快
- Agent 框架调度:多轮工具调用的编排效率
三者互不等价。模型能力强,不代表体感就快。
成本分析:单价便宜但账单未必便宜
成本是落地的关键一环。在 OpenRouter 上的价格对比:
OpenRouter 是一个模型 API 聚合平台,它将多家厂商的模型统一封装为兼容 OpenAI 格式的 API 接口,开发者可以在同一个平台上按需切换不同模型。其定价通常按百万 Token 计费,分为输入(Prompt)和输出(Completion)两个价格。值得注意的是,对于 MoE 模型,云端厂商的定价通常基于激活参数量而非总参数量来核算成本,这也是 MoE 架构在商业层面的核心优势——用户为实际消耗的算力付费,而非为模型的全部容量买单。
| 模型 | 输入(美元/百万Token) | 输出(美元/百万Token) |
|---|---|---|
| 千问 | 0.16 | 0.47 |
| DeepSeek | 0.14 | 0.28 |
| GLM | 促销期更低 | 促销期更低 |
按一个典型的 Agent 任务估算,最贵和最便宜的方案能差到 7 倍。
但这里有个隐藏的坑:实测后会发现,千问的输出量明显高于平台中位数。模型越爱展开、越话痨,最终账单就越可能超出你按单价做的直觉判断。
模型「爱多写」并非偶然,这与训练阶段的数据分布和 RLHF(基于人类反馈的强化学习)策略密切相关。在对齐训练中,如果标注者倾向于给更详尽的回答打高分,模型就会学到「展开写更安全」的策略。在 Agent 场景下,这个问题被放大:每一轮工具调用的思考过程(Chain of Thought)如果过于冗长,不仅增加 Token 消耗,还会占用有限的上下文窗口,导致后续轮次丢失关键信息。
更值得注意的是 Agent 场景下的成本结构特殊性。由于 API 是无状态的,每一轮工具调用都需要将之前的完整对话历史作为输入重新发送,这导致输入 Token 数随对话轮次呈近似线性甚至超线性增长。以前述 194 次工具调用为例,如果平均每轮新增 2000 Token 的上下文,到最后几轮时,单次请求的输入可能已经超过 30 万 Token。此外,不同模型的 Tokenizer 效率不同:同一段中文文本,不同模型的 Token 化结果可能相差 30%-50%,这意味着标称单价相同的两个模型,处理同一任务的实际费用可能差距显著。部分平台还会对思考 Token(Thinking Token)单独计费,使用推理模型时这部分成本也不容忽视。
因此,生产环境使用时,一定要给它清晰的完成条件和输出上限,否则表面便宜的单价可能变成失控的总成本。常用的缓解手段包括设置 max_tokens 上限、在系统提示词中明确要求简洁输出、使用结构化输出格式(如 JSON Schema)来约束响应格式,以及采用上下文压缩、摘要注入或分层 Agent 架构来控制累积 Token 消耗。
选型建议:选模型不是选分数,是选场景
那么,Qwen3.8 Flash 到底香不香?答案不在于它是不是第一名,而在于你拿它来干什么。
它真正的价值,是用三分之一的激活量,把办公型 Agent 做到了第一梯队。这是它最亮眼的竞争力。
但它的短板同样明确:
- 并不快——「Flash」名不副实
- 爱多写——输出冗长,推高成本
- 需要人复合——过程中可能失败或无响应
一句话总结选型逻辑:跑分决定能不能干,账单和等待决定能不能落地。
如果你的核心场景是办公协作类 Agent,且能接受一定的等待时间、并做好输出上限约束,Qwen3.8 Flash 值得一试;如果你追求编程 Agent 的极致体验或极致响应速度,那就要慎重考虑,甚至看看 GLM 或 DeepSeek 是否更契合。
选模型,从来不是选分数,而是选场景。
核心要点
- 先分清两个版本:Qwen3.8 Flash Next(开放权重,125B总参/6B激活,MoE架构)和 Qwen3.8 Flash(云端生产版,100万Token上下文),是两个不同的产品,评测和选型不能混淆。
- 能力密度是核心竞争力:用仅约4.8%的激活比例挤进第一梯队,赢的不是绝对分数,而是单位算力能做多少事。
- 场景分工明确:千问强在办公协作类Agent(Cowork Bench 73.9),GLM强在编程Agent(SWE-Bench),选型前先确认核心场景。
- Flash不等于快:模型能力、生成速度、Agent调度效率是三个独立维度,实测中长任务可能出现十几分钟的等待甚至无响应。
- 单价便宜≠账单便宜:模型输出冗长会推高Token消耗,Agent场景下上下文累积进一步放大成本,生产环境必须设置输出上限和上下文管理策略。
相关推荐

单卡12G跑本地实时语音AI:35B模型+语音对话全流程
国外开发者展示如何在单张12GB显卡上本地运行35B MoE语言模型、Whisper语音识别与Breeze TTS2语音合成,通过流式转录、并行合成与量化优化,将端到端语音对话延迟从8秒降至2-3秒,并接入Agent工具调用场景。

Qwen4架构预览已开源:125B参数、512专家,专为显存受限硬件设计
Qwen4尚未发布但架构已通过Qwen3.8 Flash Next开源预览:125B参数、每Token激活6B、512专家、262K上下文,专为显存受限硬件设计。本文梳理官方确认信息、config.json关键指标及24G内存本地部署实测。

6G显存跑8K图!复旦开源MOSS-Image生图模型实测
复旦OpenMouse团队与上海摩斯智能开源MOSS-Image生图模型,5亿参数DT架构,6G显存即可本地跑图,文字渲染精准、支持结构化布局控制与4K Tokens长提示词,适合电商海报与个人创作者本地部署。