Qwen3+RAGFlow零成本搭建本地知识库全流程教程
用Ollama+Qwen3+RAGFlow在本地搭建私有RAG知识库智能助手的完整实操指南
本文系统介绍了如何利用 Ollama、Qwen3 与 RAGFlow 在本地搭建一套私有知识库智能助手。文章首先对比了微调与 RAG 两条技术路线,指出 RAG 凭借低成本、可实时更新和答案可溯源的优势,更适合垂直领域知识库场景。随后从环境准备(Docker + WSL)、RAGFlow 部署、模型集成(本地 Ollama 与线上硅基流动 API)到 Embedding 原理,逐步拆解完整流程,并重点标注了 Docker 容器内访问宿主机须用 `host.docker.internal` 这一高频踩坑点。最终通过"员工管理制度"示例,演示了知识库检索、答案生成与原文出处标注的完整效果,帮助读者理解 RAG 如何从根本上消除大模型幻觉。
在通用大模型遍地开花的时代,为什么还要自己动手搭建本地知识库?答案很简单:企业和个人的私有资料,在线模型无法直接访问。即便通过附件上传,也难以做到本地化的持久保全。更关键的是,当模型遇到不知道的问题时,往往会"胡编乱造",产生所谓的幻觉。本文基于一份B站实操教程,完整梳理如何用 Ollama、Qwen3 与 RAGFlow 搭建一套稳定、可控、有据可依的本地智能助手。
为什么选择RAG而不是微调
解决大模型幻觉问题,主流有两条路径:微调和 RAG(检索增强生成)。
微调是在特定领域数据上对模型做二次训练。以电商客服为例,需要下载 Qwen、DeepSeek广告 或 Llama 等开源模型,再准备大量标注好的问答样本进行训练。这条路的问题在于成本高昂——数据收集、清洗和训练环节都需要投入大量资源。
RAG 的思路则完全不同,相当于给模型配了一本随时可查的参考书,让它按书作答。它的优势非常直接:回答贴近原文、支持实时更新、无需重新训练,还能标注答案参照了原文的哪一章节,做到有据可依。综合部署成本、学习成本和硬件成本来看,RAG 在垂直领域的知识库和智能助手场景中,是一套直观且高效的方案。
整个 RAG 流程可以拆成三个核心步骤:知识库构建、向量化、检索与生成。
RAG 流程在技术层面分为两个阶段:离线索引阶段和在线检索阶段。离线阶段负责将原始文档切片、向量化并存入向量数据库;在线阶段则在用户提问时,将问题同样向量化,与数据库中的文档向量做相似度计算,取出最相关的若干片段,连同原始问题一起拼入提示词(Prompt),交给大模型生成最终回答。正是因为答案来源于真实文档片段而非模型参数的"记忆",RAG 能够大幅降低幻觉概率,并天然具备引用溯源能力。
环境准备:Docker与WSL的坑
搭建的第一步是安装 Docker。前往 docker.com 官网,根据自己的操作系统选择对应版本——Mac 分苹果 M 芯片和英特尔芯片两个版本,Windows 则有 AMD 架构和 ARM 架构之分。
Windows 用户在安装 Docker 时最常遇到的问题就是安装失败,根本原因通常是没有启用系统虚拟机。解决办法是:点击 Windows 搜索键,搜索"启用或关闭 Windows 功能",在列表中勾选适用于 Linux 的 Windows 子系统和虚拟机平台这两项,系统会自动完成组件更新。
如果更新仍然报错,可以进入系统"设置→Windows 更新→高级选项→恢复",使用"Windows 更新修复问题"功能,它能修复被占用的更新进程和组件问题。基本上通过这两步能解决绝大多数安装故障。
Docker 安装完成后,还需确认 WSL 是否配置。打开 CMD 输入 wsl --version 查看版本信息;若未安装,运行 wsl --install 即可。
获取RAGFlow源码并启动服务
环境就绪后,前往 GitHub 获取 RAGFlow 源码。有技术基础的可以用 git 拉取,否则直接点击 Download 下载压缩包。将源码解压到本地磁盘后,进入生成的文件夹,重点关注 docker 文件夹。
这里有一个关键配置文件 .env,用于环境配置。需要留意其中的端口设置——默认是 80 端口,对应访问地址就是 localhost。如果与本机其他软件(如 Dify)发生冲突,可以改成 8888 等其他端口,保存即可。
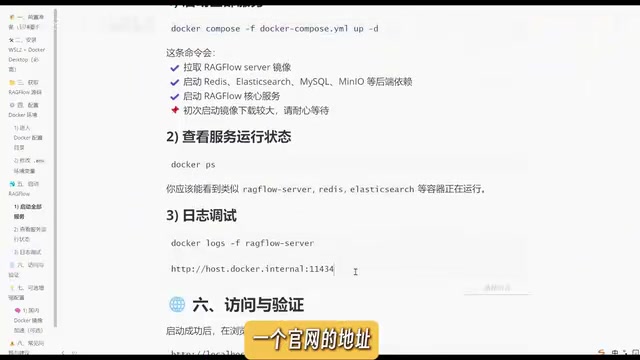
配置完成后,在 docker 文件夹下右键"在终端打开",运行启动命令。RAGFlow 不是单一服务,它还依赖 redis、es、minio 等组件,这些都会一并拉取。第一次启动大约需要 10 到 20 分钟,视电脑配置而定。
启动后可以在 Docker 桌面客户端的"容器"(注意不是"镜像")标签中,看到 RAGFlow、minio、redis、es 等容器已经运行。也可以用命令查看当前运行的所有容器及其端口号,确认服务正常。
集成模型:Ollama本地模型与线上API
浏览器输入 localhost 进入登录界面,用账号密码登录后即可看到知识库、聊天、搜索、智能体、文件管理等模块。第一件要做的事是集成模型提供商。
通过Ollama部署本地模型
本地集成需先下载 Ollama,前往 ollama.com 下载安装包一路下一步即可。Ollama 官网提供 DeepSeek、Qwen、Llama 等多种模型。以 Qwen3 为例,通过命令行 ollama run 加上对应参数版本下载即可。显卡不大的用户可选 0.6B 或 1.7B 做 demo,显卡够用则可上 8B、14B。
嵌入模型(如 BGE)的下载同理。
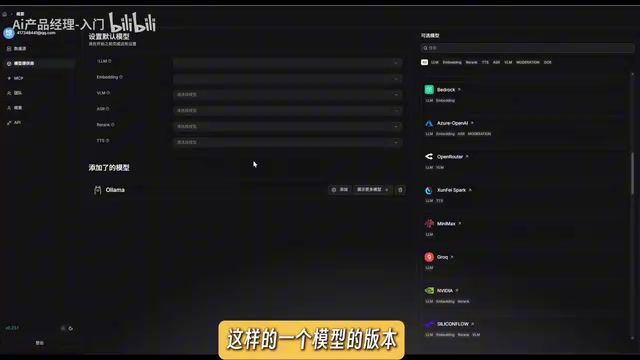
回到 RAGFlow 添加 Ollama,模型分为 embedding、chat、re-rank(重排序)、图片转文本等类型。集成聊天模型时,通过 ollama list 复制模型名称粘贴过来。
这里是最容易踩坑的地方:URL 地址配置。由于 RAGFlow 运行在 Docker 容器内,不能直接访问宿主机,很多教程让你填 ipconfig 里的 IPv4 地址,这样是行不通的。正确做法是使用 host.docker.internal 这样的连接路径,后面串上端口号 11434,最大 token 数设置为 8888 或 8080,点击确定即可。
Ollama 是一个专为本地运行大语言模型设计的开源工具,它将模型下载、运行时管理和 API 服务封装成一条简单的命令行界面。安装后 Ollama 会在本机启动一个 REST API 服务,默认监听 11434 端口,外部程序(如 RAGFlow)可以通过 HTTP 请求调用本地模型,接口规范与 OpenAI API 兼容,因此大多数支持 OpenAI 的工具都可以无缝接入。Ollama 还支持自动检测 NVIDIA/AMD 显卡并启用 GPU 加速;如果没有独立显卡,也可以纯 CPU 运行,只是速度较慢。模型文件默认存储在用户目录下的 .ollama 文件夹,体积较大,建议提前确认磁盘空间充足。
集成线上API
如果本地显卡不够强,想用更聪明的模型,也可以集成线上 API,比如硅基流动。注册其官网(完全免费,每天有一定调用额度),在"API 密钥"页面复制 key,粘贴回 RAGFlow 保存,即可调用线上模型。
硅基流动(SiliconFlow)是国内的大模型推理云平台,提供对 DeepSeek、Qwen、GLM 等主流开源模型的 API 调用服务,接口格式与 OpenAI 兼容。平台对新注册用户提供每日免费额度,适合个人项目验证效果。需要注意的是,使用线上 API 意味着你的查询文本和知识库片段会经由平台服务器处理,对于含有商业机密或个人隐私的场景需谨慎评估合规风险。如果只是用于嵌入模型(Embedding),数据传输量相对较小;若聊天模型也走线上,则每次对话的上下文和检索到的文档块都会发送至第三方,这一点在选型时值得特别关注。
理解Embedding:文本如何变成向量
创建知识库时,需要选择嵌入模型(本地 BGE 或线上硅基流动),并选择切块方法——RAGFlow 内置了论文、表格、书籍、问答等多种类型。
那么 embedding 到底在做什么?本质是把文本转成数字表示。自然语言传递的信息复杂而多维,比如"苹果"这个词包含水分含量、糖分含量等多个维度。以二维直角坐标为例,X 轴表示水分、Y 轴表示甜度,从原点到某个坐标点的连线就构成了向量。
真实的嵌入模型维度远不止两维,主流有 512 维、768 维等。向量有一个重要特征:语义相近的词,坐标也相近。比如"猫"和"狗"的向量会靠得很近,因为它们都具备宠物、对人类友好等相似维度;而"房子"作为非生命体,坐标会离动物很远。嵌入的意义就在于捕捉词语的语义含义。
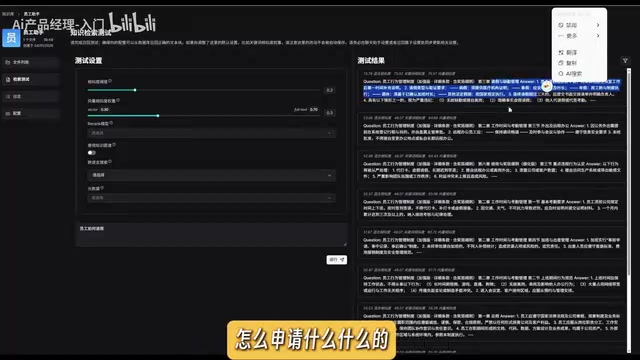
上传文档后需点击"启动"做解析,即完成切片、embedding、入库。解析完成后会出现绿点标记,此时可用检索测试验证效果。例如提问"员工如何请假",若返回的文档块与请假、缺勤管理相关,说明文档嵌入合理、检索可用。
向量数据库(Vector Database)是 RAG 架构中专门用于存储和检索向量的基础设施。与传统关系型数据库的精确匹配不同,向量数据库采用近似最近邻搜索(ANN)算法,能够在海量高维向量中快速找出与查询向量距离最近的若干条记录,对应到 RAG 场景就是"语义最相关的文档片段"。常见的相似度度量方式包括余弦相似度和欧氏距离。RAGFlow 内部默认使用 Elasticsearch 作为向量存储后端,这也是启动时会一并拉起 es 容器的原因。理解这一点有助于你在遇到检索结果不准确时,判断问题出在切块策略、嵌入模型选择,还是相似度阈值配置上。
创建聊天应用:让回答有据可依
回到首页创建聊天应用,比如"员工管理智能助手"。在配置中可设置系统提示词(如"你是一个员工智能助手,总结知识库的内容"),选择刚才做好嵌入的知识库,再往下选择对话模型——可以是本地 Qwen3 1.7B,也可以是线上 DeepSeek R1。配置完成务必点击保存。
提问"员工如何请假",模型会先检索知识库,每个命中的文档块都有对应 ID 标记,随后依据这些内容生成回答。最终答案严格参照上传的员工管理制度文档,并自动标注原文出处,做到真实可靠、有据可查,从根本上消除幻觉问题。
生成智能助手后,可以在右上角创建 token,将其嵌入到自己的网站中使用。
本地模型 vs 线上API如何选择
两种模型方案各有取舍:
- 线上 API(如硅基流动):优势是可调用更复杂、更聪明的大模型,对本地显卡要求低;劣势是数据会经过第三方服务器,通常收费(免费额度每天有限)。
- 本地部署:数据绝对隐私,不会流传到外网;缺点是需要自行配置较好的显卡。
对数据安全性、隐私性有要求的公司或业务场景,通常选择本地部署;个人做项目练手,线上 API 更方便快捷。
流程总结
完整回顾整套流程:通过 Ollama 部署本地模型(注意 IP 地址用 host.docker.internal),通过 Docker 部署 RAGFlow(默认监听 80 端口,localhost 访问首页);接着走三步——创建知识库、上传解析做向量化嵌入、集成聊天大模型生成智能助手。
整个 RAG 生成流程可以概括为:文档切片 → embedding 模型嵌入到向量数据库 → 用户问题嵌入后做相似度检索 → 返回相关文档块 → 大模型归纳整理生成回答。理解了 RAG 与微调的区别、embedding 的向量化原理,以及本地容器部署方法,你就能搭建出一套属于自己的私有智能知识库。
相关推荐
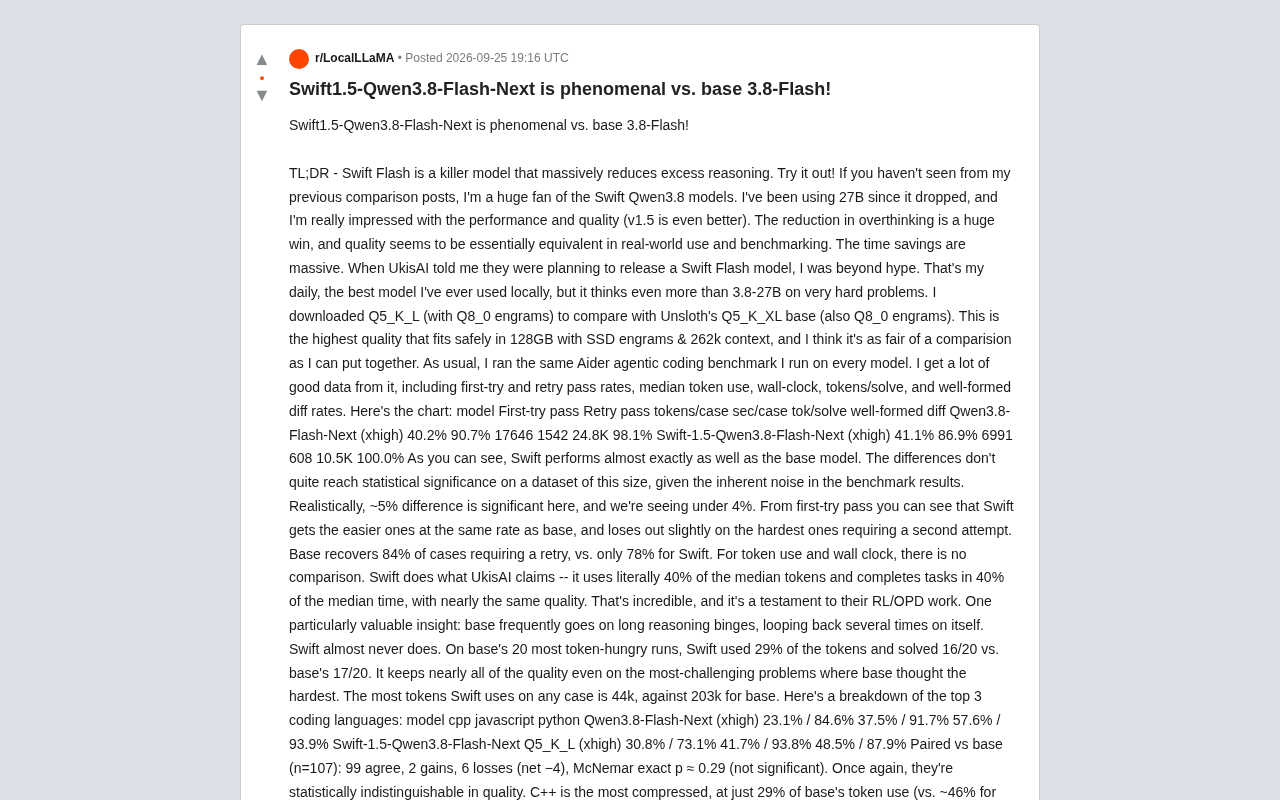
Swift1.5-Qwen3.8-Flash-Next实测:推理提速60%,质量几乎无损
Swift-1.5-Qwen3.8-Flash-Next实测对比基础版Qwen3.8-Flash:Aider编程基准显示其推理token和耗时降至40%,质量几乎无损,C++场景需留意。本地大模型效率优化实录。
中学生涌入NPR评论区:一场Z世代的网络迁徙
NPR工作人员一度把Spotify播客评论区的古怪留言当成机器人,直到一位Z世代同事识破真相——原来是中学生把这里当成了新的线上聚集地。本文解读青少年网络迁徙背后的代际认知差异与平台治理挑战。
《Factorio》登陆触屏平台:一场工厂建造游戏的交互重构
自动化工厂建造游戏《Factorio》正尝试移植到触屏平台。本文解析开发日志 FFF-447 中揭示的触屏交互重构挑战,以及复杂桌面软件迁移触摸范式的通用启示。