Qwen4-Max发布:2.4万亿参数,为何仍落后Opus 16分?

Qwen4-Max以2.4万亿参数和低价入局,但基准测试仅赢4项,旗舰转向封闭。
阿里巴巴发布迄今最大模型Qwen4-Max,采用2.4万亿参数的混合专家架构,每token激活710亿参数,原生支持视觉与百万级上下文。然而官方基准显示,16项评测中仅赢4项,独立指数得分43,落后Opus 16分。其API定价极具侵略性,输出价格不到Opus四分之一,实际任务成本约为三分之一。同时,旗舰模型权重封闭,仅通过API托管提供,不支持自托管、微调和批量推理,与Qwen系列过往开源策略不同。文章认为,参数规模不再是唯一标尺,性能、价格与开放的平衡才是竞争关键,选择取决于任务分布与成本敏感度。
阿里巴巴迄今最大的模型Qwen4-Max已正式上线。2.4万亿参数的混合专家架构,每token激活710亿参数,原生支持视觉,上下文窗口达到百万级。然而,官方基准图表显示,它在16项评测中仅赢下4项,独立指数得分43,落后Opus整整16分。这场“参数规模”与“实际表现”的错位,揭示了当前大模型竞争的一个核心矛盾:堆参数不再是赢的保证,价格与开放性的权衡才是。
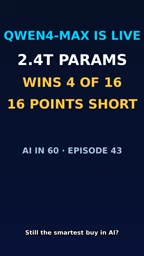
参数规模登顶,但赢面不足三成
Qwen4-Max的规格表足够震撼:2.4万亿总参数、710亿激活参数、原生多模态、百万token上下文。在阿里巴巴自己的测试中,它确实拿下了部分关键场景——DeepSWE得分75.7,小幅领先Opus;法律专项测试得分21,接近对手的两倍。但问题在于,16项基准中它只赢了4项。据YouTube频道Labcoat AI的统计,Opus在其余7项中领先(该频道称其“数学”核算如此)。独立评测机构Artificial Analysis给出的综合指数为43,与Opus的差距达到16分。
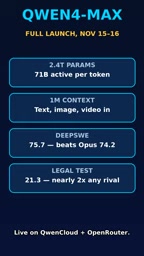
这种“参数最大、赢面最小”的组合并不常见。它说明Qwen4-Max的设计目标可能并非全面超越,而是在特定场景(如代码、法律)上做到极致,同时用价格换市场。
混合专家架构(Mixture of Experts, MoE)是一种稀疏激活的模型设计:模型包含多个“专家”子网络,但每个token只路由到其中少数几个专家进行计算。Qwen4-Max的2.4万亿总参数正是分布在大量专家中,而每token仅激活710亿参数,这意味着推理时实际计算量远小于总参数规模。MoE的优势在于能以较低的计算成本扩展模型容量,但挑战在于路由算法的效率和专家负载均衡。与稠密模型(每个token都经过全部参数)相比,MoE在相同计算预算下通常能获得更好的性能,但也更依赖训练数据的多样性和路由策略的设计。
上下文窗口指模型单次能处理的最大token数量(包括输入和输出)。百万级上下文意味着模型可以一次性读入约75万英文单词或150万汉字,足以处理长篇文档、大型代码库或多轮长对话。然而,长上下文能力不仅取决于窗口大小,还受限于模型在长序列上的注意力效果和位置编码设计。实际应用中,过长的上下文可能导致推理成本上升和关键信息被稀释,因此如何高效利用长窗口仍是工程挑战。
价格屠夫:成本不到Opus的四分之一
Qwen4-Max的定价极具侵略性:输入每百万token 1.50美元,输出4.50美元。对比Opus的4.20美元(输出侧),Qwen4-Max的输出价格不到前者的四分之一。如果按完成一个任务的实际成本计算,Artificial Analysis给出的数字是3.27美元对10.04美元,差距超过三倍。阿里巴巴自身的数据也显示,其每任务成本下降了62%。
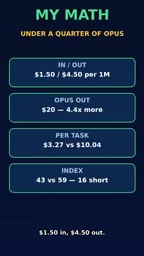
对于高频调用API的开发者来说,这个价差足以抵消部分性能劣势。尤其当任务集中在Qwen4-Max的优势领域(如代码生成中的DeepSWE场景)时,性价比优势会被进一步放大。
封闭的旗舰:开放策略的转向
最值得玩味的变化来自开放性。Qwen系列此前以开源权重著称,但Qwen4-Max的权重是封闭的,仅通过阿里云广告API和OpenRouter托管提供,不提供下载或自托管。官方承诺后续会开放较小的Qwen4模型,但旗舰版本保持锁定。此外,思考过程加最终答案的总长度被限制在262,000 token,且不支持微调和批量推理。
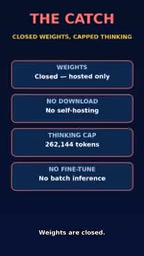
这一转向意味着阿里巴巴在旗舰模型上选择了“价格换开放”的路线。对开发者而言,便利性提升(无需部署、按需调用),但灵活性和数据主权下降。对阿里而言,这是在商业化和生态控制之间的一次明确取舍。
开源权重(open-weight)指模型训练完成后的参数文件可公开下载,开发者能自行部署、微调甚至商用(需遵循许可证)。与之相对,封闭权重仅通过API提供推理服务,用户无法接触模型内部。开源权重有利于生态建设、透明度和数据主权,但难以控制滥用和商业化;封闭权重则便于厂商统一管理、保障服务质量和持续迭代。Qwen系列此前多个版本采用开源权重,而Qwen4-Max转向封闭,反映了旗舰模型在商业利益与生态开放之间的权衡。
微调(fine-tuning)指在预训练模型基础上,用特定领域数据继续训练以适配下游任务。批量推理(batch inference)则允许将多个请求打包处理,以提高吞吐量并降低单位成本。Qwen4-Max不支持这两项功能,意味着开发者无法针对私有数据定制模型,也难以通过批量处理进一步优化成本。对于需要高度定制化或大规模离线推理的企业,这构成了实际限制,可能促使部分用户转向支持微调的开源模型或其它API服务。
该选便宜的还是更强的?
Labcoat AI在视频结尾抛出的问题值得每个技术决策者思考:你会选择便宜但输掉一半基准的模型,还是支付四倍以上价格换取Opus?答案取决于任务分布。如果工作负载集中在Qwen4-Max赢下的4项基准所覆盖的场景,且成本敏感,它可能是当前最划算的选择。如果任务需要全面均衡的能力,或者对封闭权重有顾虑,Opus仍然领先。
参数规模不再是唯一标尺。Qwen4-Max用2.4万亿参数换来了局部优势和价格优势,却没能换来全面领先。这或许正是大模型竞争进入下半场的信号:谁能在性能、价格与开放之间找到最佳平衡点,谁才能赢得开发者的长期信任。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。