R2S:修复评分器近视,智能体蒸馏性能提升12.8%

R2S通过修复教师逐词评分器的近视问题,在无奖励下提升智能体蒸馏成功率12.8%。
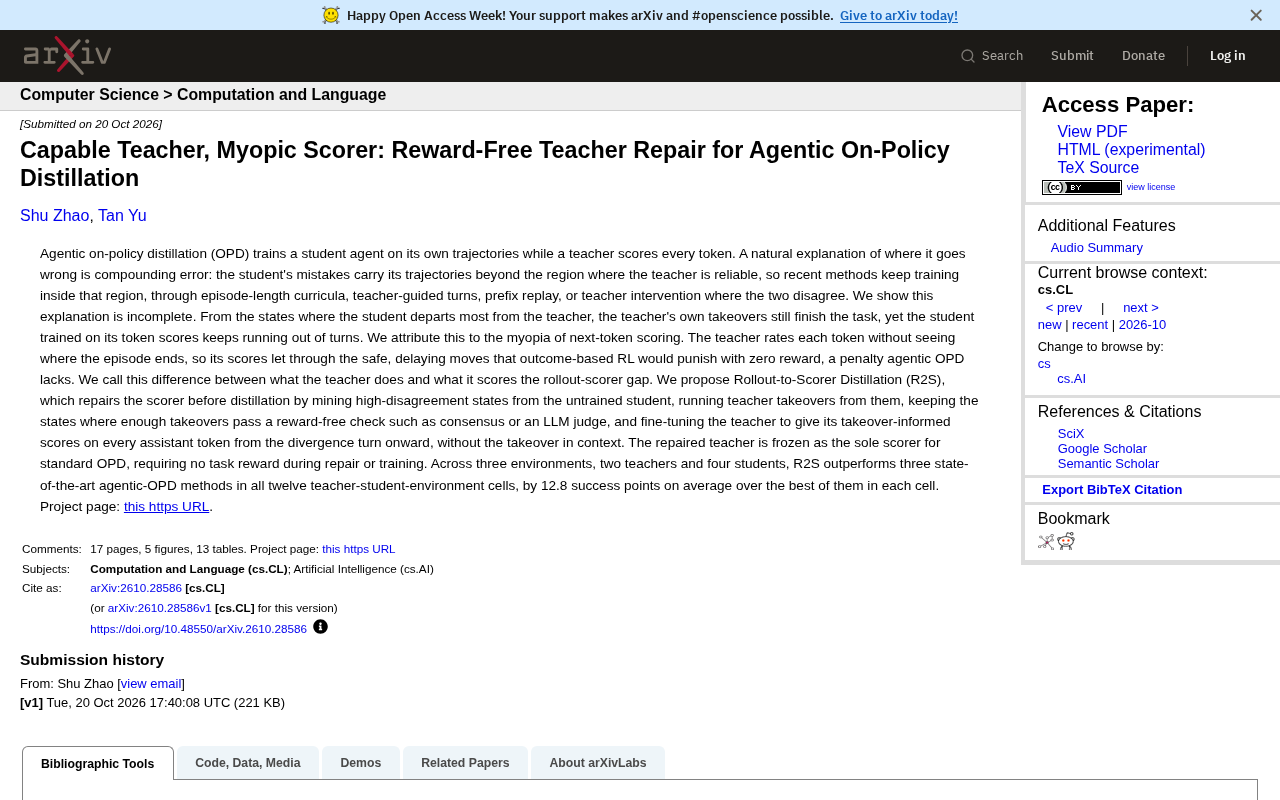
本文解读《Capable Teacher, Myopic Scorer: Reward-Free Teacher Repair for Agentic On-Policy Distillation》,指出在线策略蒸馏(OPD)中教师逐词评分存在近视性:教师为每个token打分时不知回合何时结束,导致安全但拖延的动作获得高分,与学生实际接管行为产生rollout-scorer gap,而非传统认为的复合误差。作者提出R2S方法,先从未训练学生与教师分歧最大的状态出发,运行教师接管并用无奖励检查筛选高质量片段,再微调教师评分器使其评分与接管行为对齐,最后冻结修复后的教师用于标准OPD。在三个环境、两种教师和四种学生的12个测试单元中,R2S全部取得最优,平均成功率比最佳基线高12.8个百分点,且全程无需环境奖励,保持了OPD的奖励免费优势。
在智能体(Agent)训练中,在线策略蒸馏(OPD)因其无需环境奖励即可利用教师模型指导而备受关注。然而,学生模型常因教师逐词评分的“近视”问题而无法完成长程任务。本文解读最新研究《Capable Teacher, Myopic Scorer: Reward-Free Teacher Repair for Agentic On-Policy Distillation》,该工作提出R2S方法,通过修复评分器而非仅调整蒸馏过程,在多个环境中平均提升12.8%的成功率,为智能体蒸馏提供了新思路。
教师评分器的近视问题
传统观点将OPD的失败归因于复合误差:学生偏离教师可靠区域后,错误累积导致任务失败。但研究者发现,即使从学生偏离最大的状态出发,教师自己的接管(takeover)仍能完成任务,而学生基于教师逐词评分训练后却常常耗尽回合。这指向一个更深层的原因——下一词评分(next-token scoring)的近视性。
教师为每个token打分时并不知晓回合将在何处结束,因此那些安全但拖延的举动(如原地等待)可能获得高分,而基于结果的强化学习会因其最终失败给予零奖励。这种“教师实际行为”与“教师评分”之间的差异,被作者定义为rollout-scorer gap。
在线策略蒸馏(On-Policy Distillation, OPD) 是一种知识蒸馏范式:学生模型在自己的策略分布上生成轨迹,教师模型对这些轨迹中的每个 token 给出评分(通常为对数概率或某种打分),学生据此优化。与离线蒸馏不同,OPD 的训练数据来自学生当前策略,因此能缓解分布偏移;与基于环境奖励的强化学习不同,OPD 不需要任务成功/失败的奖励信号,只依赖教师的逐词监督。然而,教师逐词评分本质上是局部的:每个 token 的评分只考虑当前上下文,无法感知该动作对最终任务结果的长程影响,这正是文章所述“近视性”的根源。
复合误差(compounding error) 源自模仿学习理论:学生每步都有小概率偏离教师策略,一旦偏离,后续输入就落入教师训练分布之外,导致错误逐步累积、轨迹崩溃。传统 OPD 分析常把失败归因于此,并试图通过课程学习、前缀回放或教师干预来扩大学生覆盖范围。但本文指出,即使教师从学生偏离最大的状态接管仍能成功,说明问题不在学生“不会走”,而在于教师逐词评分无法区分“安全但拖延”与“有效推进”——这是评分信号本身的长程盲区,而非单纯的分布偏移。
R2S:先修复评分器,再蒸馏
针对上述问题,作者提出Rollout-to-Scorer Distillation(R2S)。其核心是在标准OPD之前,先对教师评分器进行修复,使其评分与接管行为对齐。具体流程分三步:
1. 挖掘高分歧状态
从未训练的学生模型出发,收集其与教师分歧最大的状态。这些状态是学生最容易出错、也最需要正确指导的区域。
2. 教师接管与无奖励筛选
从这些状态运行教师接管,记录完整轨迹。然后,仅保留那些通过无奖励检查(如多个接管结果共识或LLM评判)的接管片段,确保用于修复的数据质量。这一过程无需任何任务奖励信号。
教师接管(teacher takeover) 指在某个中间状态(通常为学生偏离较大的状态)处,由教师模型继续执行后续动作直至回合结束。接管轨迹反映了教师在长程任务中的实际行为策略,可作为“正确行为”的参考。R2S 的关键洞察是:教师接管本身能完成任务,但教师逐词评分与接管行为不一致;因此用接管轨迹来校准评分器,而非直接让学生模仿接管轨迹。
无奖励筛选 是保证接管数据质量的关键步骤。由于没有环境奖励,R2S 采用共识机制(多次采样接管,保留结果一致的片段)或 LLM 评判(由大模型判断接管是否合理)来过滤低质量轨迹。这避免了用失败或次优接管去微调评分器,同时保持了 OPD 的奖励免费特性——整个过程不依赖任何任务成功信号,只利用教师自身的生成能力和外部评判,因此可推广到奖励难以定义的长程交互任务。
3. 微调教师评分器
利用筛选后的接管数据,微调教师模型,使其在从分歧回合开始的每个助手token上,都能给出基于接管信息的评分,且评分时上下文中不包含接管本身。修复后的教师被冻结,作为标准OPD的唯一评分器。
实验效果:全面超越基线
研究在三个环境、两种教师模型和四种学生模型组合的12个测试单元中,将R2S与三种先进的智能体OPD方法进行对比。结果显示,R2S在所有12个单元中均取得最优性能,平均成功率比每个单元的最佳基线高出12.8个百分点。
这一提升验证了修复评分器的有效性:通过消除rollout-scorer gap,教师评分更能反映长期任务结果,从而引导学生避免短视行为。
意义与展望
R2S的提出揭示了智能体蒸馏中一个被忽视的关键问题——评分器的近视性。与以往通过课程学习、前缀回放或教师干预来缓解复合误差的方法不同,R2S直接修正评分信号本身,且全程无需环境奖励,保持了OPD的奖励免费优势。
未来,该方法或可扩展至更复杂的多轮交互任务,并与基于结果的强化学习结合,进一步提升智能体的长程规划能力。对于从事智能体训练的研究者和工程师而言,R2S提供了一种低成本、高效益的改进路径。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。