RAGFlow本地部署与RAG实战全指南

基于B站教程梳理RAGFlow从Linux虚拟机+Docker部署到知识库、Agent、Ollama接入及API集成的完整路径。
本文基于B站系列课程大纲,系统梳理了RAGFlow的部署与功能脉络。教程建议用VMware搭建Linux虚拟机再安装Docker部署RAGFlow,以避开Windows Docker Desktop的常见问题。主界面核心功能分为知识库、聊天、搜索和Agent四块,文件管理服务于知识库的文档解析与索引。Agent模块采用工作流编排,当前支持节点数量有限,适合线性检索生成流程。通过Ollama可将本地模型接入RAGFlow,实现完全离线的RAG链路。网页嵌入与API调用部分覆盖HTTP API和Python SDK,便于将RAGFlow作为后端服务集成。最后指出RAGFlow对MCP的实现与传统理解存在差异,集成前需确认协议边界。整体上,该课程覆盖了一条完整的落地路径,适合作为系统性入门材料。
RAGFlow 是近期开源社区中关注度较高的 RAG 引擎,围绕它的教程不少,但真正从零把环境搭起来、跑通知识库与大模型对话的完整路径并不常见。这套来自 B 站的系列课程给出了一个相对系统的路线:从 Linux 虚拟机起步,用 Docker 部署 RAGFlow,再逐步展开知识库、Agent 工作流、Ollama 本地模型接入、网页嵌入与 API 调用。本文基于该教程的课程大纲,梳理 RAGFlow 的部署要点与功能脉络,并补充一些实际落地时容易踩坑的判断。
为什么选择 Linux + Docker 部署 RAGFlow
教程明确避开了 Windows 上的 Docker Desktop,理由是这类安装方式"会有莫名其妙各种各样的问题"。这个判断在实际操作中不算夸张——RAGFlow 依赖多个容器协同(包括向量数据库、文档解析服务等),Windows 下的路径映射、WSL 网络转发和资源分配都可能成为故障点。
作者的选择是用 VMware 搭建 CentOS 或同类 Linux 虚拟机,再在其中安装 Docker 并部署 RAGFlow。对于不熟悉 Linux 的读者,课程把虚拟机的网络配置、常用工具操作也纳入了讲解范围,这部分看似基础,却是后续所有步骤能否顺利进行的前提。
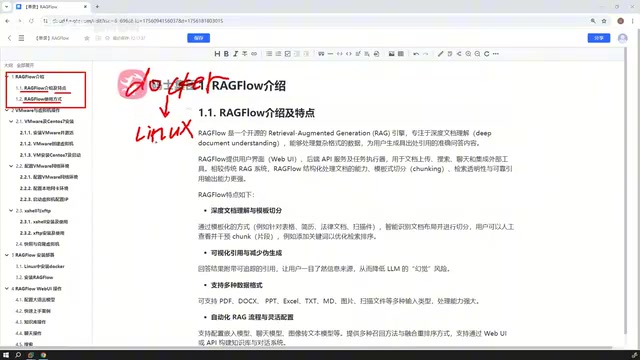
需要提醒的是,RAGFlow 对内存和磁盘有一定要求,尤其是文档解析环节。在虚拟机里分配资源时留出余量,比事后排查容器反复重启要省事得多。
RAGFlow 的容器化架构:RAGFlow 并非单一服务,而是由多个容器组成的系统,典型组件包括 Web 前端、API 后端、文档解析引擎(如 DeepDoc)、向量数据库(Elasticsearch 或 Infinity)、MySQL 元数据库以及 Redis 缓存等。这些容器通过 Docker 网络互相通信,并共享挂载卷存储上传的文件与解析结果。理解这一点有助于排查故障:例如文档解析失败可能是解析容器内存不足,检索不到结果可能是向量数据库未正常启动。因此,部署时需确保 Docker Compose 能正确拉取所有镜像,并为各容器分配足够资源。官方提供的 docker-compose.yml 已定义了服务依赖关系,但虚拟机环境下仍需关注端口冲突与卷权限问题。
RAGFlow 主界面的四大功能模块
部署完成后进入主页面,教程把核心功能归纳为四块:知识库、聊天、搜索和 Agent。此外还有一个文件管理入口,其作用会在知识库操作环节中体现——上传的文档需要在这里被解析、切分并索引,才能被后续的检索链路调用。
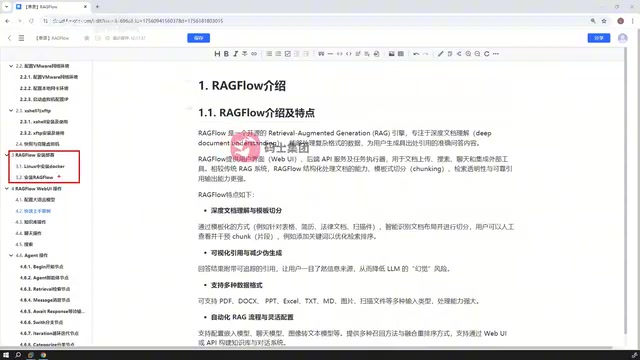
这个划分其实反映了 RAG 应用的基本链路:知识库负责数据摄入与向量化,聊天负责对话交互,搜索提供纯检索能力用于验证召回效果,Agent 则把上述能力编排成可复用的流程。理解这四者的关系,比逐个界面点一遍更有价值——很多人在知识库效果不佳时直接去调对话 prompt,但问题往往出在文档切分或解析阶段。
Agent 工作流:节点虽少,但够用
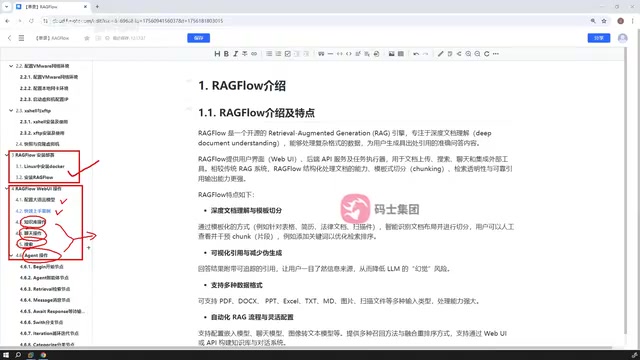
RAGFlow 的 Agent 模块采用工作流式编排,形态上接近 Dify 或 Coze 中的可视化流程。教程中提到一个务实的观察:当前 RAGFlow 支持的节点数量相对有限。这不是缺点也不是优点,而是需要按实际业务判断的事实——如果你的流程需要大量条件分支和外部工具集成,可能需要评估节点覆盖面是否够用;如果只是做"检索—生成—输出"的线性编排,现有节点基本能覆盖。
课程对每个节点都配备了对应案例,这种逐个击破的方式对理解节点间的输入输出约定很有帮助。工作流调试中最耗时的往往不是连线,而是搞清每个节点期望的数据结构。
RAGFlow Agent 的节点类型与数据流:RAGFlow 的 Agent 工作流由若干预定义节点构成,常见类型包括开始节点、知识库检索节点、LLM 生成节点、条件分支节点、代码执行节点和结束节点。每个节点有明确的输入输出契约:例如检索节点输出的是文档片段列表,LLM 节点需要接收提示词模板和上下文变量。节点间通过变量引用传递数据,这种设计让流程编排可视化,但也要求开发者清楚每个节点期望的数据结构。与 Dify 等平台相比,RAGFlow 的节点数量较少,缺少循环、子流程等高级控制结构,因此更适合实现“检索-增强-生成”的线性或简单分支流程。若业务需要复杂逻辑,可结合代码节点自行实现。
接入 Ollama:让本地模型进入 RAG 链路
RAGFlow 支持对接 Ollama 推理框架,把下载到本机的模型用于知识库问答。这一部分对数据敏感或希望控制成本的团队比较实用:嵌入模型和生成模型都可以走本地,避免调用外部 API。
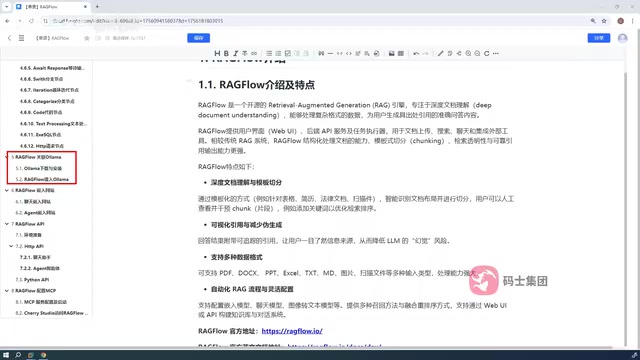
实际配置时需要注意模型分工——Ollama 中拉取的模型需要分别指定用于对话生成和向量化,两者不是同一个模型。教程演示了如何把本地模型应用到 RAGFlow 中,这条路径跑通后,整个 RAG 链路可以完全离线运行。
Ollama 的模型分工与配置要点:Ollama 是一个本地大模型运行框架,支持一键拉取和运行多种开源模型。在 RAGFlow 中接入 Ollama 时,需要区分两类模型:嵌入模型(如 bge-m3、nomic-embed-text)用于将文档和查询转换为向量,对话模型(如 qwen2、llama3)用于生成回答。两者需在 RAGFlow 的模型提供商设置中分别添加,并指定 Ollama 服务的 API 地址(通常为 http://宿主机IP:11434)。注意虚拟机部署时,RAGFlow 容器内访问宿主机的 Ollama 需使用宿主机局域网 IP 而非 localhost,且需确保 Ollama 监听 0.0.0.0。此外,嵌入模型的向量维度必须与知识库创建时选择的维度一致,否则检索会失败。
从应用到集成:网页嵌入与 API
RAGFlow 开发好的聊天应用或 Agent 可以被嵌入到网站中,课程把这一步单独列为一部分,说明其在实际交付中的分量。对于想把问答能力挂到自己产品页面上的开发者,这是从"能跑"到"能用"的关键一步。
API 部分覆盖两条路径:HTTP API 和 Python SDK,并配有示例代码。这两者的选择取决于调用场景——前端或跨语言服务走 HTTP,Python 后端直接用 SDK 更省事。这部分内容对于把 RAGFlow 当作后端服务而非独立产品的团队来说,价值高于界面操作。
MCP 支持:与通常理解有所不同
教程最后一部分介绍 RAGFlow 对 MCP 的支持,并特别指出其实现方式"和传统理解起来的 MCP 功能有点不一样"。这个提示值得留意:MCP 作为模型上下文协议,不同项目的落地形态存在差异,直接套用其他平台的认知容易产生误解。作者表示会在对应章节展开细讲,读者在实践时也应先确认协议的具体边界,再设计集成方案。
MCP(模型上下文协议)简介:MCP 是由 Anthropic 提出的开放协议,旨在标准化大模型与外部工具、数据源的连接方式。传统理解中,MCP 采用客户端-服务器架构,模型通过 MCP 客户端调用 MCP 服务器暴露的工具或资源。然而,不同项目对 MCP 的落地形态存在差异:有的将 RAGFlow 作为 MCP 服务器对外提供检索能力,有的则让 RAGFlow 作为客户端调用外部 MCP 工具。RAGFlow 的实现可能侧重于某一方向,或对协议进行了扩展。因此,在集成前应查阅官方文档,确认 RAGFlow 在当前版本中扮演的角色、支持的传输方式(如 stdio、HTTP)以及可用的工具列表,避免因认知偏差导致集成失败。
整体评价
这套课程的价值在于覆盖了一条完整的落地路径:环境准备、部署、功能使用、模型接入、对外集成。八个板块的划分逻辑清晰,适合作为 RAGFlow 的系统性入门材料。需要说明的是,本文基于课程大纲整理,具体操作细节以原视频演示为准;RAGFlow 迭代较快,界面与节点支持情况可能随版本变化,部署前建议对照官方文档确认当前版本要求。
相关推荐
64麦克风声学相机实测:800美元看见声音
实测Amazon售价800美元的TD2E声学成像相机:64个麦克风阵列实时定位声源,频响覆盖2000至100000赫兹,可探测超声波。本文分析其工作原理、实际定位精度、工业巡检适用场景及接口缺失等细节问题。
制造加速器Re:Build融资21亿美元,分拆Slate Auto
制造加速器Re:Build完成21亿美元融资,自称“美国对深圳的回应”,并分拆出Slate Auto。本文梳理已知事实、定位含义与信息缺口。
OpenAI公开突破却遭学界诟病:科研透明度成焦点
OpenAI公布数学、计算机科学和物理学突破并声称改进沟通方式,但研究人员向The Verge表示不满加剧,批评其选择性公开、缺乏可复现细节,企业研究与开放科学之间的张力再度凸显。