RAG混合搜索:为什么向量检索漏掉TS-999及简单修复

纯向量检索会漏掉TS-999等精确token,用BM25+向量+RRF融合可修复。
文章指出 RAG 应用在回答“如何修复错误 TS-999”时失败,根源不是大模型而是纯向量检索:embedding 把文本压缩成一个点,稀有精确 token(错误码、SKU、函数名)在压缩中被模糊,TS-999 与 TS-998 在向量空间几乎相同。解决方案是混合搜索:同时运行 BM25 关键词检索与向量语义检索,再用 Reciprocal Rank Fusion(k=60)按排名融合,避免比较不同量纲的原始分数。文章给出基于 rank_bm25 的最小 Python 实现,并引用 Anthropic 数据:embedding+BM25 再配合上下文可使 top-20 检索失败率降低 49%,加入重排序器后降低 67%。落地路线强调用 30–50 条真实查询建立 recall@10 基线并把评估集纳入仓库。
RAG混合搜索:为什么向量检索漏掉TS-999及简单修复
用户输入“如何修复错误 TS-999?”,你的 RAG 应用跑了一次向量搜索,却拉回五段关于“通用错误代码”的内容。模型据此写出一段自信但没用的回答——真正写着“TS-999”的那篇文档根本没进提示词。
这不是模型的问题,而是检索的问题。解决它不需要换大模型,也不需要调参,而是一个朴素可靠的方案:混合搜索(Hybrid Search)。
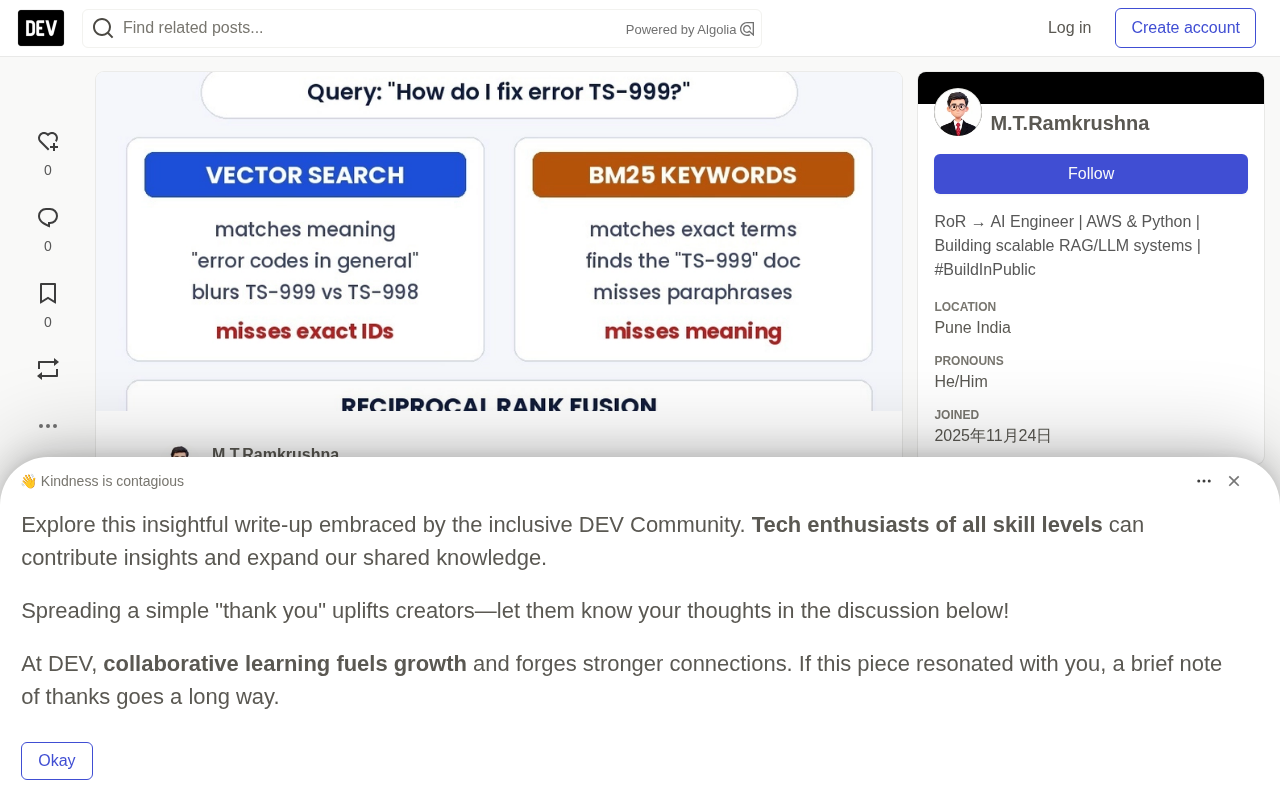
纯向量搜索为何会漏掉精确匹配
Embedding 擅长表达语义。“重置密码”和“我登不进去”在向量空间里靠得很近,这正是我们想要的效果。但 embedding 本质上是把文本压缩成一个点,稀有而精确的 token 会在压缩过程中被模糊掉。
以下几类内容最容易在纯向量检索中丢失:
- 错误码和工单 ID(
TS-999、INC-4821) - SKU、零件号、发票号
- 函数名和配置项(
max_retries、PG_POOL_SIZE) - 人名、产品名和内部工具名
对 embedding 模型来说,TS-999 和 TS-998 看起来几乎一样;但对用户来说,这是两个完全不同的问题。Anthropic 在 Contextual Retrieval 的官方文章里就用了这个例子:embedding 模型“可能找到关于错误码的通用内容,却错过精确的‘TS-999’匹配”。而关键词搜索能瞬间命中。
BM25 的核心机制
BM25(Best Matching 25)是 Okapi 系统中提出的概率检索函数,至今仍是 Lucene/Elasticsearch 的默认相似度算法。它对每个查询词项计算三个因子:词频(TF)、逆文档频率(IDF)和文档长度归一化。IDF 让 TS-999 这类在全库中只出现几次的稀有词获得极高权重,而 的、the 这类高频词权重趋近于零。TF 部分采用饱和函数,避免一个词重复 100 次就线性放大 100 倍分数;文档长度归一化则防止长文档仅因词多而占优。正是 IDF 与精确分词匹配的结合,使 BM25 能在毫秒级内锁定包含 TS-999 字面量的 chunk——这恰恰是 embedding 压缩后丢失的信息。
修复思路:双路检索后再融合排序
混合搜索的做法是每次查询同时跑两个检索器:
- BM25(关键词搜索):按精确词项匹配打分,稀有词权重更高。它是经典的搜索引擎排序函数,对 ID 和术语非常敏感。
- 向量搜索(语义):按语义相似度打分,擅长处理改写、同义词和模糊提问。
然后把两个排序列表合并。最简单且效果好的融合方法是 Reciprocal Rank Fusion(RRF):
score(chunk) = Σ 1 / (k + rank_in_list)
一个 chunk 在几个列表中出现,就把每个列表的分数加起来。k 是常数,通常取 60,来自 Cormack、Clarke 和 Büttcher 在 SIGIR 2009 发表的 RRF 原始论文。Elasticsearch 在其 RRF 文档中也使用同样的默认值作为 rank_constant。
RRF 的好处在于它只看排名,不看原始分数。你不需要纠结 BM25 的 14.2 分和余弦相似度的 0.81 之间如何比较。
RRF 为何对分数尺度免疫
BM25 输出的是无上界的实数(可能 0 到 30 以上),余弦相似度固定在 -1 到 1,两者无法直接加权求和。RRF 绕开了这个问题:它只取每个列表中的名次 rank,用 1/(k+rank) 折算成分数。一个 chunk 即便在 BM25 中排第 1、在向量检索中排第 40,也能凭两路名次之和获得靠前位次。常数 k=60 的作用是平滑——它压低第 1 名与第 2 名之间的差距,让“在多路中都出现”比“单路第一”更重要。这也意味着 RRF 不要求两路检索返回相同数量的结果,工程上非常容易落地。
一个最小可用的 Python 实现
下面的代码用 rank_bm25 做关键词搜索,向量搜索部分复用你现有的实现:
from rank_bm25 import BM25Okapi

chunks = load_chunks()                      # list[str]
bm25 = BM25Okapi([c.lower().split() for c in chunks])

def keyword_search(query: str, n: int = 50) -> list[int]:
    scores = bm25.get_scores(query.lower().split())
    return sorted(range(len(chunks)), key=lambda i: scores[i], reverse=True)[:n]

def vector_search(query: str, n: int = 50) -> list[int]:
    ...  # 你现有的 embedding 检索,按排名返回 chunk 索引

def rrf(*ranked_lists: list[int], k: int = 60) -> list[int]:
    fused: dict[int, float] = {}
    for ranked in ranked_lists:
        for rank, idx in enumerate(ranked, start=1):
            fused[idx] = fused.get(idx, 0.0) + 1.0 / (k + rank)
    return sorted(fused, key=fused.get, reverse=True)

def hybrid_search(query: str, top_k: int = 10) -> list[str]:
    ids = rrf(keyword_search(query), vector_search(query))
    return [chunks[i] for i in ids[:top_k]]
生产环境通常不需要手写 BM25。Postgres 全文搜索、Elasticsearch/OpenSearch,以及 Weaviate 这类向量数据库都内置了混合搜索能力,底层逻辑一致。
效果有多大?
Anthropic 在代码库、小说和论文三类语料上的实验显示:embedding 结合 BM25 优于单独使用 embedding;如果再给 chunk 添加上下文并配合 BM25,top-20 检索失败率降低了 49%(从 5.7% 降到 2.9%)。在此基础上再加一个重排序器(reranker),失败率降幅达到 67%(从 5.7% 降到 1.9%)。数据来源为 Anthropic 的《Introducing Contextual Retrieval》。
你的具体数字会不同,这也是为什么下一步的评估环节不可省略。
上下文检索(Contextual Retrieval)与重排序器
Anthropic 的 Contextual Retrieval 指在索引每个 chunk 之前,先用大模型为其生成一段说明该 chunk 在整篇文档中位置的上下文前缀,再连同 chunk 一起做 embedding 和 BM25 索引。这解决了 chunk 被切分后丢失指代对象的问题(例如一段只写“该参数默认为 60”的文字,补上“RRF 的 k 值”后才可检索)。重排序器(reranker)则是第二阶段模型,通常基于 cross-encoder,把查询和候选 chunk 拼在一起逐对打分,精度高于双塔 embedding,但计算量大,所以只对召回的前 50–150 条重排。两者叠加解释了 Anthropic 数据中 49% 与 67% 的失败率降幅差异。
落地路线图
- 从日志中收集 30–50 条真实查询,确保其中包含 ID、代码或精确名称。
- 为每条查询标注正确的 chunk。
- 测量纯向量搜索的 recall@10,作为基线。
- 加入 BM25 + RRF 后重新测量,重点关注含 ID 的查询。
- 可选地加入重排序器(先召回约 50–150 条,重排后保留 top 10–20)。
- 把评估集留在代码仓库里,防止下一次“小小的检索调整”悄悄把效果改回去。
什么情况下可以跳过
混合搜索并非万能。如果你的查询全是模糊的自然语言问题,不含 ID 或术语,纯向量检索可能够用。或者你的知识库小到可以直接塞进提示词(Anthropic 建议 20 万 token 以下可以先尝试直接放入)。
除此之外,只要用户可能输入代码、名称或数字,就应该把关键词搜索加回来。
要点回顾
- 向量搜索擅长语义,不擅长精确 token。
- BM25 擅长精确 token,不擅长语义。
- 两者都跑,用 RRF(k=60)融合,并在真实查询上测量召回率。
你的检索栈目前是纯向量还是混合方案?欢迎在评论区分享实际效果。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。