RAG评估指标全解析:检索、生成与运营三大维度

RAG评估指标分为检索、生成、运营三类,应以MRR和nDCG为核心,按场景取舍。
文章将RAG系统的评估指标系统地分为检索、生成和运营三大类。检索指标(Hit rate、Recall@k、Precision@k、MRR、nDCG@k)基于黄金数据集衡量召回质量,其中MRR最值得优先关注,因为LLM更注意靠前段落;nDCG@k则同时衡量完整性与排序质量,是检索基准的标准指标。生成指标(忠实度、答案相关性、正确性等)需借助LLM评判,但存在评判者偏差,且无法区分是LLM忽略上下文还是根本没收到。运营指标关注索引成本、每千次查询成本、延迟和向量存储。文章还介绍了命中率曲线、排名分布、分数差距等诊断指标,并以Truvec工具为例说明检索与运营层的指标覆盖。核心建议是按配置选择指标:单块答案看MRR,跨块答案看Recall和nDCG,检索稳定后再引入生成指标。
RAG系统的评估常常让人陷入指标海洋:各类库暴露数十个指标,仪表盘上它们用同样大小的字体并排显示,看起来每个都重要。但实际工作中,真正起决定作用的只有少数几个。理解每个指标回答的是什么问题,比追踪所有指标更有价值。
RAG指标可以分为三类:检索指标判断系统是否召回了正确的文本块;生成指标判断LLM是否善用了这些内容;运营指标判断你是否养得起这套系统。
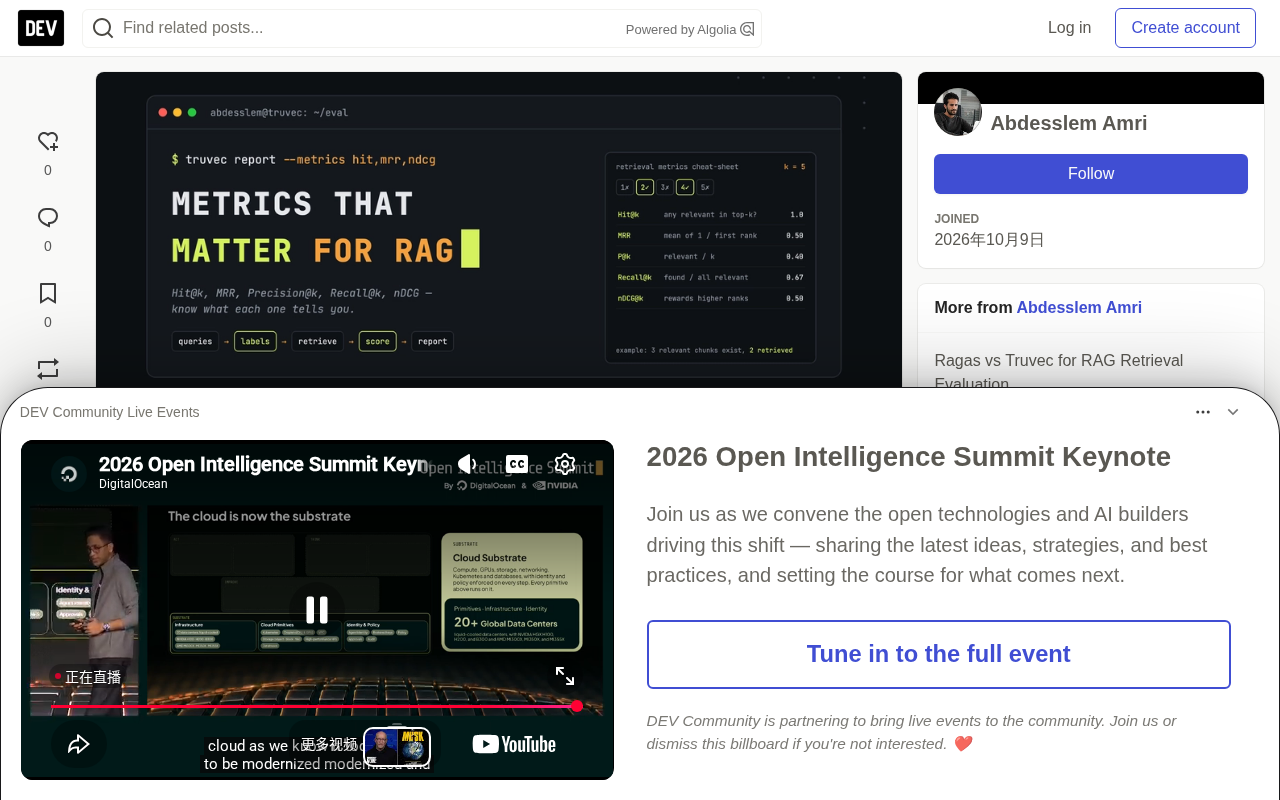
检索指标:找对了吗?
检索指标将检索器返回的文本块与已知包含答案的"黄金数据集"进行对比。所有计算都基于每个问题的Top-K结果,再对所有问题取平均。
假设黄金数据集标注了某个问题的期望文本块,检索器被配置为返回Top-5结果。基于这个具体例子,我们可以逐一计算各指标。
Hit rate@k:有没有找到有用的内容?
只要Top-K中至少有一个期望文本块,该指标记为1,否则为0。对所有问题取平均后,它表示LLM至少拿到了部分所需信息的题目比例。
在示例中,#14出现在Top-5内,所以 hit rate = 1。
这是最容易解释的指标,但它忽略了排序和完整性——找到了一个和找到了全部,在这个指标下没有区别。
Recall@k:找到了多少答案相关内容?
已召回的期望文本块数除以期望文本块总数。
示例中2个期望块只找到1个,recall@5 = 0.5。
当答案分散在多个文本块中时,Recall@k尤为关键。漏掉部分文本块意味着LLM只有一半事实可用,不完整的回答就是这样产生的。
Precision@k:召回的里面有多少是有用的?
已召回的期望文本块数除以k。
示例中 precision@5 = 1/5 = 0.2。
这个指标需要谨慎解读。当只有一个期望文本块而k=5时,precision的理论上限只有20%。它适合比较两套配置的优劣,不适合作为绝对评分。在上下文成本高昂、或者无关文本块明显干扰LLM时,它才更值得关注。
MRR:第一个正确文本块排在第几位?
平均倒数排名:第一个期望文本块排名的倒数,未找到则为0。
示例中第一个期望块排在rank 2,MRR = 1/2 = 0.5。
这是最值得优先关注的指标。LLM对靠前的段落给予更多注意力,许多系统只使用Top-1到Top-3的文本块。两个模型hit rate相同,但一个把答案放在第一位、另一个放在第五位,它们并不等价。
nDCG@k:整个排序质量如何?
归一化折损累计增益为每个被找到的期望文本块给分,排名越低折扣越大(对数折扣),再除以完美排序的得分。取值范围为0到1。
示例中,2个期望块中1个排在rank 2。假设二元相关性,DCG = 1/log₂(3) ≈ 0.63;理想排序将两个块放在rank 1和rank 2,ideal DCG = 1 + 0.63 = 1.63,因此 nDCG@5 ≈ 0.39。
nDCG@k试图用一个数字同时回答"是否找全了所需文本块"和"排序是否靠前"两个问题。它是检索基准测试的标准指标(MTEB的检索任务报告nDCG@10),当答案经常跨多个文本块时,这是一个很好的单一报告数字。
**折损累计增益(DCG)**的核心思想是:一个相关文本块出现在越靠前的位置,它对整体检索质量的贡献越大。计算时,每个相关文本块按排名位置被赋予一个折损因子(通常为 1/log₂(rank+1)),排名越靠后折损越严重,然后将所有相关块的折损后得分累加。**理想 DCG(ideal DCG)**则是假设所有相关文本块都被完美地排在最前面的位置时能得到的最高分。nDCG 就是 DCG 除以 ideal DCG,从而把分数归一化到 0 到 1 之间,使得不同问题、不同相关块数量下的结果可以横向比较。nDCG 还支持分级相关性——即不只是“相关/不相关”的二元判断,而是可以给每个文本块打 0、1、2、3 等不同级别的相关性分数(例如“完全回答”“部分相关”“仅提及”),这在问答类任务中尤其有用。正因如此,MTEB 等主流检索基准普遍将 nDCG@10 作为首选的报告指标。
诊断性检索指标:为什么是这个分数?
除了核心指标,还有三种模式可以帮助理解检索性能的成因。
按截断点的命中率(hit rate@1, @2 ... @k)形成一条曲线。如果曲线起点低但持续攀升,说明模型找到了正确区域但没有把最佳文本块排在前面——加大Top-K或加一个重排序器通常能改善。
首个相关文本块的排名分布可以把"接近命中"(Top-5场景下排在第4、5位)和"完全失败"区分开来。
分数差距是最佳期望文本块的相似度减去最佳错误文本块(最高干扰项)的相似度。正差距大意味着排序稳定;差距接近零意味着正确块和相似块几乎打平,轻微改写就能翻转结果。近重复文档和模板化严重的文本块是常见原因。
生成指标:答案写得好不好?
检索稳固之后,进入答案本身的评估。这些指标通常用LLM作为评判者,借助Ragas等库来计算:
- **忠实度(Faithfulness/Groundedness):**答案中的论断是否被检索到的上下文所支持?
- **答案相关性:**答案是否回应了所提的问题?
- **答案正确性:**答案是否与参考答案一致?
- **上下文精确率与上下文召回率(LLM评判版):**用评判模型判断相关性,而非依赖已知的文本块ID。
评判模型自身也有误差和偏见,更换评判模型或提示词都会导致分数漂移。而且低忠实度分数并不能告诉你,是LLM忽略了好的上下文,还是压根没收到——基于已知文本块ID的检索指标才能回答这个问题。
**LLM-as-a-judge(以LLM作为评判者)**是当前评估生成质量的主流范式。其典型流程是:给定问题、检索到的上下文和模型生成的答案,用一个能力较强的LLM(如GPT-4级别)依据预设的评分标准(rubric)逐条判断忠实度、相关性或正确性,输出分数或判定理由。这种方式的好处是无需人工标注、可扩展性强,能处理开放式答案的语义层面评估;Ragas等框架正是基于此实现了忠实度、答案相关性等指标。但它的局限也很明显:评判模型本身的偏差(如倾向于给较长答案打高分、对某些措辞风格有偏好)会系统性影响分数;不同评判模型或不同提示词版本之间分数不可直接比较;而且当评判标准模糊时,同一份答案在不同运行中可能得到不同结论。因此工程实践中建议固定评判模型与提示词版本,并在关键场景辅以少量人工校准。
运营指标:跑得起吗?
质量只是决策的一半。每套检索配置还需要衡量运营层面的成本:
- **索引成本:**全量语料嵌入一次的费用,以及每次重建索引或更换模型时的重复费用。
- **每千次查询成本:**按实际流量嵌入用户问题的费用。
- **查询延迟:**问题转向量加上向量搜索的耗时(p50和p95)。
- **向量存储:**文本块数 × 维度数 × 4字节(float32向量)。3072维模型需要的存储是1536维的两倍。
嵌入通常只占RAG系统成本的一小部分(相比LLM调用),但在大规模场景下不可忽视:大语料、频繁重建索引和高查询量都会放大它的影响。
向量存储的容量估算是规划阶段最容易被低估的环节。向量以 float32 存储时每个维度占 4 字节,因此一个 1536 维的文本块向量占用 1536 × 4 ≈ 6KB,一百万个文本块就需要约 6GB 纯向量存储;若使用 3072 维模型,同样数量则需约 12GB。这还只是原始向量,实际部署中往往还需额外存储元数据、原始文本以及向量索引结构(如 HNSW 图或 IVF 倒排列表),索引结构本身可能再增加 30%–50% 甚至更多的空间开销。维度选择因此是一个成本与效果的权衡:更高维度可能带来更好的语义区分度,但存储和搜索成本成比例上升,而且搜索延迟会随维度增加而增长。在确定嵌入模型前,用预期的语料规模做一次存储和延迟测算,往往能避免上线后被迫返工。
工具实践:Truvec的指标覆盖
Truvec聚焦于检索和运营层。它在你自己的文档上,使用你审核并锁定的黄金数据集来评测嵌入模型和分块策略,因此分数是确定性的、可跨时间比较的。它不评估生成的答案。
每次评测和对比中的每个模型,Truvec报告以下内容:
**质量指标(按你的Top-K,1到50,默认5):**Hit rate、Recall@k、Precision@k、MRR、nDCG@k、F1@k。
**诊断信息:**按截断点的命中率曲线、首个相关文本块排名分布(含未命中)、分数差距、平均相关分数和最高干扰项分数。
**成本、速度和存储:**索引成本和每千次查询成本(基于实际计费的token和模型百万token单价)、当前运行计费、查询嵌入延迟、向量搜索p50/p95、向量存储和维度。
**逐题分析:**Retrieval Inspector按排名展示每道题召回的文本块,标注为Ground truth或Distractor并附相似度分数,同时显示"期望但未召回"的文本块。可按Misses筛选查看每个模型漏掉了什么。在对比模式下,模型按MRR排序、再按recall排序,PDF报告还包含头对头分析和每个问题在每个模型下首个相关文本块排名的矩阵。
该关注哪些指标?
选择指标取决于你的具体配置。如果答案通常落在单个文本块中,优先看MRR和Hit rate;如果答案跨多个文本块,Recall@k和nDCG@k更关键。Precision@k在上下文窗口紧张或干扰明显时才有意义。生成指标在检索稳定后再引入,避免把检索问题误判为LLM问题。运营指标则根据语料规模和查询量灵活取舍。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。