RAG知识库系统实战:从零搭建企业级私有知识库全流程
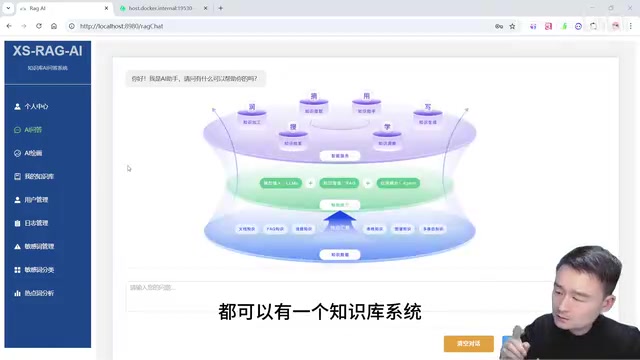
面向Java开发者的企业级RAG知识库实战教程,覆盖从向量化存储到召回率优化的完整工程链路。
本文介绍了一套面向Java开发者的企业级RAG知识库系统教程。传统数据库和ES无法处理语义化自然语言查询,RAG(检索增强生成)通过将文档向量化存入Milvus向量数据库,结合大模型的理解与生成能力,实现以对话方式检索企业内部资料。项目采用Vue 3 + Spring AI + Milvus技术栈,资料经OSS存储后完成分词与向量化处理。教程的核心价值在于深入拆解企业落地中的真实难点:文档分块策略、跨片段检索、召回率提升、AI幻觉抑制、来源追溯以及文档访问权限控制,而非停留在能跑的Demo层面。此外,项目还配套了文生图、用户管理、敏感词管理等辅助功能,并为Java开发者给出了从大模型选型到高可用部署的完整AI应用学习路径,可直接转化为简历竞争力。
为什么企业都需要一个RAG知识库系统
几乎每一家公司都积累着大量独有的业务资料,但如何让全公司的人高效检索这些内容,一直是个难题。传统的关系型数据库和ES搜索引擎在处理语义化问答时力不从心——它们擅长精确匹配关键词,却无法理解"某个同学在哪个班级"这类自然语言问题背后的真实意图。
基于RAG(检索增强生成,Retrieval-Augmented Generation)的知识库系统正好填补了这一空白。它把企业文档向量化后存入向量数据库,再结合大模型的理解与生成能力,让用户以对话方式精准获取内部信息。据B站UP主徐书老师的教程演示,上传一份学生花名册后,就能直接通过问答查询某位同学所在的班级,AI能够准确作答。
这类系统的另一个价值在于职业竞争力。对Java开发者而言,把一个完整的RAG知识库项目写进简历,相比纯粹的传统CRUD经验,无疑是一个更有辨识度的亮点。
RAG(检索增强生成)的工作原理可以拆分为两个阶段:检索阶段将用户的自然语言问题也转换为向量,在向量数据库中找出语义最相近的文档片段;生成阶段则把这些检索到的片段作为上下文,连同原始问题一起喂给大语言模型,由模型综合理解后生成最终答案。这种"先检索、再生成"的架构有效解决了大模型的两个核心局限:一是训练数据截止日期导致的知识陈旧问题,二是模型对企业私有数据天然无知的问题。相比直接把全量文档塞入模型上下文(受限于Token窗口),RAG只取最相关的片段,既节省成本又能聚焦作答,是目前企业知识管理场景中最主流的落地方案。
项目的技术架构与核心功能
这套知识库系统采用前后端分离架构:前端使用Vue 3,后端基于Spring AI框架接入大模型完成核心逻辑。整体技术选型贴近企业实际落地场景,而非停留在Demo层面。
两大核心功能贯穿始终:AI的RAG问答与知识库资料上传。要实现问答,前提是先上传业务资料。资料会被上传到OSS对象存储服务,随后进入分词、向量化处理流程,最终落地到向量数据库中。
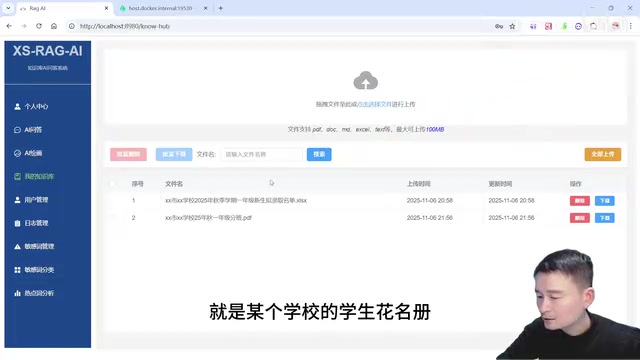
在向量数据库的选型上,教程选择了Milvus。无论从性能表现还是市场占有率来看,Milvus在当前向量数据库领域都处于领先位置,适合作为企业级生产环境的选择。这种从存储到检索的完整链路,构成了RAG应用最基础也最关键的骨架。
向量数据库与传统数据库的根本区别在于存储与检索的维度不同。传统数据库以行列结构存储结构化数据,检索依赖精确索引;向量数据库存储的是高维浮点数数组(即"向量"或"Embedding"),检索时通过计算余弦相似度、点积等度量方式找出语义上最接近的向量。Milvus 是目前开源向量数据库中性能最具代表性的选手,支持十亿级向量的毫秒级检索,并提供多种索引类型(如 HNSW、IVF_FLAT)以平衡召回率与速度。Spring AI 框架则对主流向量数据库做了统一抽象,开发者无需手写底层检索逻辑,通过配置即可切换不同的向量存储后端,大幅降低了工程接入门槛。
企业级开发的难点与解决思路
很多人会觉得RAG问答"有手就行",但真正进入企业级开发,一系列工程化难题才会浮现出来。教程不止于接入大模型做相似性检索,更深入拆解了几个关键问题。
分块策略是第一道门槛——文档切分得过大或过小都会影响检索效果,究竟采用哪种分块方式更合理,需要结合业务数据实测。接下来是跨向量检索问题,当一个答案分散在多个文档片段中时,如何保证完整召回。资料的时效性同样重要,当原始资料过期后如何及时更新向量库,避免AI返回陈旧信息。
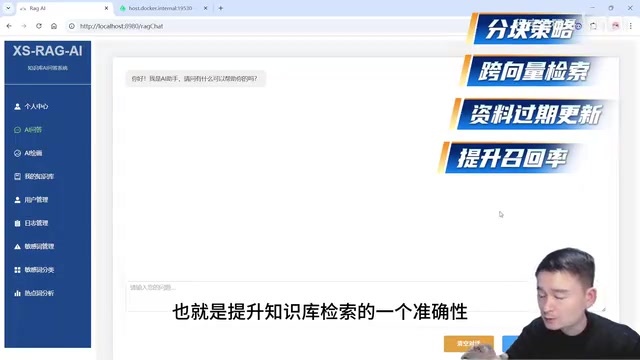
召回率的提升直接决定了知识库检索的准确性,这是衡量系统好坏的核心指标。而针对AI"幻觉"问题——即没有查到信息时胡编乱造——教程也给出了应对方案。此外,来源追溯(让用户知道答案出自哪份资料)与资料访问控制与安全(针对不同用户设置文档访问权限)这两个企业最关心的合规性功能,也都被纳入实战范围。
分块策略(Chunking)是RAG系统中最容易被低估的环节。常见的分块方式包括:按固定字符数切分(简单但割裂语义)、按句子/段落边界切分(保留语义完整性)、以及带重叠窗口的滑动切分(chunk之间保留一定重复内容,避免关键信息恰好落在边界被切断)。分块过大会导致检索到的片段噪声过多,影响模型聚焦;分块过小则可能让单个片段缺乏足够上下文,模型无法作出完整回答。召回率(Recall)衡量的是"真正相关的文档片段中有多少被成功检索到",提升召回率的常见手段包括混合检索(向量检索+关键词检索结合)、查询改写(对用户问题做多角度扩展后分别检索)以及重排序(Rerank,用更精准的模型对初步召回结果二次打分排序)。
辅助功能与完整学习路径
除了核心的RAG能力,项目还配套了一系列辅助功能,让它更接近一个可交付的完整产品:通过提示词进行文生图、基础的用户管理、日志管理、敏感词管理与分类,以及热点词分析等。这些模块虽然不是RAG的主角,却是企业系统上线时不可或缺的配套能力。
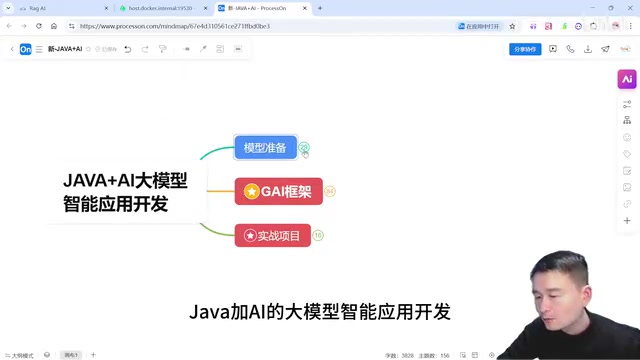
如果想系统性地掌握Java + AI大模型应用开发,教程给出了一条相对完整的学习路径:从大模型的选型,到数据清洗与微调,再到各类大模型接入框架。其中需要理解的核心概念包括对话记忆、对话拦截、Tools / Function Calling、MCP、RAG、向量与向量化、向量数据库等。
在框架层面,建议掌握Spring AI、阿里巴巴的Agent Framework与Graph,以及AI应用的监控平台。最后结合几个实战项目完成高可用部署,把从开发到上线的整个AI应用闭环完整走一遍。对Java程序员来说,这条路径既补齐了AI能力短板,也能切实转化为简历上的竞争力。
小结
这套RAG知识库教程的价值,不在于演示一个能跑的Demo,而在于把企业级落地中真正会遇到的坑——分块策略、跨向量检索、召回率优化、幻觉抑制、来源追溯、访问控制——逐一拆开讲透。对于想从传统Java开发转向AI应用方向的开发者,它提供了一条可操作的进阶路线。
相关推荐
从码农到架构师:AI无代码构建SaaS应用的角色变革
AI已能无代码构建完整SaaS应用,开发者角色正从编码者转向架构师。本文解析这场变革的核心:系统设计、产品逻辑与业务理解才是AI时代的真正价值所在。
60秒用AI构建完整应用:一句话生成加密货币追踪器
一位 YouTube 创作者演示如何用 AI 在约 60 秒内、仅凭一句自然语言描述构建出可运行的加密货币价格追踪应用。本文解析其两步流程、价值与原型到成品之间的真实差距。

用Laravel+Vue.js打造AI个性化冷邮件系统:第6集进展速览
AI个性化冷邮件系统第6集进展:项目已上线测试,打通Google邮件收发,引入email reply parser解析回复,并集成Sentry错误追踪。基于Laravel、Vue.js与Inertia.js技术栈的全栈开发实践。