Ramp如何用AI Agent重构GTM编排系统:从意图到执行的自动化实践
在AI Engineer大会上,Ramp负责产品与销售驱动增长工程团队的Arman分享了他们如何从零构建「Go-to-Market(GTM)编排」系统的完整实践。这不是一个概念演讲,而是一套已经在生产环境运行、支撑Ramp整个销售增长引擎的真实架构。本文将拆解其背后的构建模块,以及一家公司如何将「描述意图即可自动执行」的愿景变为现实。
什么是GTM编排:从意图到执行的自动化
Arman开门见山地定义了「GTM编排」:团队希望能够仅通过描述意图——无论是playbook、实验还是常青营销活动——就让这些动作自动分发到各个执行渠道(外呼、广告、官网、应用内通知等)。
Go-to-Market(GTM)编排是近年来B2B SaaS领域兴起的一种系统化方法论。传统GTM流程中,市场营销、销售开发(SDR)、客户成功等团队各自使用独立工具——如Salesforce管理CRM、Outreach管理外呼序列、Google Ads投放广告——这些工具之间数据割裂,协调靠人工。根据Gartner统计,一个中等规模的B2B企业平均使用超过90种营销技术工具,数据在这些工具间的流转损耗和不一致性已成为增长瓶颈。GTM编排的核心理念是将这些分散的执行渠道统一到一个智能调度层下,通过数据驱动和自动化实现跨渠道的一致性操作。Ramp作为一家企业支出管理平台(提供企业信用卡、费用管理、采购等服务),其潜在客户几乎覆盖所有美国企业——几乎所有有员工需要报销、出差或采购的企业都是潜在客户——这使得传统的"手动筛选→人工触达"模式完全无法应对其市场规模,自动化GTM编排从"锦上添花"变为"生存必需"。
他用了一个非常具体的例子来贯穿全场:假设Ramp想给「东海岸建筑公司里打高尔夫的人」提供一个激励,比如送几盒Pro-V1高尔夫球,吸引他们试用Ramp或与销售对话。理想状态下,运营者只需描述这个意图,系统就能自动完成:
- 构建这批目标受众的画像
- 生成激励方案
- 创建外呼序列并撰写文案
- 为付费广告和官网生成创意素材
- 向现有客户推送应用内通知
这一切都通过「描述意图」无缝完成。而值得一提的是,Arman透露给高尔夫爱好者送Pro-V1的实验「实际效果非常好」。
三大根本挑战
几年前团队识别出这套系统面临的核心痛点:
- 数据混乱且不一致:各系统的数据分散,每个团队基于不同的「事实来源」运作,导致跨团队、跨渠道的协调行动几乎不可能实现。
- 销售代表被杂活淹没:即便有再好的活动创意,销售团队整天都在背靠背开会、外呼、成交,中间的运营负担极高,让规模化实验和创意变得困难。
- 协调与分发成本高昂:写一份方案、制作赋能材料、说服一群人去采用某套策略,往往需要以「月」为单位的时间才能推进。
构建模块一:统一的客户数据平台(CDP)
Arman坦言,解决方案的起点看起来「就像一个CDP」——因为它确实是。Ramp在内部构建了自己的客户数据平台,整合了CRM数据、产品数据、增强数据、网页数据和购买信号。
CDP(Customer Data Platform)是一种将来自多个来源的客户数据统一为持久化、可寻址的客户档案的系统。Ramp选择自建CDP而非采用Segment、mParticle等第三方方案,核心原因在于其数据模型的复杂性——需要将CRM交易数据、产品使用遥测、第三方增强数据(如Clearbit公司信息、PitchBook融资数据)和行为数据(网页浏览、邮件交互)关联到同一个账户实体上。
这些信号既包括内部建模的判断(例如「该客户对采购或资金管理模块有高附着倾向」),也包括外部信号(如融资公告),以及交互数据(邮件、会议、通话、页面浏览)。
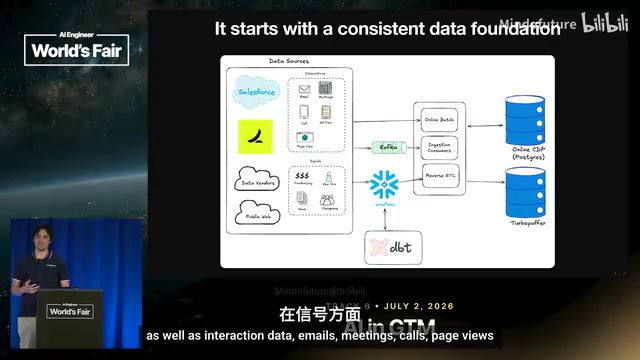
技术架构上,这套系统包含几个关键层:
- 实时事件流:邮件等实时事件通过Kafka topic消费后回流。Kafka是Apache基金会的分布式事件流平台,以其高吞吐量、低延迟和强持久性著称,能够处理每秒数百万条消息,是实时数据管道的行业标准选择。Ramp的架构还体现了事件溯源(Event Sourcing)的设计理念——每一个业务动作(客户打开邮件、浏览定价页、提交表单)都被记录为不可变事件,这不仅支持实时响应,还允许团队回溯历史状态、重建任意时间点的客户画像。这种架构在需要多团队共享同一事件流时尤为重要,因为每个消费者可以独立读取、按自己的节奏处理,而不会影响其他消费者。
- Postgres事务层:维护实体间的事务保证和引用完整性,将CRM、产品、第三方数据归因到正确的粒度层级,并保留完整元数据(数据来源、进入时间等)。Postgres的ACID事务特性确保了在多数据源汇聚时不会出现数据不一致的问题。
- 非结构化数据嵌入:销售数据大量是非结构化的——通话记录、邮件、笔记。将这些内容通过embedding模型(如OpenAI的text-embedding-3或开源的BGE系列)转化为高维向量表示并存入向量数据库,支持语义级别的检索,价值极高。本质上,这是在构建一个语义层面的"企业记忆"——传统CRM系统只能存储结构化字段(交易金额、阶段、日期),但销售过程中真正的决策信号往往隐藏在非结构化交互中,比如客户在通话中提到"我们正在评估竞品"或"下季度预算会增加"。通过embedding编码,这些语义信息变得可被AI Agent检索和利用。
- 离线批处理:通过DBT(Data Build Tool,一种SQL优先的数据转换工具)配合Snowflake云数仓将数据拉入数仓做离线计算,再通过反向ETL(Reverse ETL,将数仓分析结果回写到操作系统的过程)回流到同一层,使分析洞察能直接驱动业务动作。
由于Ramp的可触达市场几乎覆盖整个美国并正在向国际扩展,提前预计算、预处理所有增强数据变得至关重要。
构建模块二:先为一个团队解决,再横向扩展
Arman强调他们的方法论核心是:先解决一个团队的问题,再横向复制。因为不同团队存在大量重叠需求——所有人都要自动化外呼、都要准备会议——同时也有各自独立的需求(如QBR生成)。QBR(Quarterly Business Review,季度业务回顾)是B2B SaaS行业中客户成功团队与客户定期进行的正式会议,回顾过去一个季度的产品使用情况、ROI成果和下一步计划,其准备工作通常需要大量数据汇总和幻灯片制作。
他以已上线的**会前简报(pre-meeting briefs)**为例。这是为AM(客户经理,Account Manager,负责维护和拓展现有客户关系的角色)设计的功能。AM整天在背靠背的会议中,需要快速掌握:会议主题、参会人是谁、产品使用情况、账户健康度、议程,以及客户端的诉求(是否有未处理工单、是否邮件提到特定话题)。
一个「隐蔽的难题」
技术上,生成会前简报的第一步是接入日历会议事件,然后做数据水合(hydration),把参会人邮箱、会议标题映射回对应的账户。数据水合是指将一个简单的标识符(如邮箱地址)扩展为完整的、关联了所有相关信息的丰富数据对象的过程——类似于给一个骨架填充血肉。Arman指出这在Ramp是个「隐蔽的难题」——同一个邮箱可能代表多家企业(例如一个财务顾问同时服务多个客户公司),因此需要做模糊匹配。一旦匹配完成就持久化保存,让下游所有消费者无需从头重算。
持久化执行与人在环路
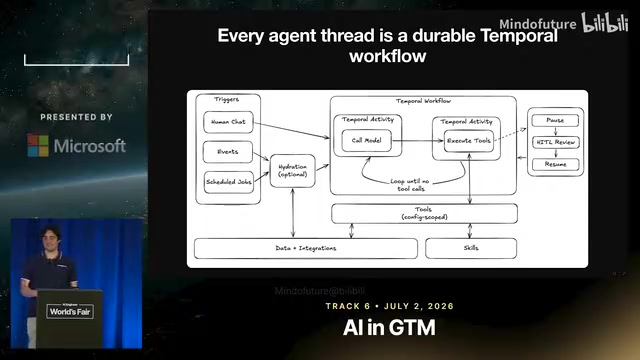
系统还构建了基于Temporal的持久化执行机制,与触发器无关。Temporal是一个开源的持久化工作流引擎(原名Cadence,由Uber开发),专门解决分布式系统中长时间运行工作流的可靠性问题。在传统架构中,如果一个多步骤的自动化任务(如:查询客户数据→调用LLM生成文案→发送邮件→更新CRM)在中间某步失败,整个流程通常需要从头重跑或依赖复杂的状态管理逻辑。Temporal通过将每个步骤封装为Activity、将整体流程定义为Workflow,自动持久化每个步骤的执行状态。
在GTM编排中,Temporal解决的核心工程难题是AI Agent工作流的可靠性。在生产环境中,一个典型的GTM自动化流程可能涉及十几个API调用(查询CRM、调用LLM、发送邮件、更新数据库),任何一个环节都可能因网络超时、限流或服务不可用而失败。Temporal的"事件溯源"内核确保了即使整个服务器宕机重启,工作流也能从最后一个已完成的步骤恢复,这种确定性执行(deterministic execution)对于涉及客户沟通的场景至关重要——你绝不希望因为系统恢复而给同一个客户发两封相同的邮件。
每个工具调用和模型调用都被表示为一个activity,构成durable thread。如果某个worker意外退出,可以从中断处恢复执行,携带此前累积的状态,而非从头重新处理整个线程——这对效率至关重要,因为每次LLM调用都有延迟和成本,避免不必要的重复调用既节省费用也提升用户体验。
此外还内置了配置化的工具调用作用域(不同agent拥有不同工具集)和**人在环路(Human-in-the-Loop)**能力(暂停执行、获取人工输入、再恢复)。人在环路是AI系统设计中的一个重要模式,指在自动化流程的关键决策节点引入人工审核和确认,确保AI的输出符合业务规则和质量标准,这在涉及客户沟通、合规要求的GTM场景中尤为重要。
构建模块三:非结构化数据与技能库
Arman认为非结构化信息「可能是你数仓里最有价值的东西」。系统实时接入会议记录、邮件,同时批量处理赋能材料、产品知识、playbook,进行分块、嵌入后存入TurboPuffer。
TurboPuffer是一种专为大规模向量检索优化的向量数据库。整个流程是检索增强生成(RAG,Retrieval-Augmented Generation)架构的核心实现。RAG的基本思路是:不把所有相关文档塞进LLM的上下文窗口(这既受到token数量限制,又造成高昂的推理成本),而是先通过向量相似度搜索找到最相关的文档片段,再将这些片段注入prompt供模型参考。
Agent可以结合向量搜索(捕捉语义相似性)、属性搜索(如按账户ID、日期范围筛选)、关键词搜索(精确匹配专有名词),检索与特定账户相关的信息,而无需把整个原始语料塞进上下文——这既低效又昂贵。这种三管齐下的混合检索策略(hybrid search)能显著提升检索的准确率和召回率。纯向量搜索在处理专有名词(如产品名称"Ramp Plus"、客户公司名)时容易出现语义漂移,而纯关键词搜索(如BM25算法)则无法理解同义表达。属性搜索(metadata filtering)则在此基础上加入了业务逻辑约束——例如只检索某个特定账户过去90天内的交互记录,避免AI Agent被无关信息干扰。这种分层过滤策略能将检索准确率提升30-50%,同时大幅减少送入LLM的token数量,降低推理成本。
他们还构建了技能库(skill library),让用户自定义agent的行为方式。技能库的概念借鉴了游戏AI和机器人学中的分层任务规划思想——将复杂任务分解为可组合、可复用的原子技能单元,每个技能封装了特定的工具调用序列、prompt模板和输出格式要求。回到会前简报的例子:不同人关心不同的格式和信息维度,允许他们用文本描述需求交给agent,这对提升工具采用率非常关键。
最终这些模块组合成运营型后台agent:每晚扇出(fan out)一批agent,为每个账户逐一计算会议准备。「扇出」是分布式计算中的经典模式,指将一个任务拆分为多个并行子任务同时执行,极大提升吞吐量。这些agent可访问在线CDP、Postgres、向量数据库、系统级会议准备技能,以及用户自定义指令。
构建模块四:横向Federation与GTM MCP
这套基础设施的目标是让下一件事更快完成。会议既然重要,就可以延伸出会后跟进、自动CRM更新——从通话记录中提取「我们讨论了某个扩展机会」,预填创建商机所需信息,让销售一键确认即可完成。
横向扩展到其他团队,主要是创建特定技能、数据集成和数据摄入的工作。例如为处理售前商机的AE(Account Executive,客户主管,负责推进和关闭销售交易的角色)构建时,需要更侧重第三方数据(如公司规模、行业、技术栈信息),而非已有的产品使用数据。
更妙的是,Ramp把这些工具和技能通过所谓的GTM MCP开放给员工。MCP(Model Context Protocol)是Anthropic于2024年底推出的开放协议,旨在标准化AI模型与外部工具、数据源之间的连接方式。它类似于AI世界的USB-C接口——定义了一套统一的规范,让任何兼容MCP的AI客户端(如Claude Desktop、Cursor等)都能连接到任何兼容MCP的服务端。具体而言,MCP协议定义了工具描述(Tool)、资源访问(Resource)和提示模板(Prompt)三种核心原语,使得AI模型能够理解每个工具的用途、输入输出格式和调用约束。Ramp将其内部GTM工具体系封装为MCP服务,让员工能像后台agent一样访问同一套工具、与数据对话、构建自己的自动化流程,而无需学习内部系统的API。这意味着Ramp的员工无论使用Claude Desktop、内部Chatbot还是Cursor编写自动化脚本,都能无缝访问同一套GTM数据和能力,极大降低了AI应用的开发门槛。
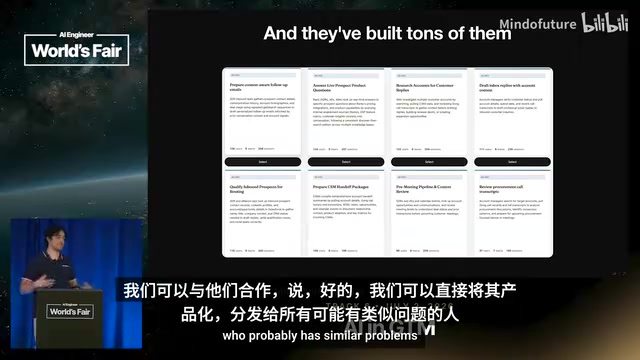
这形成了强大的复利效应:当员工连接MCP构建自己的方案时,本质上是在告诉团队「我有这样一个问题,我这样解决」。团队随即可以将其产品化,分发给所有面临类似问题的人。员工提供的prompt、技能,甚至vibe coding(一种通过自然语言描述需求让AI生成代码的开发方式)的成果,都大幅简化了用例的产品化过程。
回到高尔夫:编排的终局
讲了这么多具体构建,Arman揭示了它们的意义:这些垂直构建正是多团队、多渠道分发的基础。
当想执行「给高尔夫爱好者送Pro-V1」这样的实验时,系统会将意图汇入Ramp内部应用「Ramp Revenue」,再分发到各垂直解决方案:为SDR(Sales Development Representative,销售开发代表,负责初始的潜在客户触达和筛选)生成目标高尔夫受众、生成个性化文案和序列、创建官网落地页并生成配图创意——全部通过描述意图完成,再由各渠道负责人审核签字。
这带来的价值是:更快上线、更安全上线、扩展团队、提升效率。多渠道campaign可以保持一致的受众定位,agent能同时持有多个选项的上下文,平衡经典的多臂老虎机问题(Multi-Armed Bandit)——在探索新可能与利用已知回报之间取舍。多臂老虎机是强化学习中的经典问题框架,在GTM场景中体现为:当系统同时运行多个营销实验(不同的受众定位、不同的文案、不同的激励方案)时,需要智能地分配流量和资源——既不能过度集中在历史表现最好的方案上(可能错过更优的新方案),也不能无限制地探索(浪费资源在低效实验上)。经典的解法包括ε-greedy、UCB(Upper Confidence Bound)和Thompson Sampling等算法。在B2B GTM的实际应用中,还需要处理一个额外的复杂性——"延迟反馈":不像网页A/B测试可以在几秒内观察到点击结果,B2B销售的转化周期可能长达数周甚至数月,系统在做探索-利用权衡时必须处理大量"尚未观察到结果"的样本。Contextual Bandit(上下文老虎机)方法在这里特别适用,因为它能将客户属性(行业、规模、购买阶段)作为上下文特征纳入决策,而不是简单地比较不同实验的平均转化率。同时系统内置护栏来管理合规规则、交战规则(如避免同一客户在短时间内被多个渠道重复触达),避免重复动作。
给小公司的建议:先解决具体问题
面对「小公司或初创团队该如何构建类似系统」的提问,Arman给出了务实的答案:找到非常具体的用例,先解决真实存在的具体问题。
他回忆三年前团队只有两个人,用GPT-3.5往序列里塞个性化文案,从各处拉数据生成内容。GPT-3.5是OpenAI于2022年底发布的大语言模型,也是ChatGPT初始版本背后的模型,当时的能力虽然远不及今天的GPT-4o或Claude 3.5 Sonnet,但已经足以处理个性化文案生成这类相对简单的NLP任务。正是通过解决这些真实问题,才真正理解了系统如何运作、如何扩展到其他团队。
「现实是你不可能花一年时间去构建一套完美的系统架构,」Arman总结道,「你必须先拼出垂直解决方案,然后再把它们拼接起来。」这正是Ramp从零构建GTM编排的核心方法论——自下而上,垂直优先,横向复利。
核心要点
相关推荐
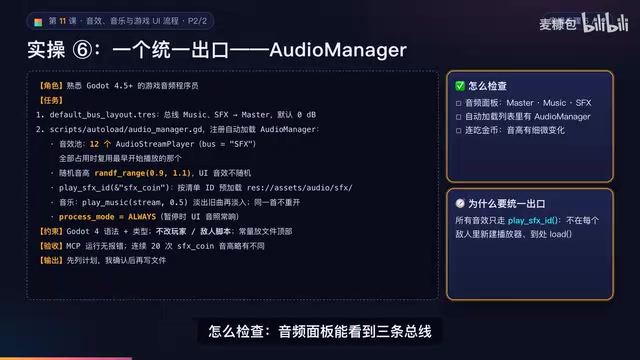
AI游戏开发实战:音频总线与全流程UI搭建
AI游戏开发实战第11课下篇:讲解Godot音频三件套、音频总线与音量分贝转换、AudioManager音效池与随机音高、自动加载节点边界、从标题到通关的完整UI流程、JSON存档容错设计,以及像素字体抗锯齿关闭与整数倍字号规则。
AI游戏开发验收课:用GUT测试与Agent自检让Bug无处可藏
AI游戏开发实战第十二课聚焦测试与验收:用GUT自动化测试、Agent自检循环、浏览器冒烟验收和外部试玩四层金字塔,让AI的每一项完成都有可观测证据。核心原则是退出码判据、证据必须为原文、禁止Agent改断言让测试变绿。

DoorDash披露:AI智能体下单仅数百单,开放合作成关键
DoorDash 披露其平台仅收到数百单来自 AI 智能体的订单,并表示愿意与第三方智能体开发者合作。本文分析智能体电商的早期现状、平台开放策略以及交易信任瓶颈。