让AI Agent接管网络前,先设好这3道安全护栏

实验揭示AI Agent框架默认状态下会不经审批直接改动路由器配置,并给出三道关键护栏
本文记录了一位网络工程师用开源Agent框架Goose和Bionic对真实路由器进行的安全实验。核心发现是:Goose默认的auto模式会不经任何确认直接执行写操作;即便切换到「智能审批」模式,判断是否需要审批的权力仍交给AI模型本身,可靠性存疑。文章围绕Agent循环中那道决定工具调用是否真正执行的「门」,提出三道护栏:一是确保MCP工具返回完整实时信息;二是利用MCP的readOnlyHint与destructiveHint标签机制,叠加自定义权限规则(优先级为自定义规则>工具标签>模型猜测);三是在部署前充分了解所用框架的审批边界——Bionic在测试版本中对MCP写工具完全没有拦截,会损失一层关键护栏。此外,文章特别警示MCP标签可被伪造,务必审查每个安装的MCP服务器。
AI Agent正在从「聊天助手」演进为能够直接操作生产环境的执行者。当一个AI代理框架(harness)获得了对真实网络设备的写入权限时,它究竟在什么时候会停下来征求你的同意、什么时候又会直接改掉路由器配置?这是每一位想把AI引入运维环境的网络工程师必须搞清楚的问题。
一位专注于「AI增强型工程师」的YouTube创作者,用本地运行的开源Agent框架 Goose 和 LM Studio 的新框架 Bionic,针对一台真实路由器做了一组实验,揭示了这类工具默认状态下的真实风险,并给出了三道值得优先部署的护栏。
Agent Harness 和聊天机器人的本质区别
普通的本地大模型只是「聊天」——你问它网络配置问题,它给你答案,仅此而已。而 Agent harness 完全不同:它把模型放进一个循环里运行,循环挑选工具、框架执行工具、结果返回后再次进入循环,如此往复直到任务完成。
关键就在这个循环里:一定存在一道「门」(gate),决定某次工具调用是否真的被执行。这道门,正是整段实验的核心。
实验中作者指出一个容易被忽视的危险默认值:Goose 全新安装后的模式是 auto,意味着每一次工具调用都会直接运行,不会有任何提示。换句话说,开箱即用的 Goose 会在不征求批准的情况下改动你的网络配置。即便切换到 smart approve 智能审批模式,是否弹出批准提示,最终竟然是交给背后的 AI 模型来判断的——这在生产环境中显然并不理想。
MCP(Model Context Protocol) 是 Anthropic 于2024年提出并开源的标准协议,旨在统一大语言模型与外部工具、数据源之间的通信方式。在此之前,每个 Agent 框架都有自己的工具调用接口,互不兼容。MCP 将工具定义、工具发现和工具调用标准化为一套 JSON-RPC 风格的协议,使同一个工具服务器(MCP Server)可以被 Claude、Goose、Bionic 等不同框架直接复用。文中提到的 readOnlyHint 和 destructiveHint 标签,就是 MCP 规范里内置的元数据字段,用于向 Agent 框架传达该工具的副作用程度。理解这一背景有助于明白为何标签的可信度问题是系统性的——任何遵循 MCP 协议的框架都面临同样的信任边界问题,而不只是 Goose 的特有缺陷。
护栏一:让 MCP 工具的输出保持完整
第一道护栏取决于你自己:必须保证 MCP 工具返回给模型的信息是完整的。
作者分享了一个真实教训。他曾使用一个带缓存的网络配置工具向 harness 传递数据,但这个工具返回的数据没有加时间戳。结果框架默认它是当前的实时数据,做出了错误判断。他不得不回头修改工具,让它真正拉取实时配置数据,模型这才正确理解了状况。
这个细节提醒我们,Agent 的判断质量高度依赖输入质量。如果工具给 LLM 的信息是过时的、残缺的,再聪明的审批逻辑也会建立在错误的事实基础上。构建工具时务必确保它把 harness 所需的全部信息都返回给模型。
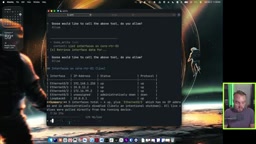
实验中,作者把三个只读工具(ping host、list interfaces、show interfaces)逐一在 Goose 的「工具权限」里设为 always allow(始终允许),而把写入工具单独保留。这样做的另一个意义在于解决「审批疲劳」——一次简单的只读操作竟触发了三次独立批准请求(其中内置的 to-do 工具还被调用了两次),正是这种频繁打断,逼得很多人干脆切回 auto 或 bypass 模式,彻底放弃了防护。
护栏二:给工具贴标签,再叠加自己的权限规则
第二道护栏是 MCP 协议提供的工具标签机制。每个工具可以设置一个 readOnlyHint(只读提示),用 true 或 false 标明它是读还是写;此外还有一个更精细的 destructiveHint(破坏性提示),用来标记「这个写操作是否具有破坏性」。
作者举例说明:给接口改一个端口描述属于写操作,但不会造成中断,因此 destructiveHint 可以设为 false;而真正可能引发故障的写入则应标记为破坏性。这给了你相当大的配置弹性——不只是「读还是写」,还能区分「写得危不危险」。
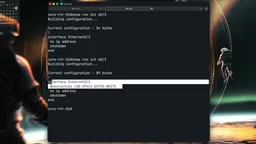
更重要的是作者从 Goose 源码中梳理出的这道门的真实判定顺序:
- 你自己设置的规则永远优先,每次都生效;
- 工具自身的标签——如果工具声明自己只读,Goose 就相信它,永远不会去问模型;
- 如果既没有规则也没有标签,本地模型才用「尽力而为」的方式去猜。
所以标签就是那道门。但这里埋着一个巨大的安全陷阱:MCP 规范要求,除非服务器可信,否则应把这些标签视为不可信。而 Goose 对你手动添加的服务器默认是信任的。作者做了一个尖锐的测试——他故意在自己的写入工具上撒谎,把一个写工具标成只读,结果 Goose 果然不加询问就直接执行了。它完全照着标签说的做。
这意味着一条铁律:务必阅读你安装的每一个 MCP 服务器。它们完全可能在你没准备好的情况下执行各种写操作。对于无法查看源码的厂商提供的 MCP 服务器,作者给出的变通方案是:把它丢给某个 AI,让其分析「这个 MCP 服务器会做哪些写操作」,再据此调整权限。
两层保护由此成形:MCP 工具层面的 hint 配置 + Agent harness 层面的规则。作者的 Goose 规则集最终是:三个只读工具 always allow,写入的 set interface 设为 ask-before-running,shell 则 never allow——绝不让它自己跑 shell 命令。
这里涉及的安全模型本质上是一个供应链信任问题。MCP 服务器可以由任何第三方发布,其标签声明在协议层面没有强制验证机制——类似于 npm 包的 package.json 中可以随意填写任何描述字段。MCP 规范文档本身也明确指出,客户端不应无条件信任来自未知服务器的 hints,应由用户或管理员显式授权。然而在实际部署中,Goose 等框架对用户手动添加的服务器默认给予完全信任,这等于把安全判断的责任完全转移给了用户。这与软件供应链攻击的逻辑如出一辙:攻击者只需发布一个声称「只读」的恶意 MCP 服务器,诱导用户安装,即可在零提示的情况下执行任意写操作。因此,「务必阅读你安装的每一个 MCP 服务器」不是建议,而是当前协议生态下唯一可靠的防线。
护栏三:不要在不会停下来问你的框架里放写工具
第三道护栏关乎对框架本身能力的清醒认知。作者接着测试了 LM Studio 的新框架 Bionic,结果暴露出一个严重问题。
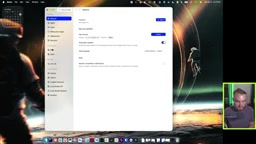
在 Bionic 中注册 MCP 服务器、填入启动命令后,即便把权限菜单设为「每次都问」(ask every time),它也只对 shell 命令生效。当作者让它执行 ls -la 时,Bionic 确实弹出了确认;但当他让它修改核心路由器的接口描述时,写工具却在三个不同会话中都直接运行、毫无审批提示。
原因在于:在作者测试的 1.1.6 版本中,Bionic 还没有像 Goose 那样针对 MCP 的规则,它的审批菜单只覆盖 shell 命令,而不把 MCP 工具调用当作 shell 命令看待。结论很直接:Bionic 能用、也挺好玩,但用它你会实实在在损失一层护栏——你唯一的门只剩 MCP 工具自身的配置。
Bionic 暴露的问题反映了一个更普遍的框架评估维度:审批粒度(approval granularity)。早期许多 Agent 框架将「工具调用」与「shell 执行」视为两类截然不同的操作——前者被认为是受控的函数调用,后者才是危险的任意代码执行。这种区分在工具行为完全可预测的沙箱环境中有一定合理性,但在工具可以连接真实网络设备的场景下就完全失效了。判断一个框架是否适合生产运维环境,需要明确追问:它的审批机制是否覆盖所有 MCP 工具调用(而不只是 shell)?是否支持按工具名称或标签设定不同的审批策略?审批历史是否可审计?这三个问题没有肯定答案的框架,在触碰生产环境之前应被视为不具备足够的安全控制能力。
三道护栏的核心启示
把实验结论收拢起来,有三点值得每个要把 AI Agent 引入网络环境的人记住:
第一,Agent harness 里的那道门是通用的,它根本不知道「路由器」是什么。 Goose 先查你的权限规则,再看工具的只读标签,两者都没有答案时才让 AI 模型去猜。
第二,真正守住防线的护栏,是你自己设的那些。 工具的只读标签会说真话(前提是你没撒谎),而你需要在 Goose 中叠加自己的权限规则。
第三,务必清楚你所用的框架到底允许什么、提供哪些权限设置。 同样一个写工具,放进 Goose 和放进 Bionic,安全边界完全不同。
随着「harness engineering(框架工程)」逐渐成为一个真实存在的实践方向,越来越多人开始自建 Agent 框架。但无论用现成的还是自己搭的,在让 AI 代理触碰你的网络之前,先把这三道护栏设好——这不是可选项,而是底线。
相关推荐

英伟达3万开发者用Cursor,代码提交量增3倍
Cursor现场工程师拆解企业AI编程从试点到规模化之间的五个缺口:战略清晰度、风险分级、治理审计、业务度量与运营战略。英伟达3万开发者每日使用Cursor,代码提交量增至3倍且缺陷率持平,关键在于重写SDLC而非叠加工具。

Ponytail:给AI编码代理装上资深工程师思维
Ponytail 是一个 GitHub 免费工具,为 AI 编码代理注入资深工程师思维,让 AI 先问代码是否必要。据 TamilDeck 介绍,它可将 AI 生成的 200 行代码压缩到 30 行,降低 token 成本,支持 Cursor rules 与 Claude Code skill 接入,但安全审查仍需人工把关。

Cursor AI 接入 GitHub MCP 服务器完整指南
手把手教你将 Cursor AI 接入 GitHub MCP 服务器:创建个人访问令牌、配置 mcp.json、用 ENV 块安全管理 token,并通过查询 PR 验证连接是否生效。